Dify——低代码快速上线POC通用型LLM Agent
引言
Dify是通用型LLM应用低代码开发平台,一站式搭建AI应用,能快速做AI应用上线POC。
产品功能层面,Dify能做聊天助手、文本生成应用、工作流自动化、知识库问答(RAG)、Agent、模型接入与切换、工具/API调用、发布为网页或API。
- 基础对话应用(
Chatbot)——验证基础LLM、对话记忆; RAG知识库问答(测试检索、切片、引用溯源);Workflow工作流(拖拽编排,条件分支+代码节点);Agent智能体(工具调用,ReAct模式);Chatflow对话流(业务分类路由,适合客服场景)。
技术功能层面,Dify = 提示词IDE + RAG知识库 + 可视化工作流 + Agent框架 + 模型网关 + LLMOps运维平台。
- 模型网关:一键接入百种国内外大模型(
GPT、通义千问、Llama、本地私有化模型),统一调用接口、负载均衡、限流熔断; - 一站式
RAG流水线:文档上传→自动分块清洗→向量化入库→混合检索(向量+全文关键词),开箱即用; - 可视化
Workflow工作流:拖拽编排意图识别、工具调用、分支判断、第三方API联动等复杂业务逻辑; Agent框架:通过让大模型自主选择工具、规划步骤并执行任务,构建可扩展的智能应用流程;- 基础
LLMOps内置:简易日志、对话标注、基础Prompt版本管理、团队RBAC权限、一键对外输出API接入业务前端; - 支持
Docker/K8s私有化部署、多租户、审计日志,满足合规要求。
优势:通用性最强、上手门槛适中、生态完善,兼顾小白低代码与开发者二次开发;国际化友好,多语言场景适配优秀;
短板:RAG是通用方案,针对企业海量专业文档的精细化召回优化弱于FastGPT;复杂深度定制底层架构成本偏高。
Dify做POC的优势如下,
- 快速搭建完
RAG问答/Agent/AI工作流,快速演示;- 不用写后端、不用自己维护向量库、提示词界面可视化;
- 直接对外输出
Web页面+API,演示POC非常方便;- 可随时导出日志,评估效果;
POC验证通过再进入正式开发。
Dify有什么
源码工程结构如下,
1
2
3
4
5
6
7
8
9
10
11
12
dify/
├── api/                  Python / Flask 后端与 AI 核心
├── web/                  Next.js / React 管理台与应用前端
├── dify-agent/           新一代 Agent 的 Python 控制层
├── dify-agent-runtime/   Agent 沙箱运行时,Go 实现
├── docker/               Docker Compose 自部署编排及环境模板
├── cli/                  difyctl 命令行客户端
├── e2e/                  Cucumber + Playwright 端到端测试
├── packages/             前端共享包、UI 库、类型契约和开发工具
├── sdks/                 Node.js、PHP 等客户端 SDK
├── docs/                 多语言文档
└── scripts/              构建、检查、迁移和压力测试脚本
简单说明如下,
web/:Next.js/React管理台、工作流画布、知识库、插件市场、Skills、Agent管理和分享页面;api/:Flask后端、RAG/Workflow/Agent内核、数据库模型、异步任务和各类API;dify-agent/ + dify-agent-runtime/:新Agent的Python控制层和Go沙箱运行时;docker/:完整自部署编排,默认包含API、Web、Worker、Redis、数据库、插件守护进程、Agent后端、SSRF防护,以及可选向量数据库;cli/:difyctl,支持登录、发现应用、读取参数、运行应用和机器可读输出;sdks/:Node.js和PHP客户端;e2e/:Cucumber + Playwright端到端测试。
web/承担平台控制台和最终用户应用页面,
1
2
3
4
5
6
7
app/          Next.js 路由与页面
components/   通用组件及领域组件,如 Workflow、Dataset、Plugin
features/     独立功能模块,如 Agent V2、RAG、Skills
service/      后端 API 请求与数据访问层
hooks/        React hooks
models/       前端领域模型与类型
i18n/         多语言资源
api/是业务核心,分层大致为,
1
2
3
4
5
6
7
controllers/  HTTP 接口:管理台、应用运行、OpenAPI、MCP、文件、触发器
services/     应用、知识库、工作流、Agent、账号、插件等业务编排
core/         Workflow、RAG、Agent、工具、插件、模型、权限等领域实现
models/       SQLAlchemy 数据模型
tasks/        Celery 异步任务,如文档索引、工作流任务
providers/    向量数据库与可观测性追踪的可插拔 Provider
migrations/   数据库迁移
用户提问的完整请求链路如下,
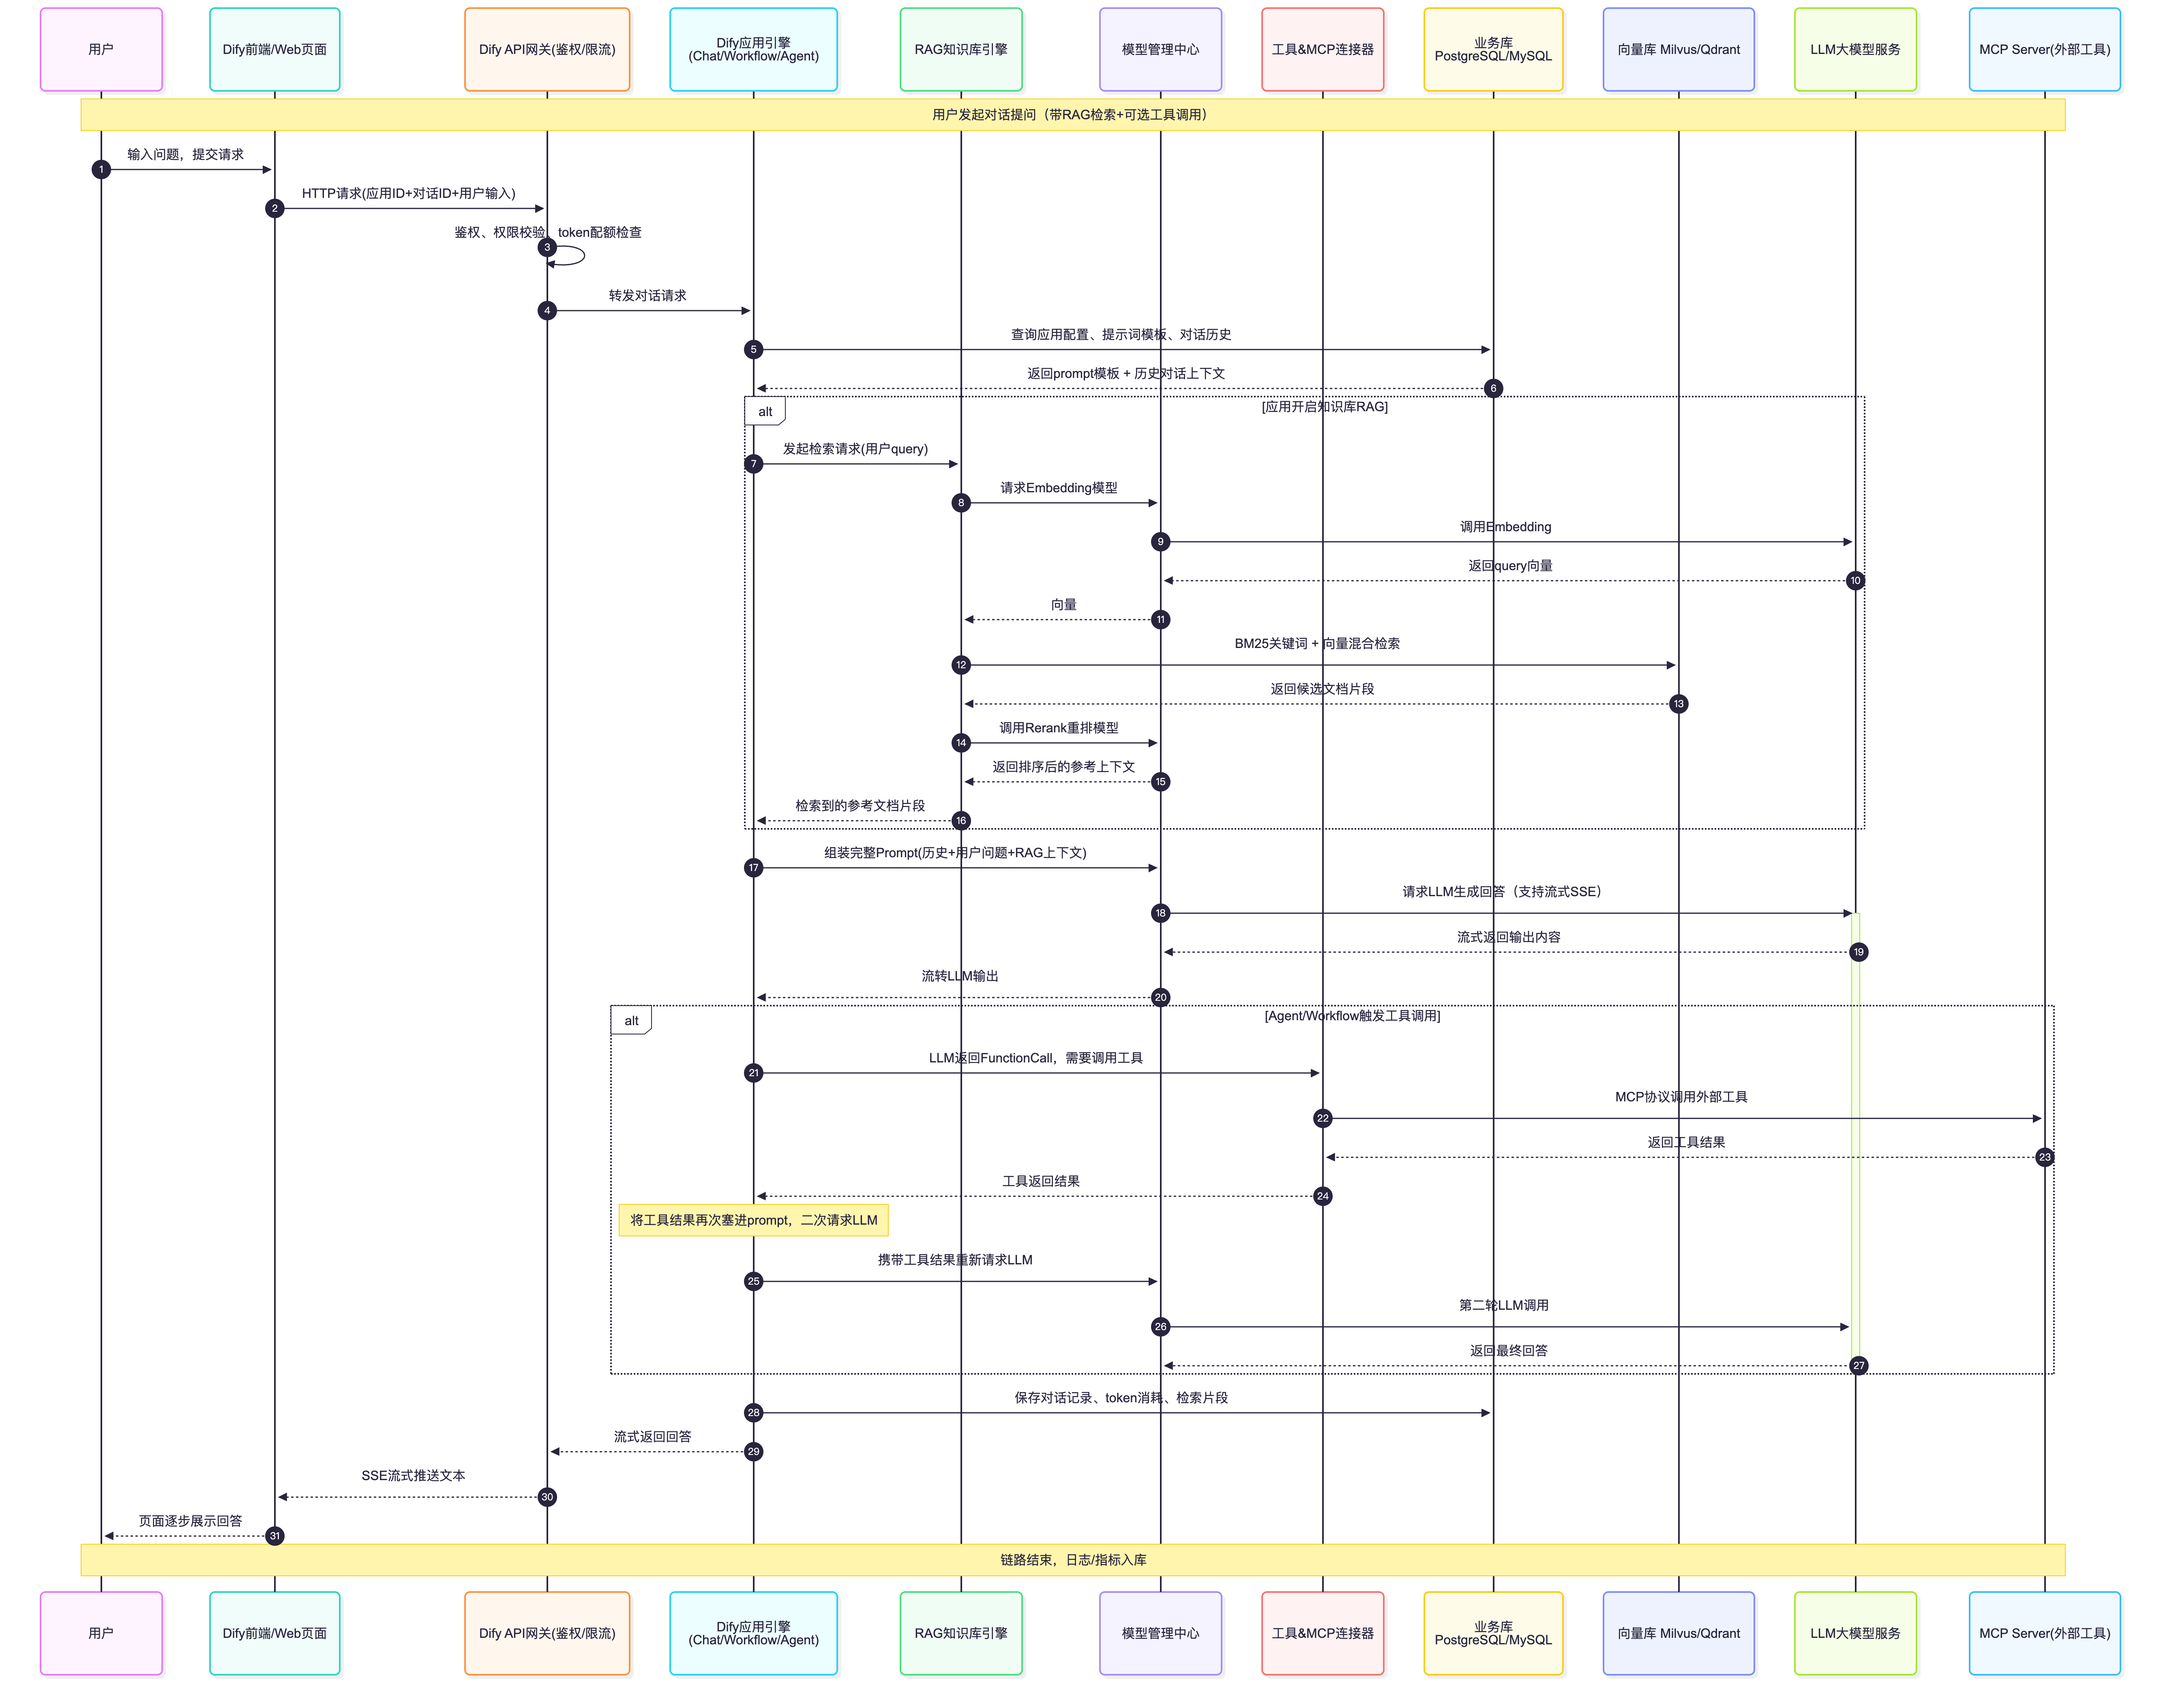 Dify用户提问的完整请求链路
- 鉴权层:
API网关先做身份、应用权限、调用配额校验; - 上下文加载:从
MySQL/PG读取提示词模板、历史对话; RAG分支(可选):Query向量化 → 混合检索 →Rerank重排,拿到参考文档;Prompt组装:把历史对话、用户问题、检索片段合并送入LLM;Agent工具分支(可选):LLM输出工具调用指令 → 通过MCP连接器访问外部服务,拿到结果后多轮循环调用LLM;- 流式
SSE返回:Dify默认流式输出,前端逐字渲染; - 落库:对话、
token消耗、检索片段存入业务数据库,用于日志和评测。
Dify不只是聊天机器人,而是一个用于构建、运营和部署LLM应用的平台。代码分支1.17.1版本的核心能力如下,
- 应用类型:文本生成、聊天、
Chatflow、高级Agent Chat、新Agent、Workflow、Channel、RAG Pipeline,定义见api/models/model.py;- 可视化工作流:
LLM、知识检索、工具调用、代码、HTTP请求、条件分支、循环/迭代、参数提取、问题分类、文档提取、变量处理、人工输入,以及Webhook/定时/插件触发器;RAG知识库:Word、PPT、Excel、CSV、HTML、Markdown、Notion等解析;清洗、分段、Embedding、检索、重排、引用和元数据处理见api/core/rag;Agent:传统Function Calling/ReAct Agent,以及新版独立Agent Runtime。后者通过受限Linux沙箱运行任务,并支持工作目录/Home快照,见dify-agent-runtime/README.md;- 扩展:插件系统可扩展模型、工具、数据源、
Agent、触发器、OAuth和自定义API Endpoint;工具来源包括内置工具、自定义工具、工作流工具、MCP和插件工具;- 模型与向量库:对接模型供应商以及
OpenAI-compatible接口;向量库插件覆盖Qdrant、Milvus、Weaviate、PGVector、Elasticsearch、Chroma、OpenSearch等30多种;追踪可接Langfuse、LangSmith、Opik、MLflow、Phoenix、Weave等;- 运营能力:应用日志、工作流运行轨迹、节点输出检查、用户反馈/标注、统计、版本与草稿发布、
DSL导入导出、工作流协作评论;- 接入与权限:应用
API、OpenAPI、服务API、MCP、Webhook/Trigger API;支持工作区成员与角色、OAuth、SSO配置。部分细粒度RBAC与企业功能受配置或发行版本控制。
Dify内部运行时关系是,web调用api;api使用数据库、Redis和Celery Worker执行异步工作;模型、工具、数据源和向量库通过插件体系扩展;Agent任务可进一步交给dify-agent和Go沙箱运行时执行;如下,
1
2
3
4
5
6
7
Next.js 管理台 / Web App
          |
Flask API + WebSocket
  |       |          |
PostgreSQL/MySQL   Redis    Celery Worker / Beat
  |                              |
文件存储、向量库、模型插件、Plugin Daemon、Sandbox、Agent Backend
Dify全景架构如下,
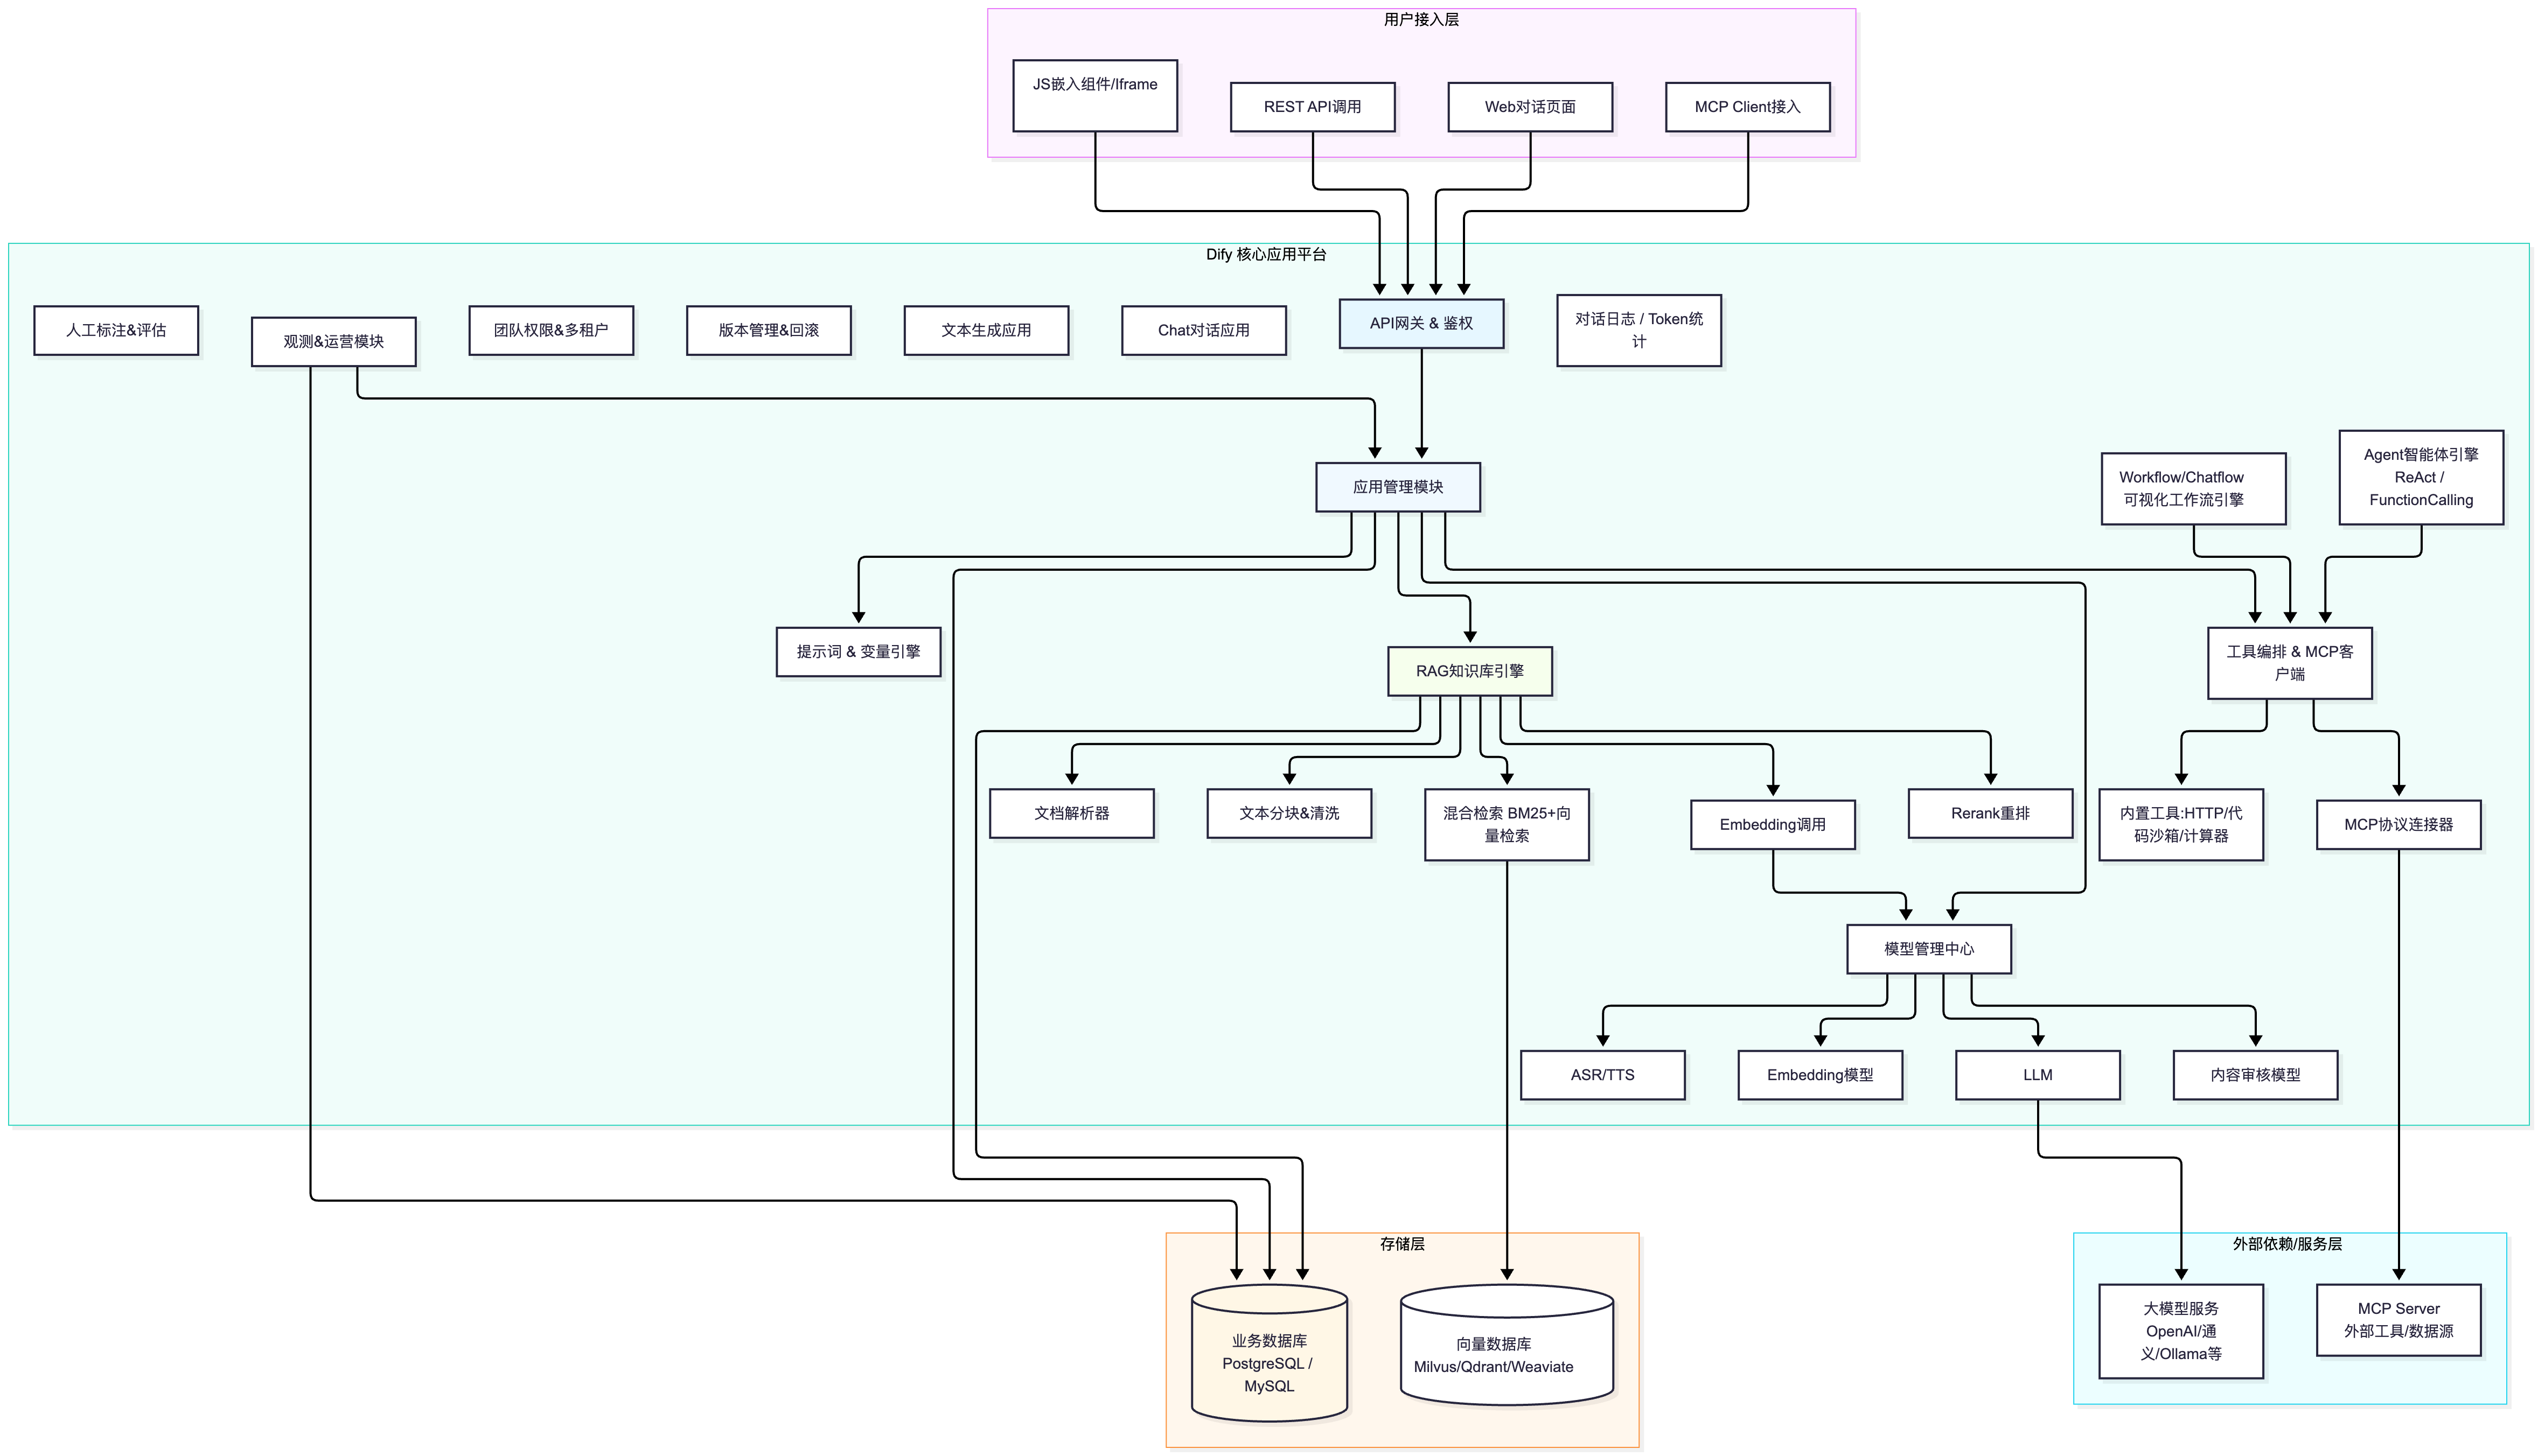 Dify流程架构
- 接入层:多种对外交付方式,
POC演示最常用Web页面 +REST API; - 核心层
Workflow是Dify最强能力,可视化DAG编排;Agent基于ReAct,依赖工具/MCP做自主规划;RAG是完整流水线,开箱即用,不用手写LangChain;- 模型管理统一托管所有
LLM密钥,应用按需选用;
- 存储:
MySQL/PostgreSQL存业务、对话、应用配置;向量库专门存Embedding向量;PostgreSQL:官方默认,生态更成熟,推荐生产;MySQL:适合已有MySQL存量运维体系的团队做POC、私有化部署;
- 外部:对接各类大模型、
MCP服务。
在Dify里可以创建以下几大类应用,
- 对话应用(
Chatbot)- 最常用,多轮聊天机器人;支持开场白、预置问题、对话记忆、文件上传、多模态;
- 场景:企业知识库问答、客服机器人、内部助手;
- 文本生成应用(
Text Generator)- 一次性输入变量,输出结构化文本,无多轮对话。适合文案、摘要、代码生成、报表提取;
Workflow/Chatflow可视化工作流(Dify最强核心)- 拖拽画布编排
DAG节点,固定业务链路,节点包含:开始、LLM调用、知识库检索、条件分支、循环、HTTP请求、代码沙箱、变量提取、人工审批节点、MCP工具调用; - 支持触发方式:用户对话、
Webhook、定时任务;
- 拖拽画布编排
Agent智能体- 模型自主决策,
ReAct/Function Calling,自己判断调用什么工具、执行几步;可以绑定Skills、知识库、MCP工具,也能作为节点嵌入Workflow。
- 模型自主决策,
知识库模块,内置完整RAG流水线,开箱即用,不用自己搭向量库、切片、Embedding,
- 支持文件:
PDF/Word/TXT/Markdown/Excel;网页爬虫、Notion/飞书等云文档同步; - 自动链路:文档解析 → 文本清洗 → 分块(
chunk) →Embedding向量化 → 存入向量库; - 检索策略:关键词
BM25+ 向量混合检索、重排(rerank)、召回阈值设置; - 支持多知识库,一个应用可挂载多个知识库,可做权限隔离。
统一管理所有大模型服务商,模型无关(Model-Agnostic),一套界面切换模型,
- 支持:
OpenAI、Anthropic、Gemini、DeepSeek、通义千问、文心、Ollama本地模型、自定义OpenAI兼容端点; - 可配置
LLM、Embedding、TTS、语音转文字、内容审核模型; - 团队级统一维护
API Key,应用直接选用,不用每个应用单独配置密钥。
工具 & MCP & 插件市场(Marketplace)
- 内置工具:计算器、代码沙箱、
HTTP请求、数据库查询; - 原生支持
MCP协议:接入MCP Server,调用外部工具/数据源(MCP网关场景Dify原生支持); - 自定义工具:自己写
API,封装成工具给Agent/工作流调用; - 插件市场可直接安装现成工具,团队可复用。
发布 & 交付能力(POC上线最关键):建好应用,一键发布,多种交付方式,
Web对话页面:直接生成网页链接,发给客户/内部演示(POC演示首选);API接口:REST API,把AI能力接入自有业务系统;- 嵌入
JS组件:iframe/script嵌入官网、内部系统侧边聊天窗口; MCP服务输出:把Dify应用本身作为MCP工具对外提供。
观测、日志、评估、团队权限
- 对话日志:每一条请求完整记录,输入输出、
token消耗、耗时、检索片段; - 标注/人工反馈:用户对回答点赞/踩,用于评测、微调提示词;
- 应用版本管理:草稿、发布、版本回滚,改提示词/工作流不怕翻车;
- 多租户、团队成员权限:区分管理员、开发者、查看者;
- 监控:
token消耗统计、调用量统计。
部署Dify
参考Dify源码中的docker目录,使用Docker Compose自定义部署Dify。
docker-compose默认配置
官方源码中默认启动以下容器,
7个核心服务:api、api_websocket、worker、worker_beat、web、plugin_daemon、agent_backend;8个依赖组件:weaviate、db_postgres、redis、nginx、ssrf_proxy、agent_ssrf_proxy、sandbox、local_sandbox;1个一次性任务:init_permissions,用于设置存储文件权限,完成后自动退出。
不同容器的用途
web:浏览器里的管理后台和用户应用界面;api:核心后端,处理登录、应用配置、对话、知识库、工作流、模型调用等;worker/worker_beat:后台任务和定时任务,例如文档解析、知识库索引、队列消费;db_postgres:保存用户、应用、工作流、会话、配置等业务数据;weaviate:保存知识库文档的向量索引,用于RAG检索;redis:缓存、任务队列、实时状态;plugin_daemon:运行和管理模型供应商、工具等插件;agent_backend+local_sandbox:运行Agent的代码执行、Shell工作区等受隔离能力;sandbox:传统代码执行沙箱;nginx:对外暴露HTTP/HTTPS,并转发请求到Web与API;ssrf_proxy:限制Sandbox发起网络请求的代理;api_websocket:协作编辑等实时WebSocket服务。
核心服务关系如下,
1
2
3
4
5
6
7
nginx -> web
      -> api -> redis
             -> agent_backend -> plugin_daemon
             -> PostgreSQL
             -> Weaviate

worker / worker_beat -> Redis、数据库、Agent Backend
api、worker、worker_beat共用同一份dify-api镜像,只是通过MODE分别运行API、异步任务和定时任务。init_permissions是一次性容器,完成挂载目录权限修复后退出,属于正常现象。
dify/docker/docker-compose.yaml是Dify的完整单机部署编排文件,包含核心应用、数据库、向量库及一些可选基础设施。它是生成文件,不能直接修改;应修改docker-compose-template.yaml或.env.example后运行generate_docker_compose。
env环境配置
.env用于配置服务的环境参数,其中就包含可选的启动组合,可以自由组合关系型主数据库、向量库、是否启用协作WebSocket,
DB_TYPE=postgresql
VECTOR_STORE=weaviate
COMPOSE_PROFILES=${VECTOR_STORE:-weaviate},${DB_TYPE:-postgresql},collaboration
默认启动的核心服务,
db_postgres,来自postgresql profile;weaviate,来自weaviate profile;api_websocket,来自collaboration profile。
仓库代码实际支持的主数据库类型有postgresql、mysql、oceanbase、seekdb。
本地Compose提供的向量库profile包含weaviate、qdrant、pgvector、chroma、milvus、elasticsearch、opensearch、oceanbase、seekdb、couchbase、iris、oracle、opengauss、myscale、matrixone、pgvecto-rs、vastbase。
常见且合理的替代组合如下,
| 用途 | DB_TYPE | VECTOR_STORE | 备注 |
|---|---|---|---|
| 默认通用 | postgresql | weaviate | 当前配置 |
| 简洁、常见替代 | postgresql | qdrant | 独立向量库,配置相对直接 |
| 更大规模向量检索 | postgresql | milvus | 会同时启动 Milvus、MinIO、etcd |
| SQL 体系内向量检索 | postgresql | pgvector | 系统库与向量库是两个独立PostgreSQL服务 |
| 搜索/分析型检索 | postgresql | elasticsearch 或 opensearch | 资源占用通常更高 |
| MySQL 主数据库 | mysql | weaviate / qdrant 等 | 可与任一支持的向量库组合 |
| OceanBase 一体化 | oceanbase | oceanbase | 同一个OceanBase服务承担主库和向量库 |
| SeekDB 一体化 | seekdb | seekdb | 同一个SeekDB服务承担主库和向量库 |
也可用外部托管数据库或向量库。这种情况下,保留对应的DB_TYPE/VECTOR_STORE,将DB_HOST、向量库endpoint、认证信息指向外部服务,并从COMPOSE_PROFILES中移除本地服务profile。例如,外部PostgreSQL + 外部Qdrant,
1
2
3
4
5
DB_TYPE=postgresql
DB_HOST=your-postgres-host
VECTOR_STORE=qdrant
QDRANT_URL=https://your-qdrant-host
COMPOSE_PROFILES=collaboration
不要在已有数据的实例上直接切换主数据库或向量库。主数据库切换需要迁移数据;向量库切换通常需要重建/重新索引知识库。切换前先备份
docker/volumes/下相关数据。
Profile结构
每个可选服务在YAML内有自己的profiles:,
- 数据库:
postgresql、mysql; - 协作与基础能力:
collaboration、certbot、unstructured; - 向量库/搜索引擎:
weaviate、qdrant、pgvector、chroma、milvus、elasticsearch、opensearch、oceanbase、seekdb、couchbase、iris、oracle、opengauss、myscale、matrixone、pgvecto-rs、vastbase。
milvus是一个组合profile,会连同etcd、minio、milvus-standalone一起启动。couchbase只有build:,因此docker compose pull不会拉到它,需要执行构建。
网络隔离
default:应用主网络,Nginx、Web、API、Redis、插件和Agent Backend在这里通信;ssrf_proxy_network:内部网络,Sandbox经ssrf_proxy访问外部,避免Sandbox直接暴露到默认网络;agent_sandbox_network:Agent Backend与local_sandbox的shellctl控制通道;local_sandbox_proxy_network:local_sandbox仅通过agent_ssrf_proxy出网。
这也是为什么会看到两个Squid容器:普通Sandbox和Agent本地Sandbox各自使用独立代理路径。
持久化
多数服务把数据绑定到docker/volumes/,例如PostgreSQL、Weaviate、Redis、插件文件和Sandbox依赖。Agent本地Sandbox的home/workspace使用命名卷。执行docker compose down -v会删除命名卷,但不会删除这些宿主机目录绑定的数据。
需要注意的配置点
API对数据库等依赖标记为required: false,profile没启用时Compose不会替你启动数据库;COMPOSE_PROFILES是关键配置;- 不要同时启用
oceanbase与seekdb,二者默认都映射宿主机2881端口;- 核心镜像中仍有
nginx:latest、ubuntu/squid:latest、busybox:latest。生产环境建议锁定到具体版本或digest,避免未来重启拉到不兼容版本;Compose中含有开发默认密码、API key与secret fallback;正式部署应在.env中替换它们,尤其是数据库密码、Weaviate key、插件密钥、Sandbox key与Agent server secret。
启动服务
修改默认部署配置,
1
2
3
4
5
6
7
8
9
10
11
12
DB_TYPE=mysql
DB_USERNAME=root
DB_HOST=db_mysql
DB_PORT=3306
VECTOR_STORE=milvus

MILVUS_URI=http://milvus-standalone:19530
MILVUS_USER=root
MILVUS_PASSWORD=Milvus
MILVUS_DATABASE=default
# 不使用 token 认证时保持为空
MILVUS_TOKEN=
注意,
- 需补齐
MySQL配置,避免切到MySQL后,应用仍使用PostgreSQL的连接参数,尝试访问不存在的db_postgres;MILVUS_TOKEN和MILVUS_USER,Dify要求二选一,MILVUS_TOKEN或同时提供MILVUS_USER和MILVUS_PASSWORD,自带Milvus服务启用了认证,默认凭据正是root/Milvus。校验逻辑在./api/providers/vdb/vdb-milvus/src/dify_vdb_milvus/milvus_vector.py:56,没有token时,必须有user和password。
验证后,Compose会选择db_mysql,以及Milvus依赖的etcd、minio、milvus-standalone,同时保留collaboration。不需要修改docker-compose-template.yaml、.env.example或运行生成脚本,因为相关profile已存在。不需要改COMPOSE_PROFILES,它引用的是当前变量值,
1
COMPOSE_PROFILES=${VECTOR_STORE:-weaviate},${DB_TYPE:-postgresql},collaboration
所以Compose实际解析为,
1
COMPOSE_PROFILES=milvus,mysql,collaboration
其中:-weaviate和:-postgresql仅在前面的变量未设置或为空时才作为默认值生效。当前配置已正确选中db_mysql、etcd、minio、milvus-standalone。
启动服务,如下,
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
$ docker compose up -d
[+] up 25/25
 ✔ Network docker_ssrf_proxy_network                Created                          0.0s
 ✔ Network docker_default                           Created                          0.0s
 ✔ Network docker_local_sandbox_proxy_network       Created                          0.0s
 ✔ Network docker_agent_sandbox_network             Created                          0.0s
 ✔ Network docker_milvus                            Created                          0.0s
 ✔ Volume docker_dify_agent_local_sandbox_home      Created                          0.0s
 ✔ Volume docker_dify_agent_local_sandbox_workspace Created                          0.0s
 ✔ Container milvus-etcd                            Started                          2.0s
 ✔ Container docker-agent_ssrf_proxy-1              Started                          2.1s
 ✔ Container milvus-minio                           Started                          1.9s
 ✔ Container docker-redis-1                         Started                          2.0s
 ✔ Container docker-db_mysql-1                      Healthy                          6.4s
 ✔ Container docker-ssrf_proxy-1                    Started                          2.0s
 ✔ Container docker-init_permissions-1              Exited                           6.4s
 ✔ Container docker-sandbox-1                       Started                          2.0s
 ✔ Container docker-local_sandbox-1                 Started                          2.1s
 ✔ Container docker-web-1                           Started                          2.0s
 ✔ Container milvus-standalone                      Started                          2.3s
 ✔ Container docker-plugin_daemon-1                 Started                          5.6s
 ✔ Container docker-worker_beat-1                   Started                          5.6s
 ✔ Container docker-api_websocket-1                 Started                          5.6s
 ✔ Container docker-agent_backend-1                 Started                          5.2s
 ✔ Container docker-api-1                           Started                          5.7s
 ✔ Container docker-worker-1                        Started                          5.6s
 ✔ Container docker-nginx-1                         Started                          5.6s
docker下的Dify完整启动后,常驻服务共17个,另有init_permissions初始化容器正常退出;配置实际启用了mysql、milvus和collaboration三个profile。
入口是http://localhost,由Nginx对外暴露80/443,当前没有启用HTTPS。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
浏览器
  |
Nginx :80/:443
  |-- /                  -> web:3000
  |-- /console/api,/api,
/v1,/openapi,/files,
/mcp,/triggers           -> api:5001
  |-- /socket.io          -> api_websocket:5001
  '-- /e/...              -> plugin_daemon:5002

api / worker / agent_backend
  |-- MySQL: 业务与配置数据
  |-- Redis: 缓存、Celery 消息队列、Agent 状态
  |-- Milvus: 知识库向量索引
  |-- Plugin Daemon: 模型、工具、重排等插件
  |-- Sandbox: Workflow 代码执行
  '-- Local Agent Sandbox: 新 Agent 的 Shell 工作区
| 组件 | 用途与配合方式 |
|---|---|
nginx | 统一网关。将页面请求转发给web,业务API转发给api,协作Socket.IO转发给api_websocket,插件Webhook /e/直达插件守护进程。规则见./docker/nginx/conf.d/default.conf:4。 |
web | Next.js控制台与终端用户页面,内部调用api:5001。 |
api | Flask/Gunicorn主后端,承接应用运行、知识库、工作流、文件、MCP、OpenAPI、管理台等同步请求。 |
api_websocket | 协作模式专用Socket.IO服务,使用WebSocket worker,支持工作流协作等高连接数实时交互。 |
worker | Celery异步消费者。实际监听文档索引、RAG Pipeline、邮件、插件、工作流执行记录、定时与触发器等队列。 |
worker_beat | Celery定时调度器。日志显示已在周期投递人工输入超时检查、定时工作流轮询、触发器订阅刷新。 |
db_mysql | 当前主数据库,存储租户、应用、工作流、会话、配置、执行记录等关系数据。数据持久化在volumes/mysql/data。 |
redis | API缓存与协调;Celery Broker使用DB 1;新版Agent后端使用DB 2。 |
etcd + minio + milvus-standalone | 当前知识库向量检索后端。Milvus保存向量索引,etcd保存其元数据协调状态,MinIO保存Milvus对象数据。API/Worker因本地覆盖配置接入Milvus内网。 |
sandbox | Dify Workflow 的 Code 节点等受控代码执行环境,出网经过 ssrf_proxy。 |
ssrf_proxy | 为API/代码执行提供受限的HTTP(S)出网通道,降低HTTP请求节点、网页读取和代码请求内网地址的SSRF风险。 |
plugin_daemon | 安装、存储、启动和隔离插件运行时,供API/Worker调用模型、工具、数据源、触发器。当前已启动local-rerank:0.0.2和openai_api_compatible:0.0.66,可定期关注插件持久化目录大小。 |
agent_backend | 新版Agent的控制与编排服务,向Dify API提供Agent运行能力,并协调插件、Redis和Agent Sandbox。 |
local_sandbox | 新Agent的本地Shell执行环境,运行Go shellctl和tmux,保存/home/dify、/workspace卷。它不加入默认业务网络。 |
agent_ssrf_proxy | Agent沙箱专用代理。使local_sandbox的网络访问经受控转发,避免它直接访问主API或任意内网地址。 |
init_permissions | 已正常退出,启动时修正volumes/app/storage所有权,保证API/Worker可以读写上传文件和本地存储。 |
未运行的是PostgreSQL、Weaviate、Qdrant、PGVector、Chroma、OpenSearch、Elasticsearch、Certbot、Unstructured等可选服务。它们仍定义在./docker/docker-compose.yaml,但当前无需启动,因为配置为DB_TYPE=mysql、VECTOR_STORE=milvus。
一次典型的知识库问答链路是,
浏览器经Nginx到web和api;API读取MySQL中的应用与知识库配置,向Milvus检索向量;如果文档需要导入或索引,API把任务投递到Redis,Worker做解析、分段、Embedding和写入Milvus;若配置了重排,则经Plugin Daemon调用已运行的本地重排插件;最终API流式返回答案。
一次新版
Agent执行链路是,
API接到Agent请求后调用agent_backend;后者获取模型/工具插件能力,并将Shell类任务交给隔离的local_sandbox;沙箱出网必须经过agent_ssrf_proxy。这使Agent可以使用受控工作目录执行任务,而不会直接获得整套Dify内网权限。
登录访问
设置管理员账户:http://localhost/install,登陆Dify:http://localhost,
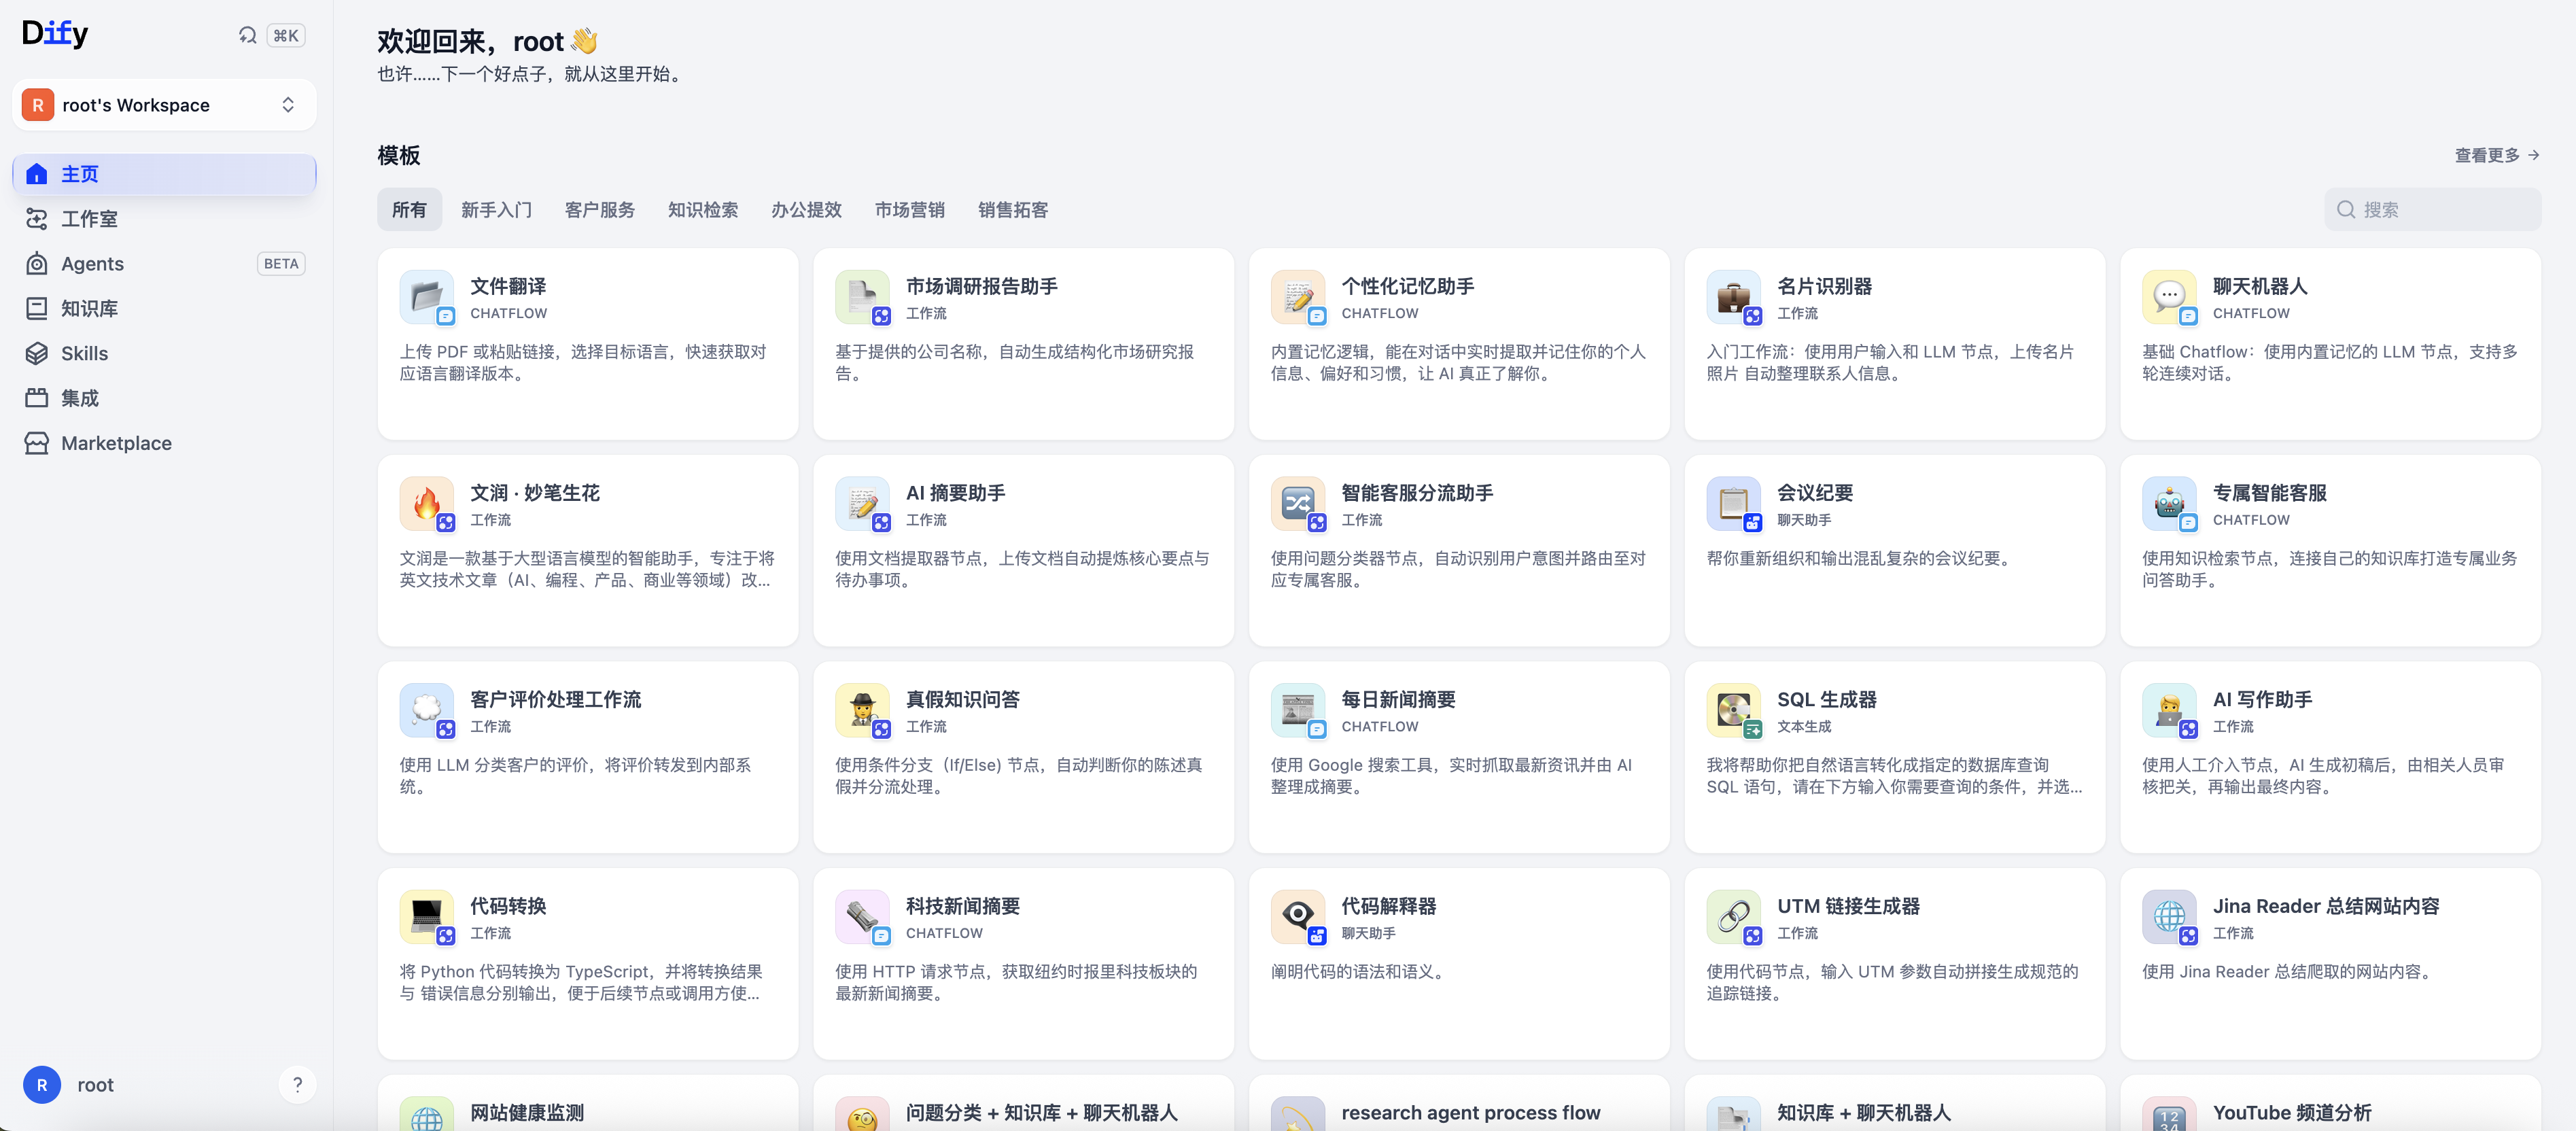 Dify 首页
配置模型
Dify本身不运行大模型,它作为模型网关,通过API调用外部模型服务;模型分为4大类,
LLM对话模型(Chatbot/Agent/Workflow里的LLM节点);Embedding嵌入模型(RAG知识库切片向量化);Rerank重排模型(RAG检索后排序);- 文本转语音/语音转文字/图像模型(多模态)。
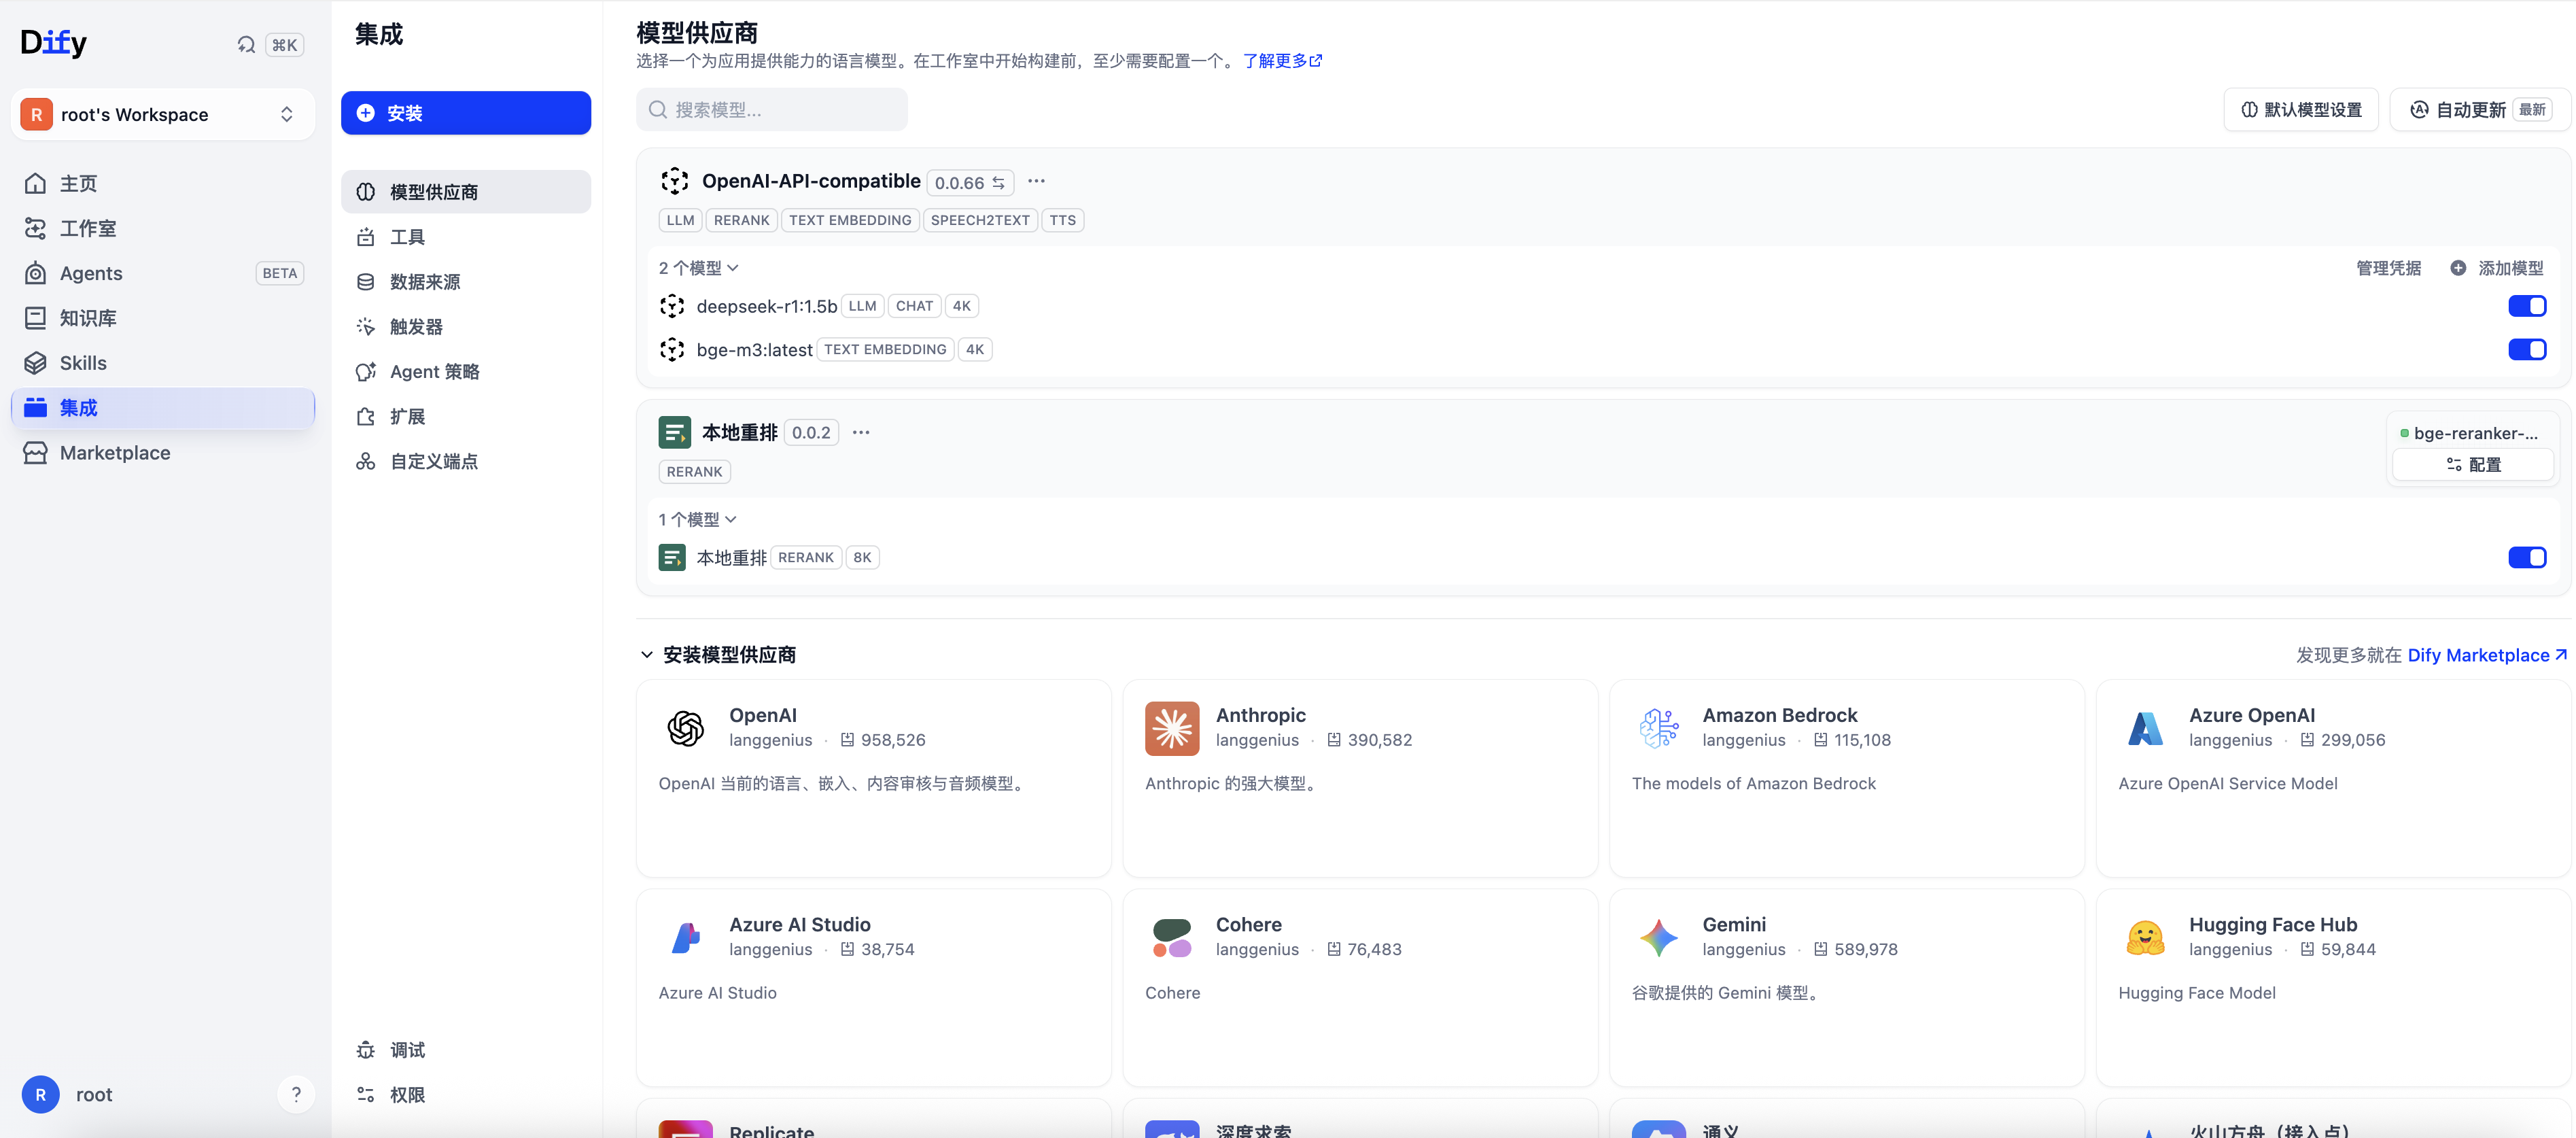 模型供应商
全局模型供应商配置(工作区全局添加)
操作路径:集成 → 模型供应商
- 找到需要的厂商(通义千问、
DeepSeek、OpenAI、文心一言等),点击安装插件; - 点击添加模型,填入厂商给的
API Key;部分厂商需要填写API Endpoint(自定义地址); - 开启需要使用的模型开关(例如
qwen-turbo、deepseek-chat); - (可选)设置系统默认模型:默认推理
LLM、默认Embedding、默认Rerank,新建应用会自动选用。
通用兼容方案:
OpenAI兼容API插件
所有支持OpenAI格式接口的模型(Ollama、Xinference、本地部署模型),都选这个插件,填入自定义endpoint+api-key即可接入。
示例:接入本地Ollama模型(本地私有化模型)
- 先本地启动
Ollama,ollama run deepseek-r1:1.5b,保证Dify服务器可以访问Ollama地址(http://host:11434/v1); Dify模型供应商安装OpenAI兼容API插件;Endpoint填写http://你的ollamaIP:11434/v1,API Key随便填(ollama默认不需要key);- 添加模型名称
deepseek-r1:1.5b,保存; ollama运行的Embedding模型,与之类似。
应用内选择并模型(每个应用可以单独指定,覆盖全局默认)
模型配置和前面
5个产品功能案例的关系
Chatbot:全局选一个LLM,应用级参数;RAG:Chatbot绑定知识库,额外单独配置Embedding/Rerank模型;Workflow:每个LLM节点独立选择模型,互不影响;Agent:复用Chatbot应用的LLM,Agent的思考+工具调用全部由这个LLM完成;Chatflow:画布内LLM节点单独选模型,会话内可以多个模型切换。
Chatbot(基础对话/Agent应用)
目标:测试对话上下文记忆、系统提示词、多轮聊天。
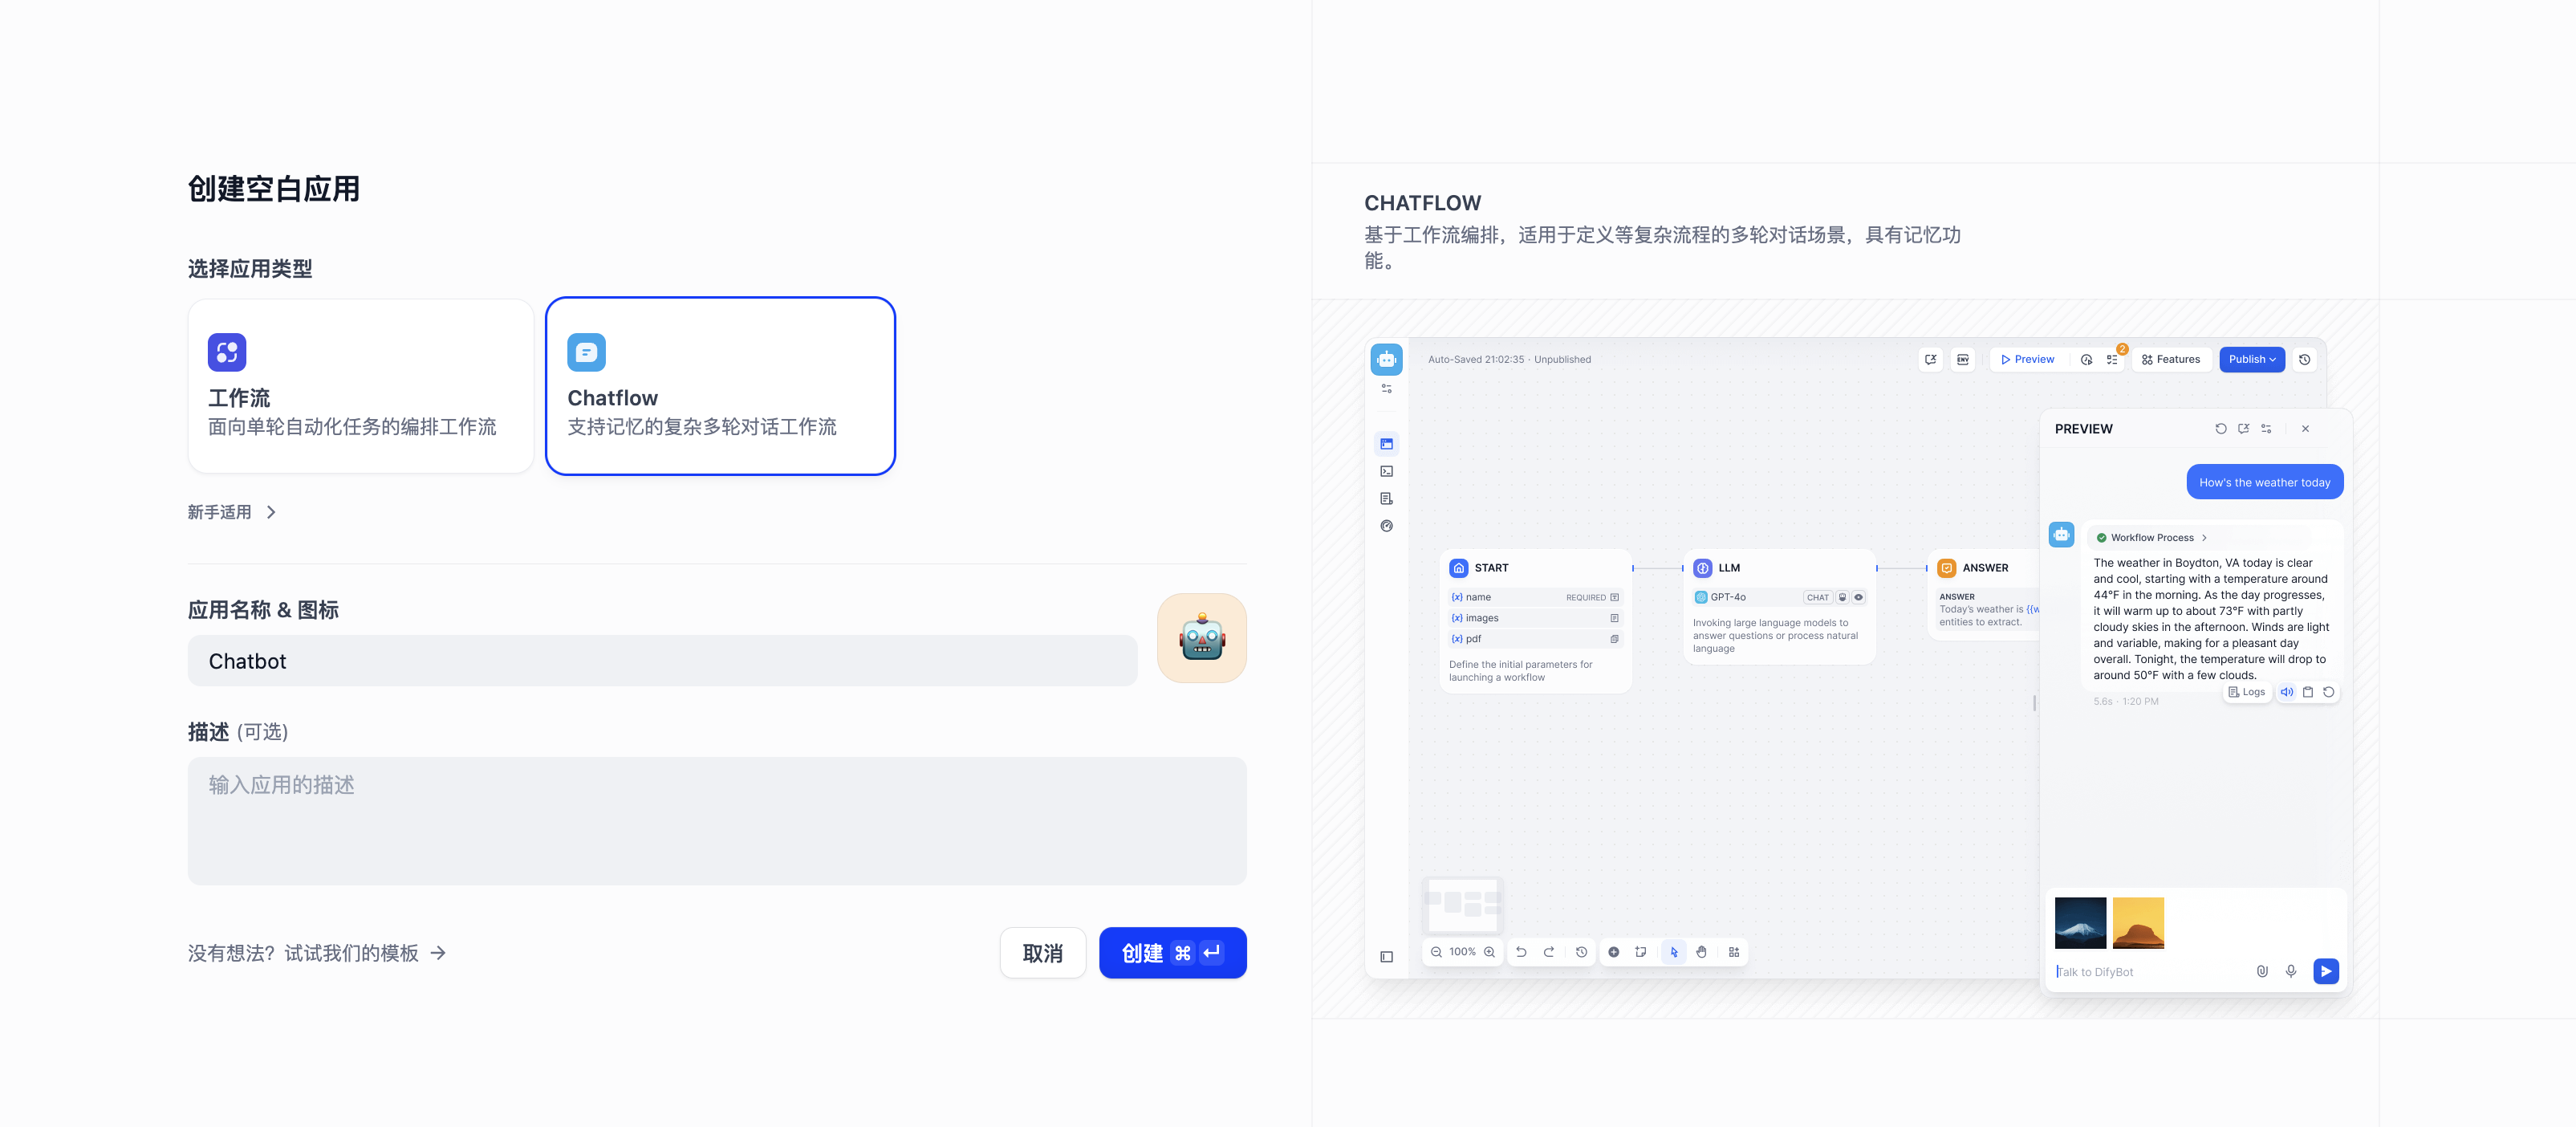 创建Chatbot
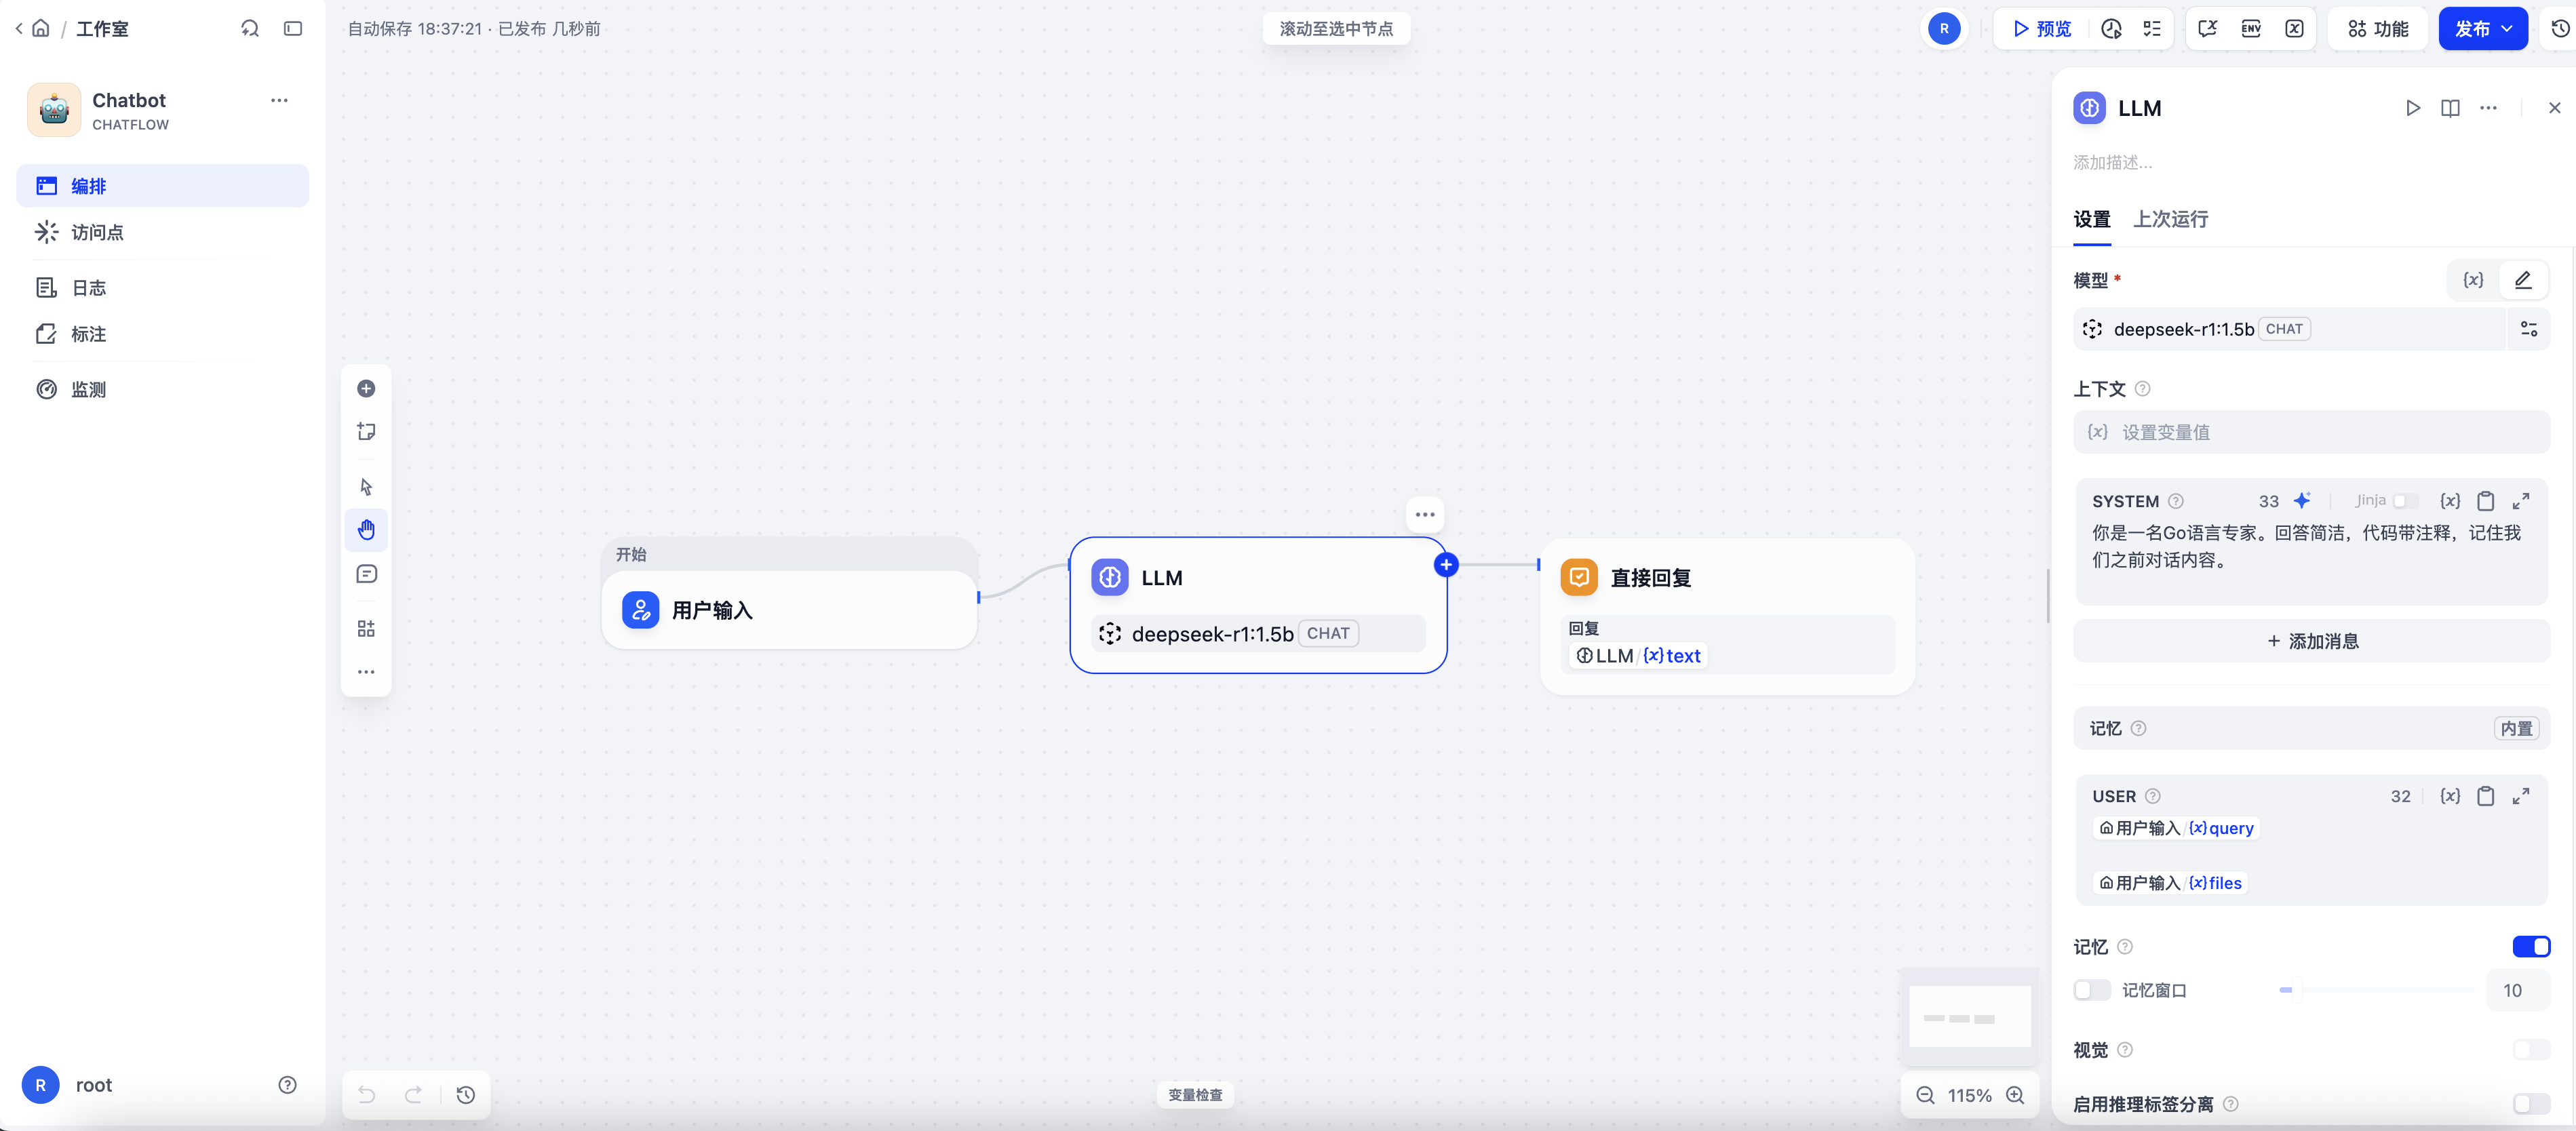 创建Chatbot
RAG知识库的Embedding/Rerank模型
目标:验证知识库上传、文本切片、向量检索、引用来源、防幻觉。
重点看:回答下方是否有引用片段,用来判断RAG是否真正生效,而不是纯大模型回答。
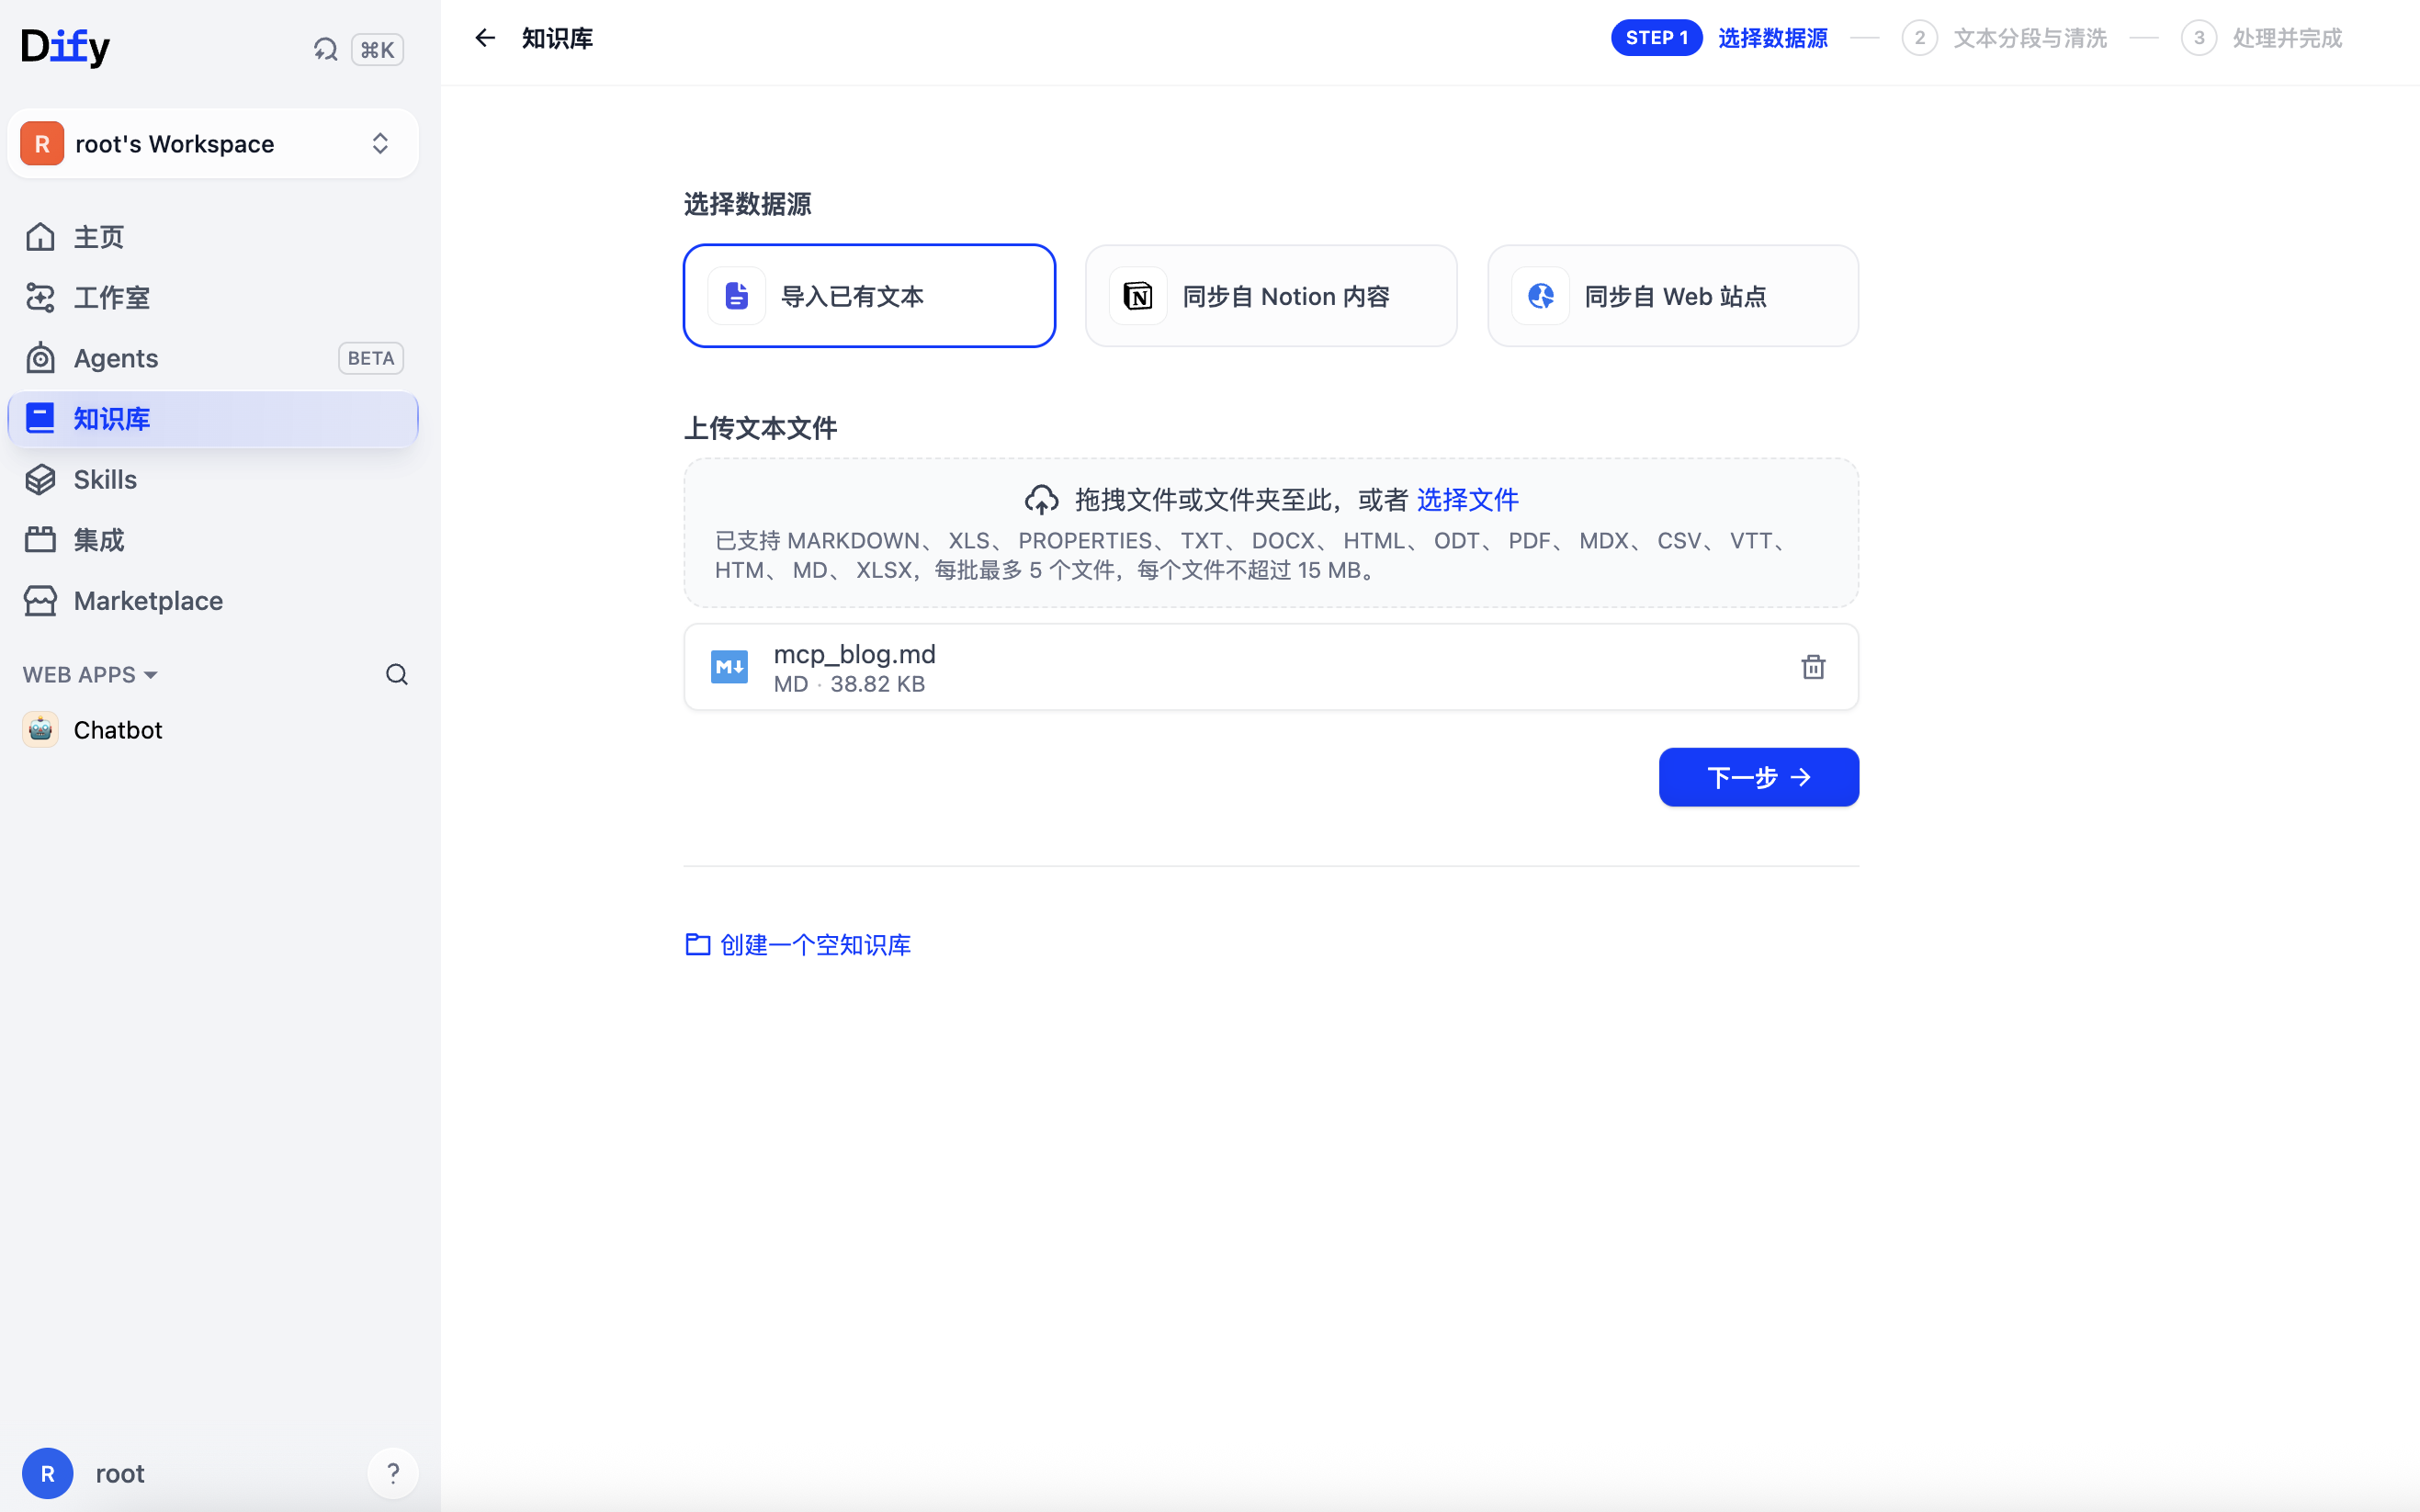 创建知识库
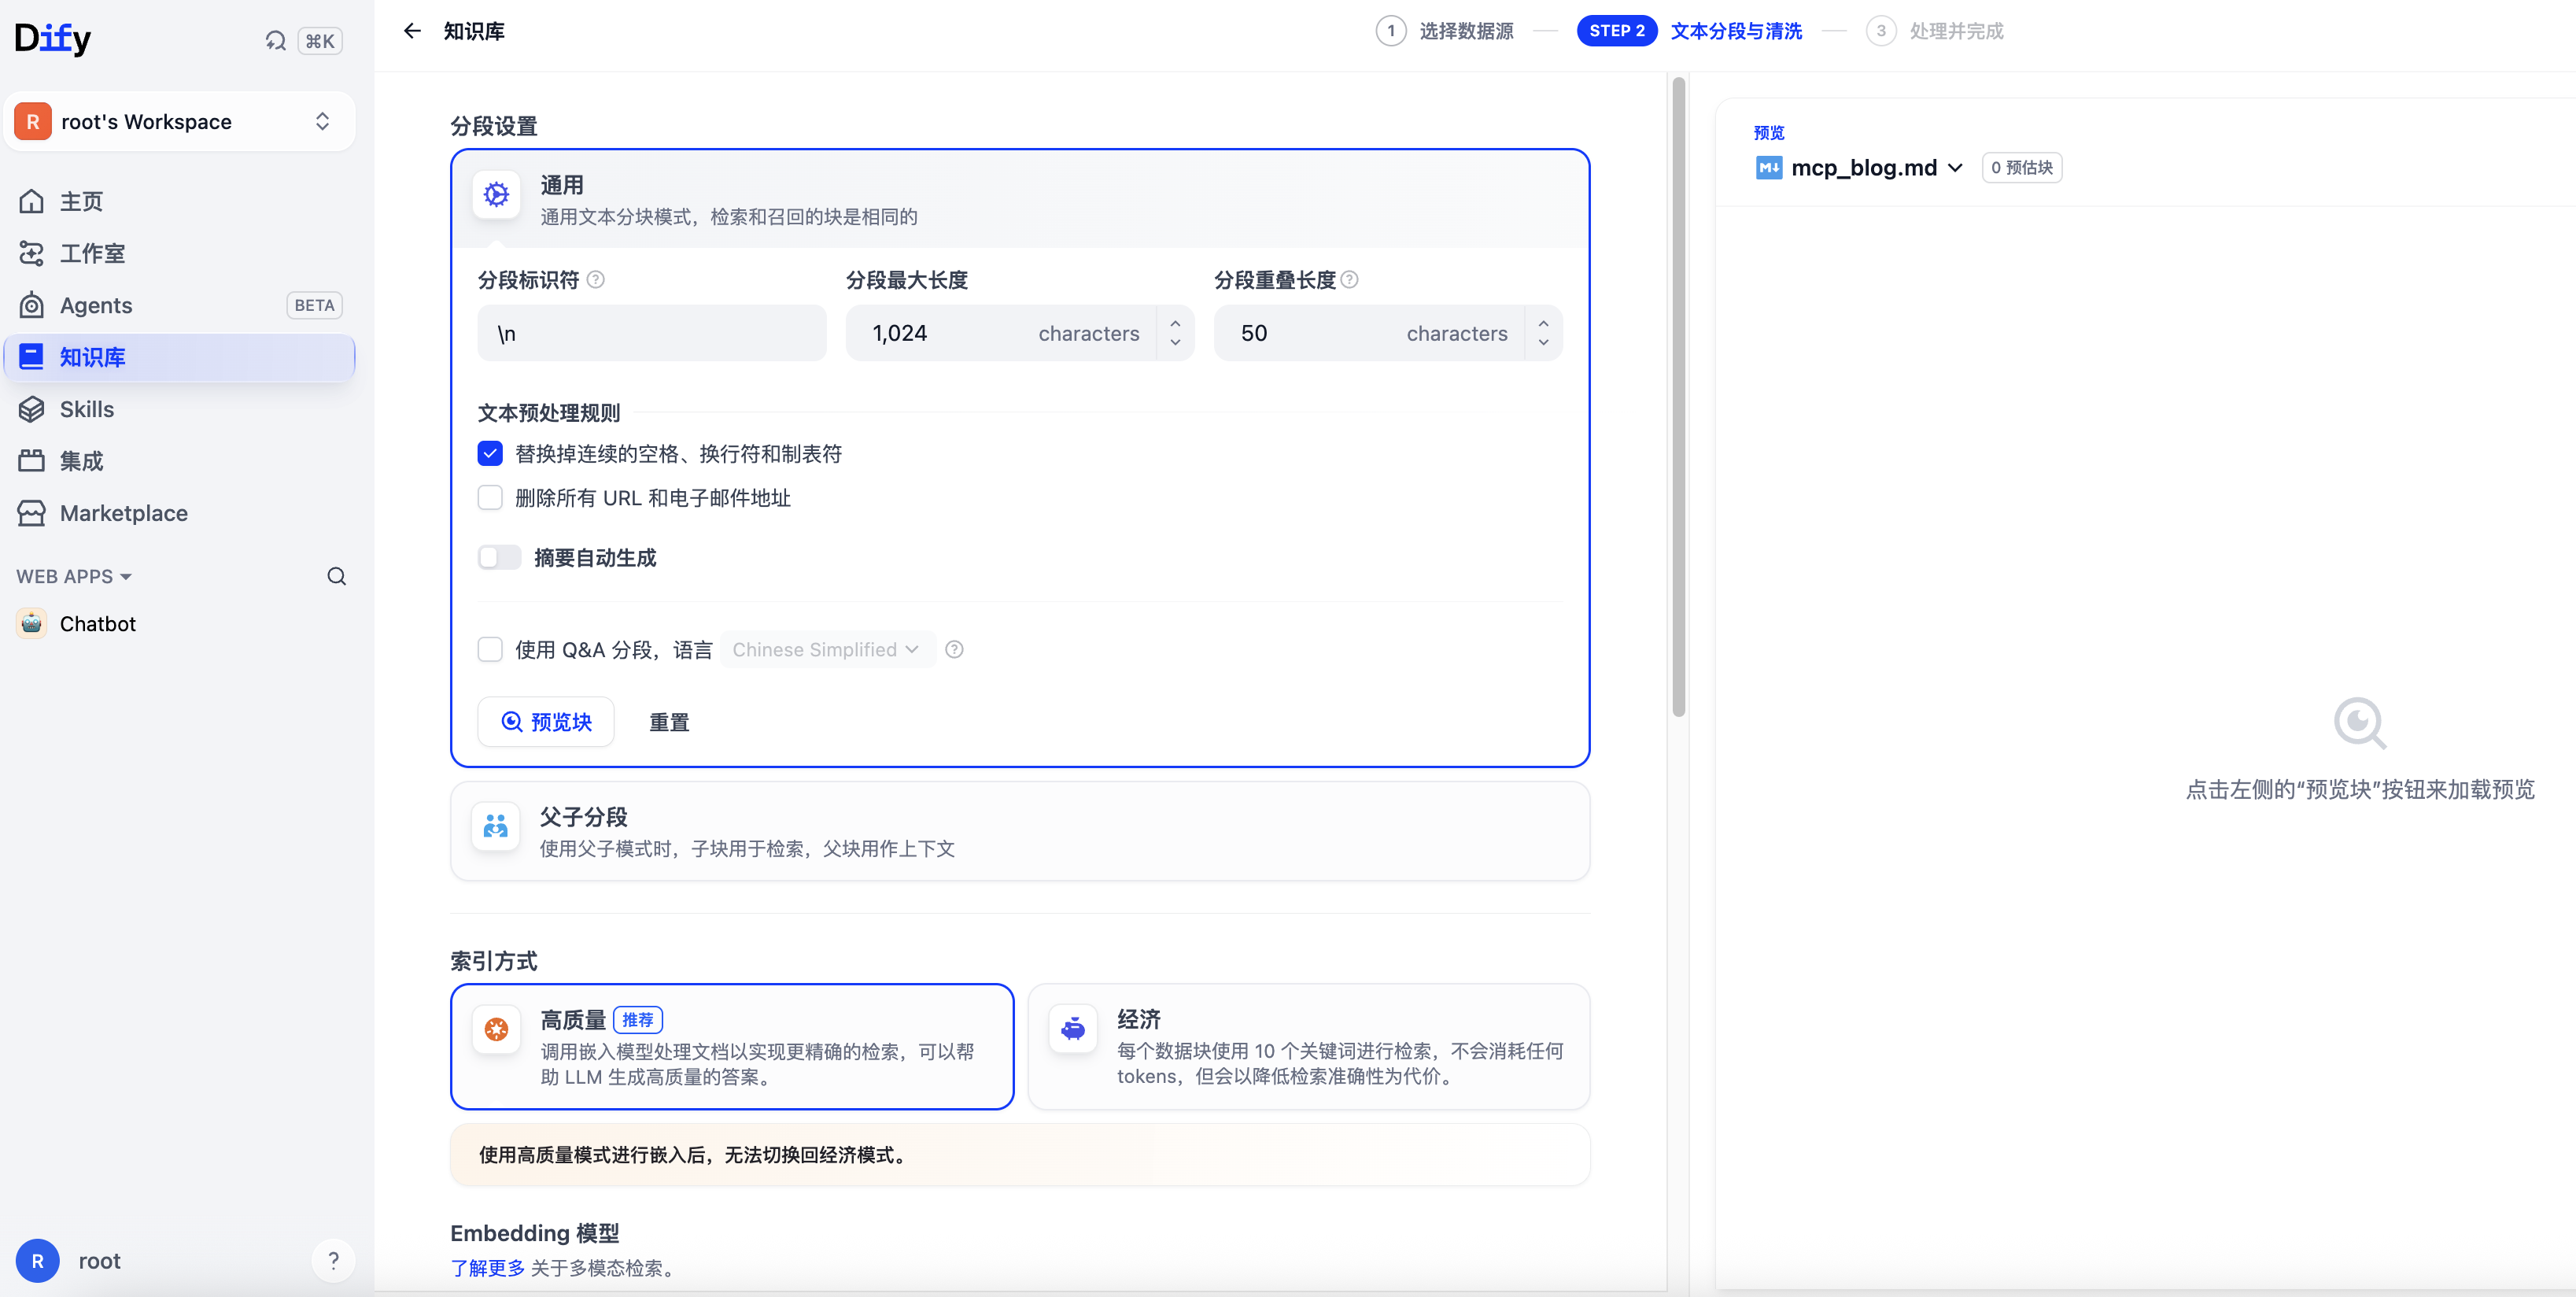 创建知识库:分段设置、索引方式
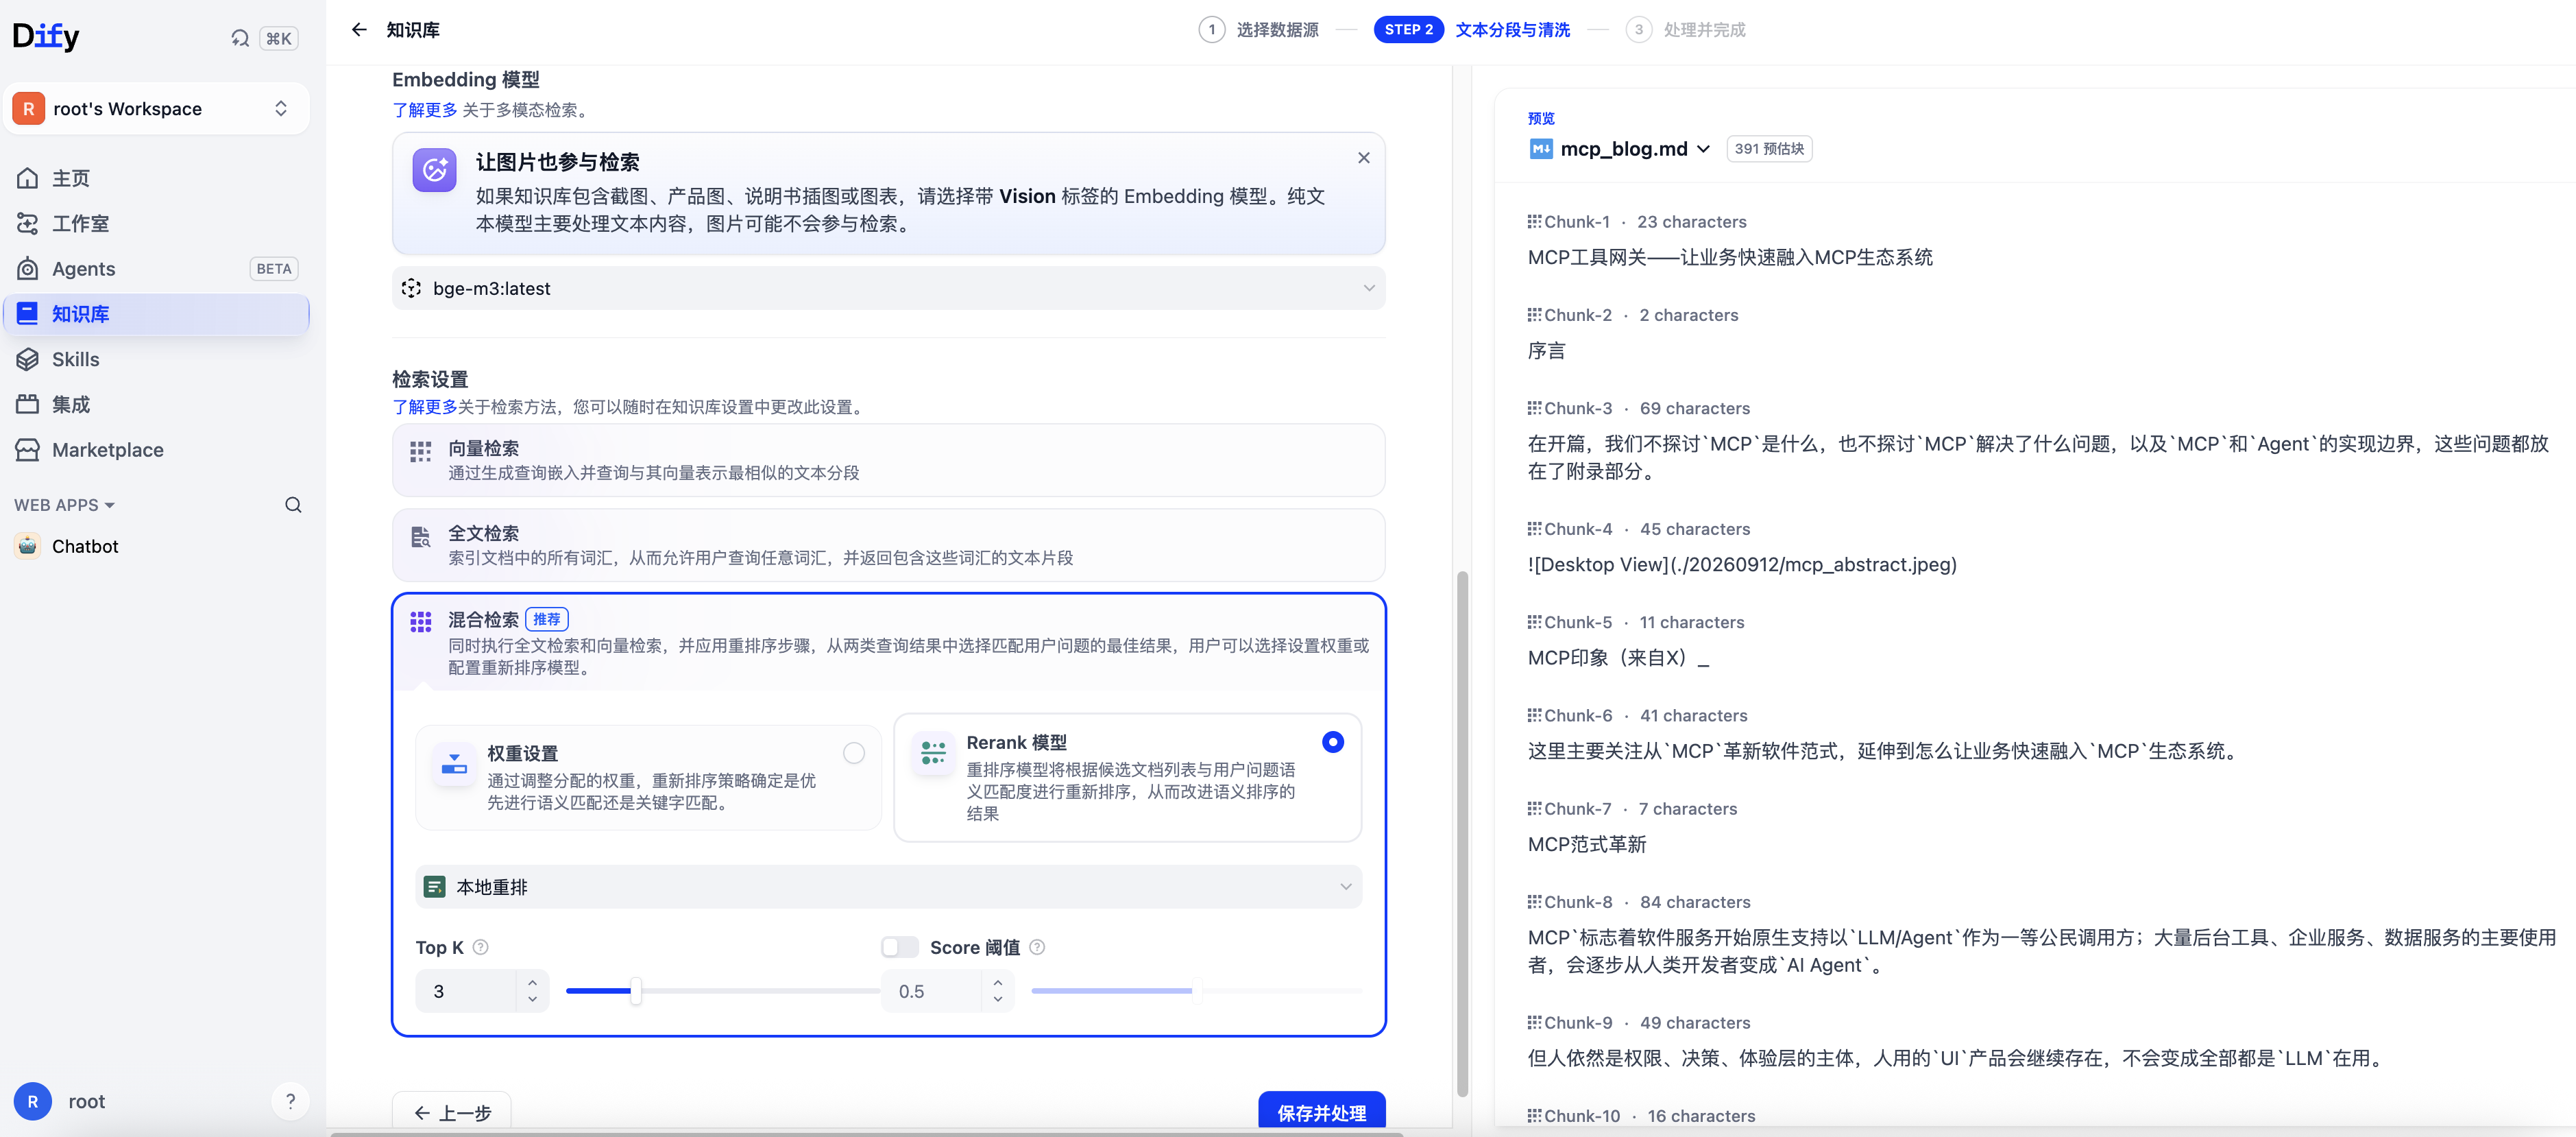 创建知识库:检索设置
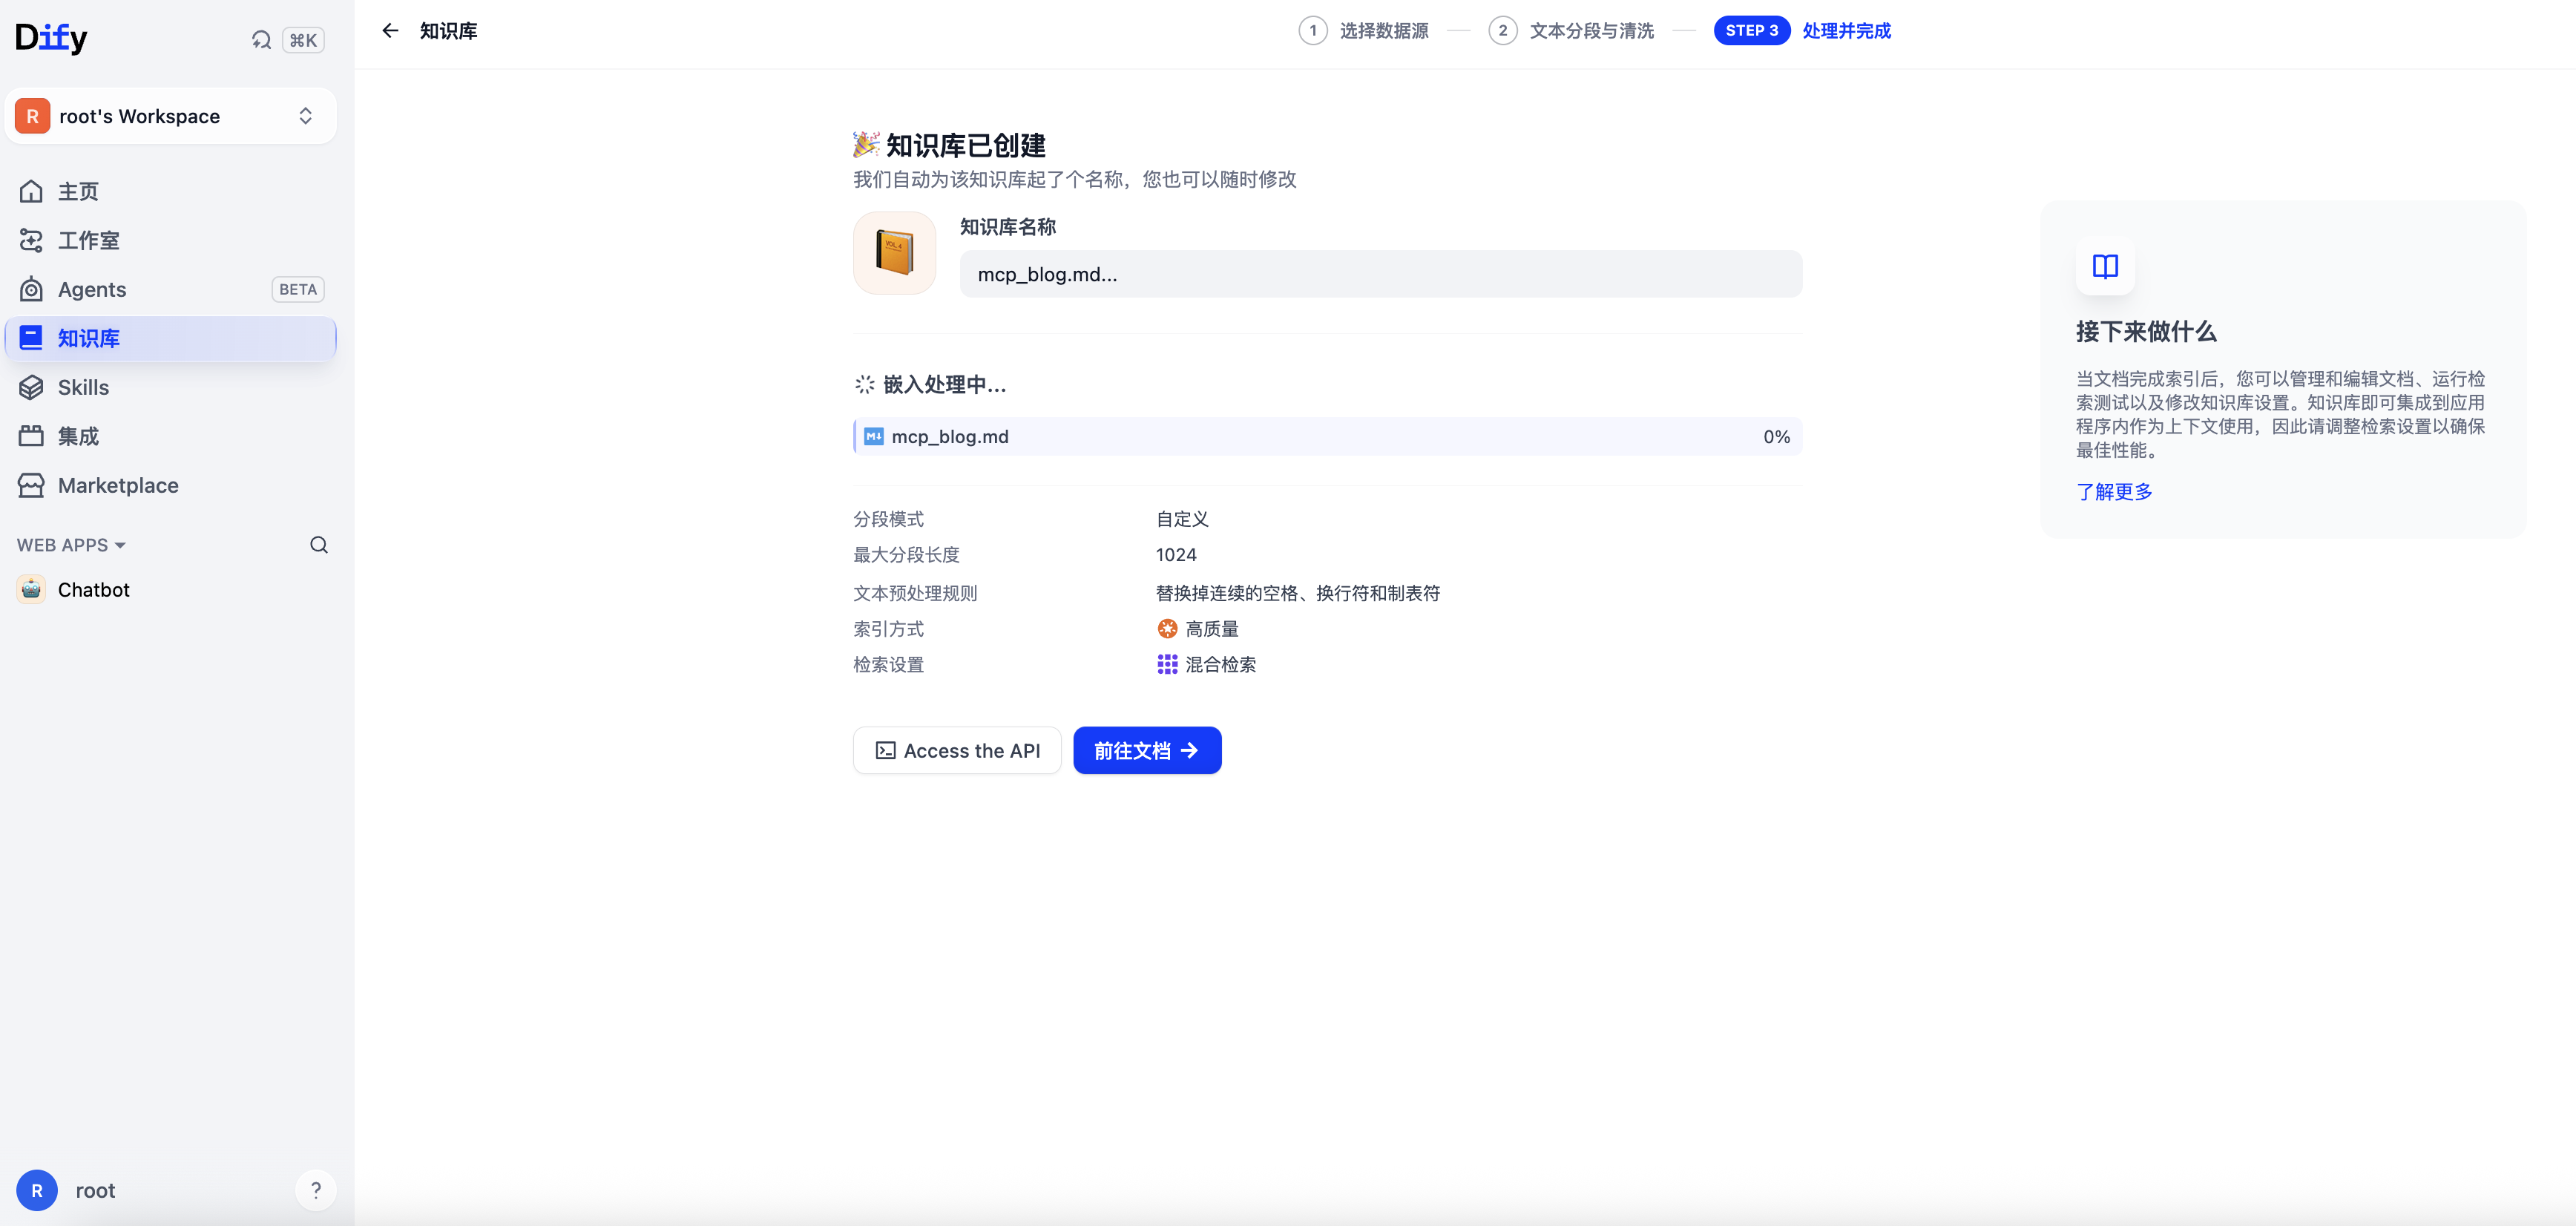 创建知识库:嵌入处理
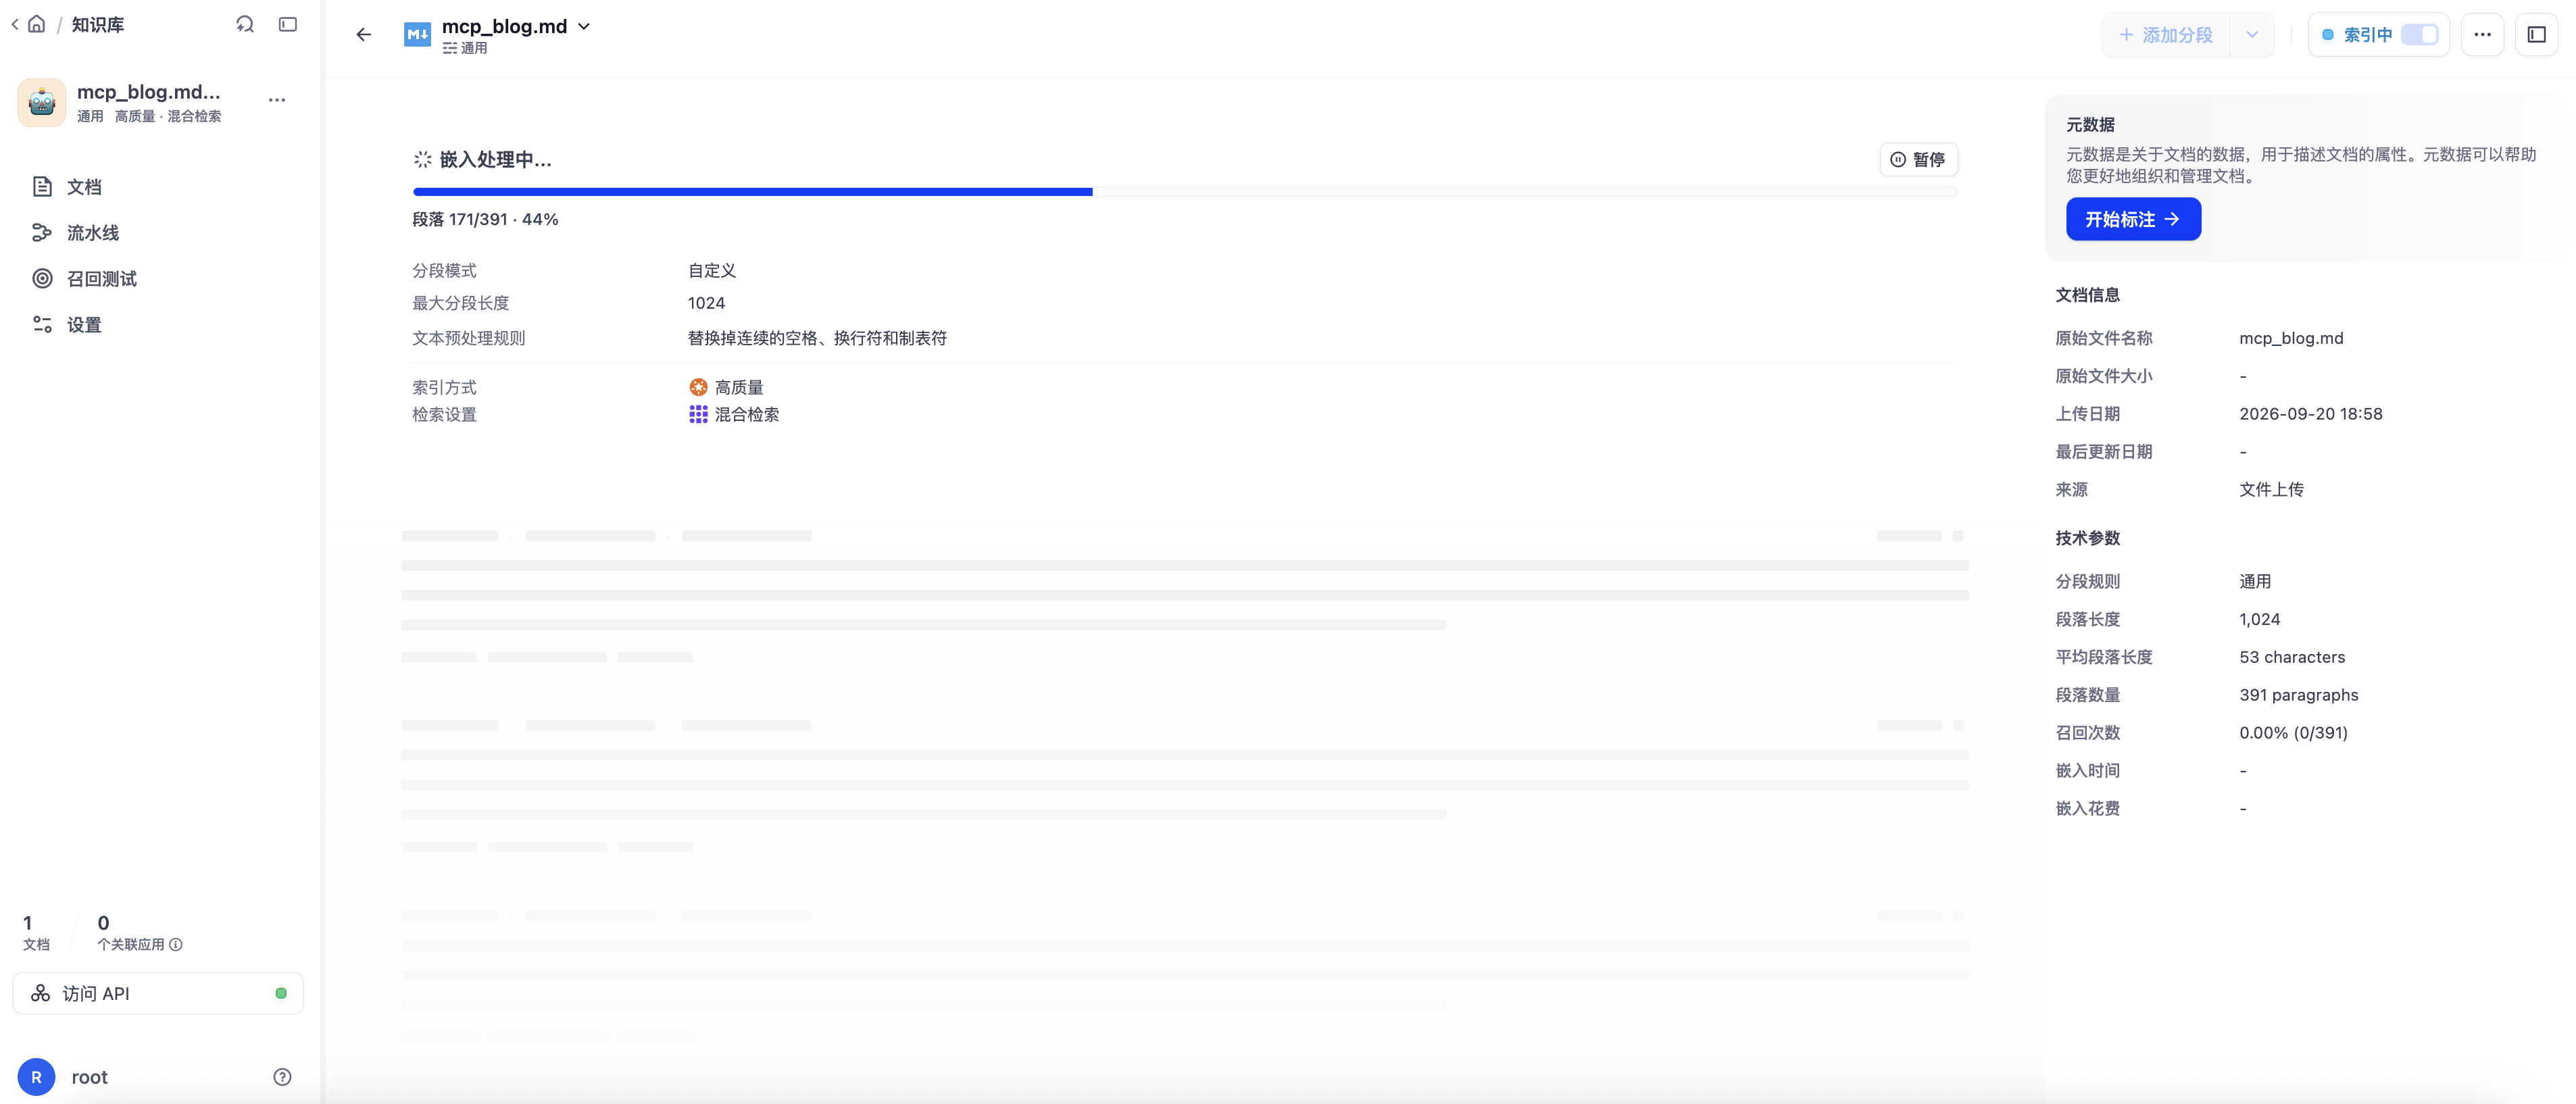 创建知识库:嵌入处理(文档页面)
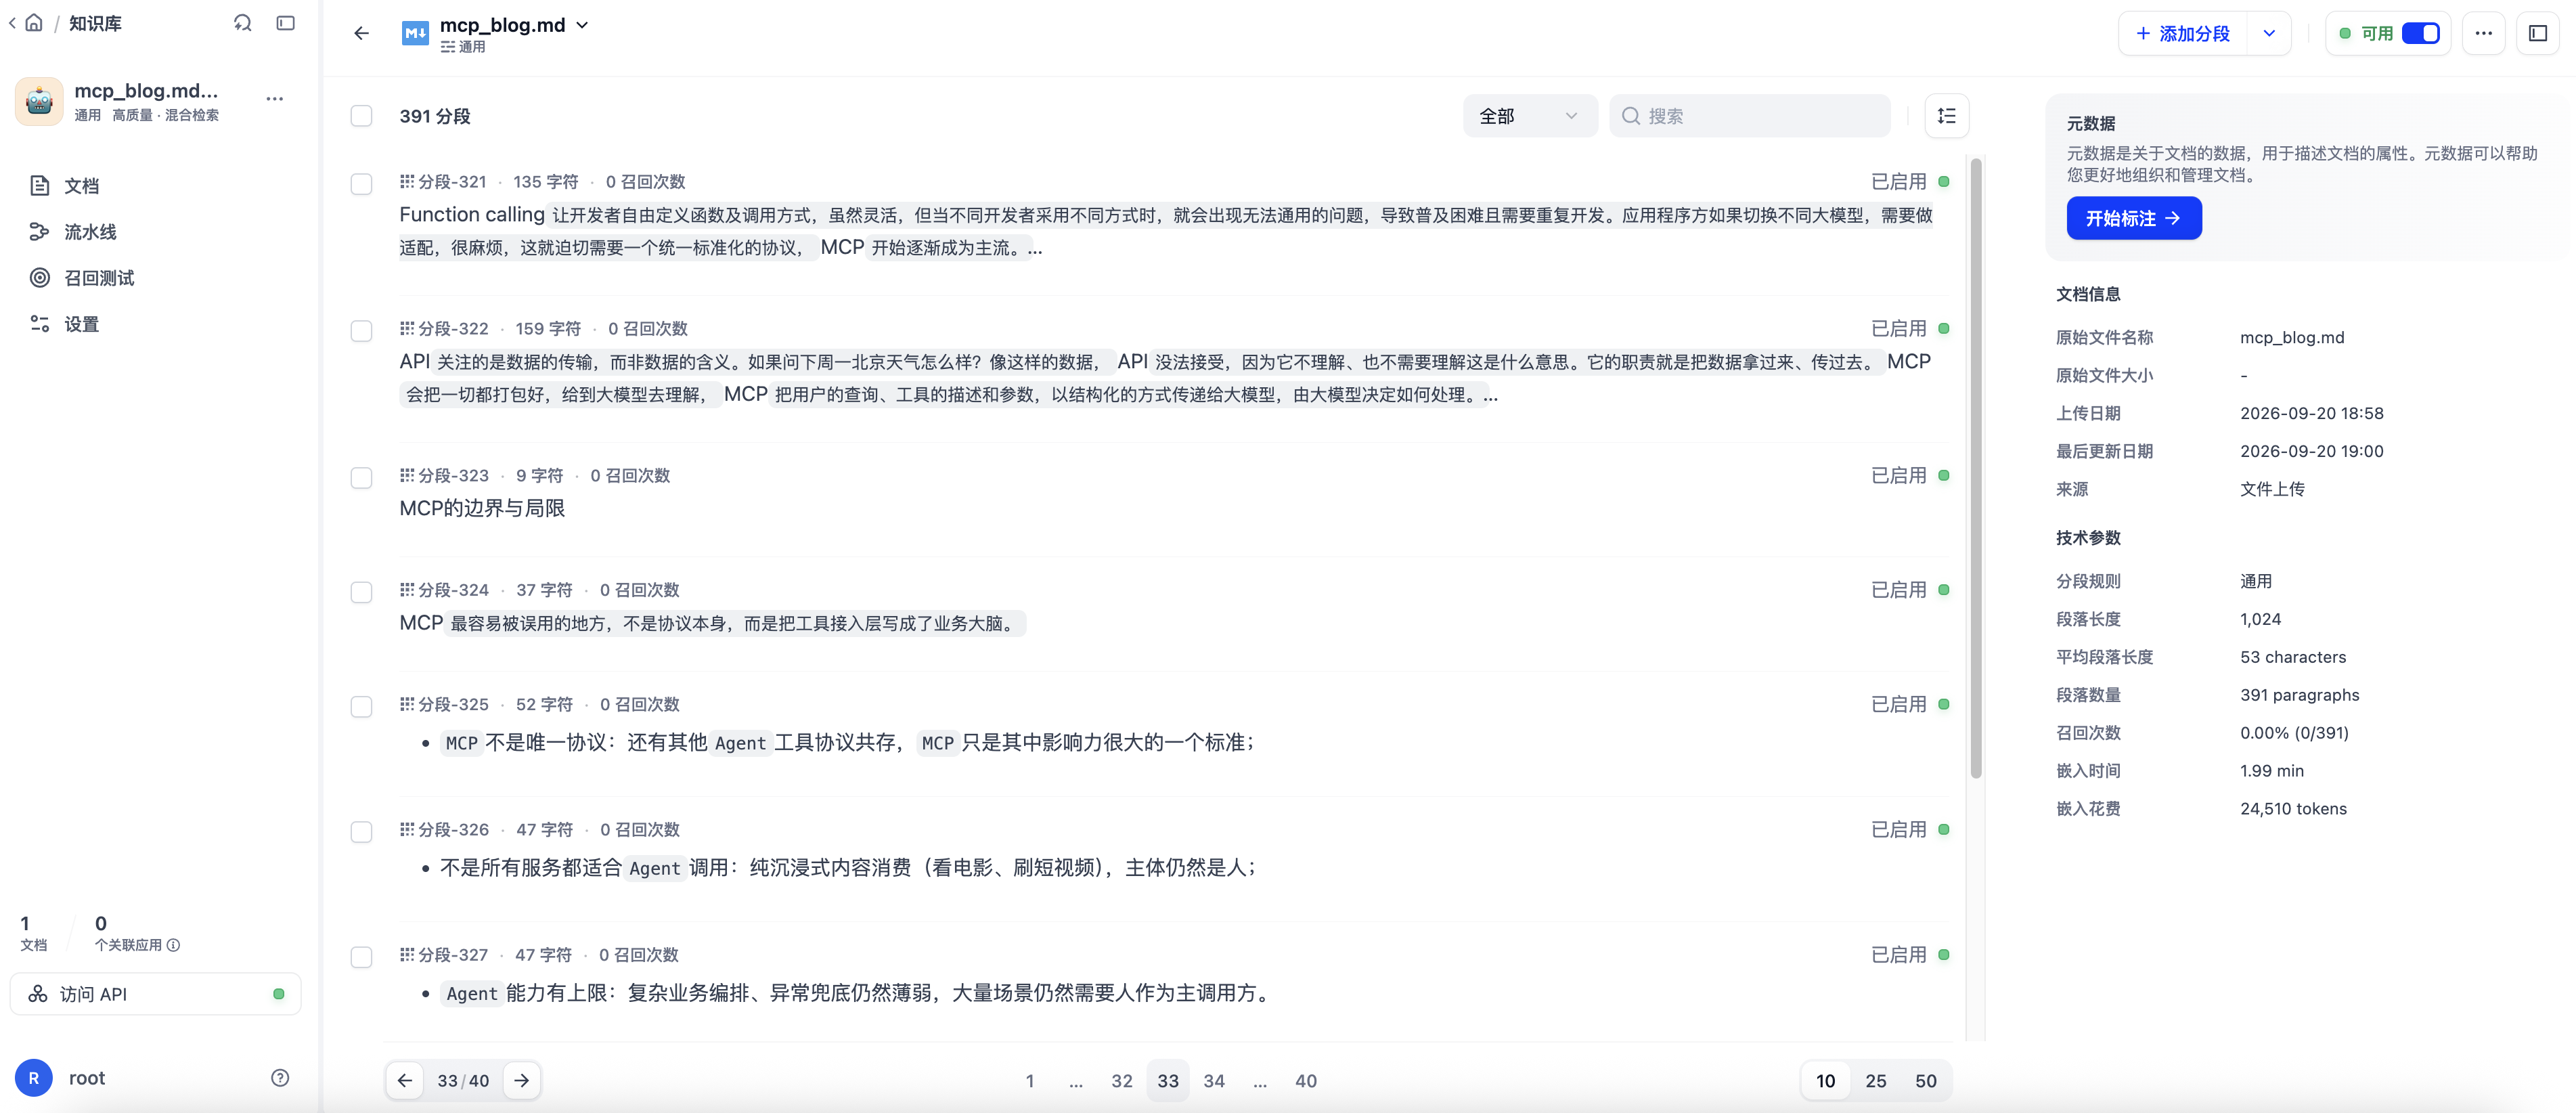 创建知识库:嵌入处理完成
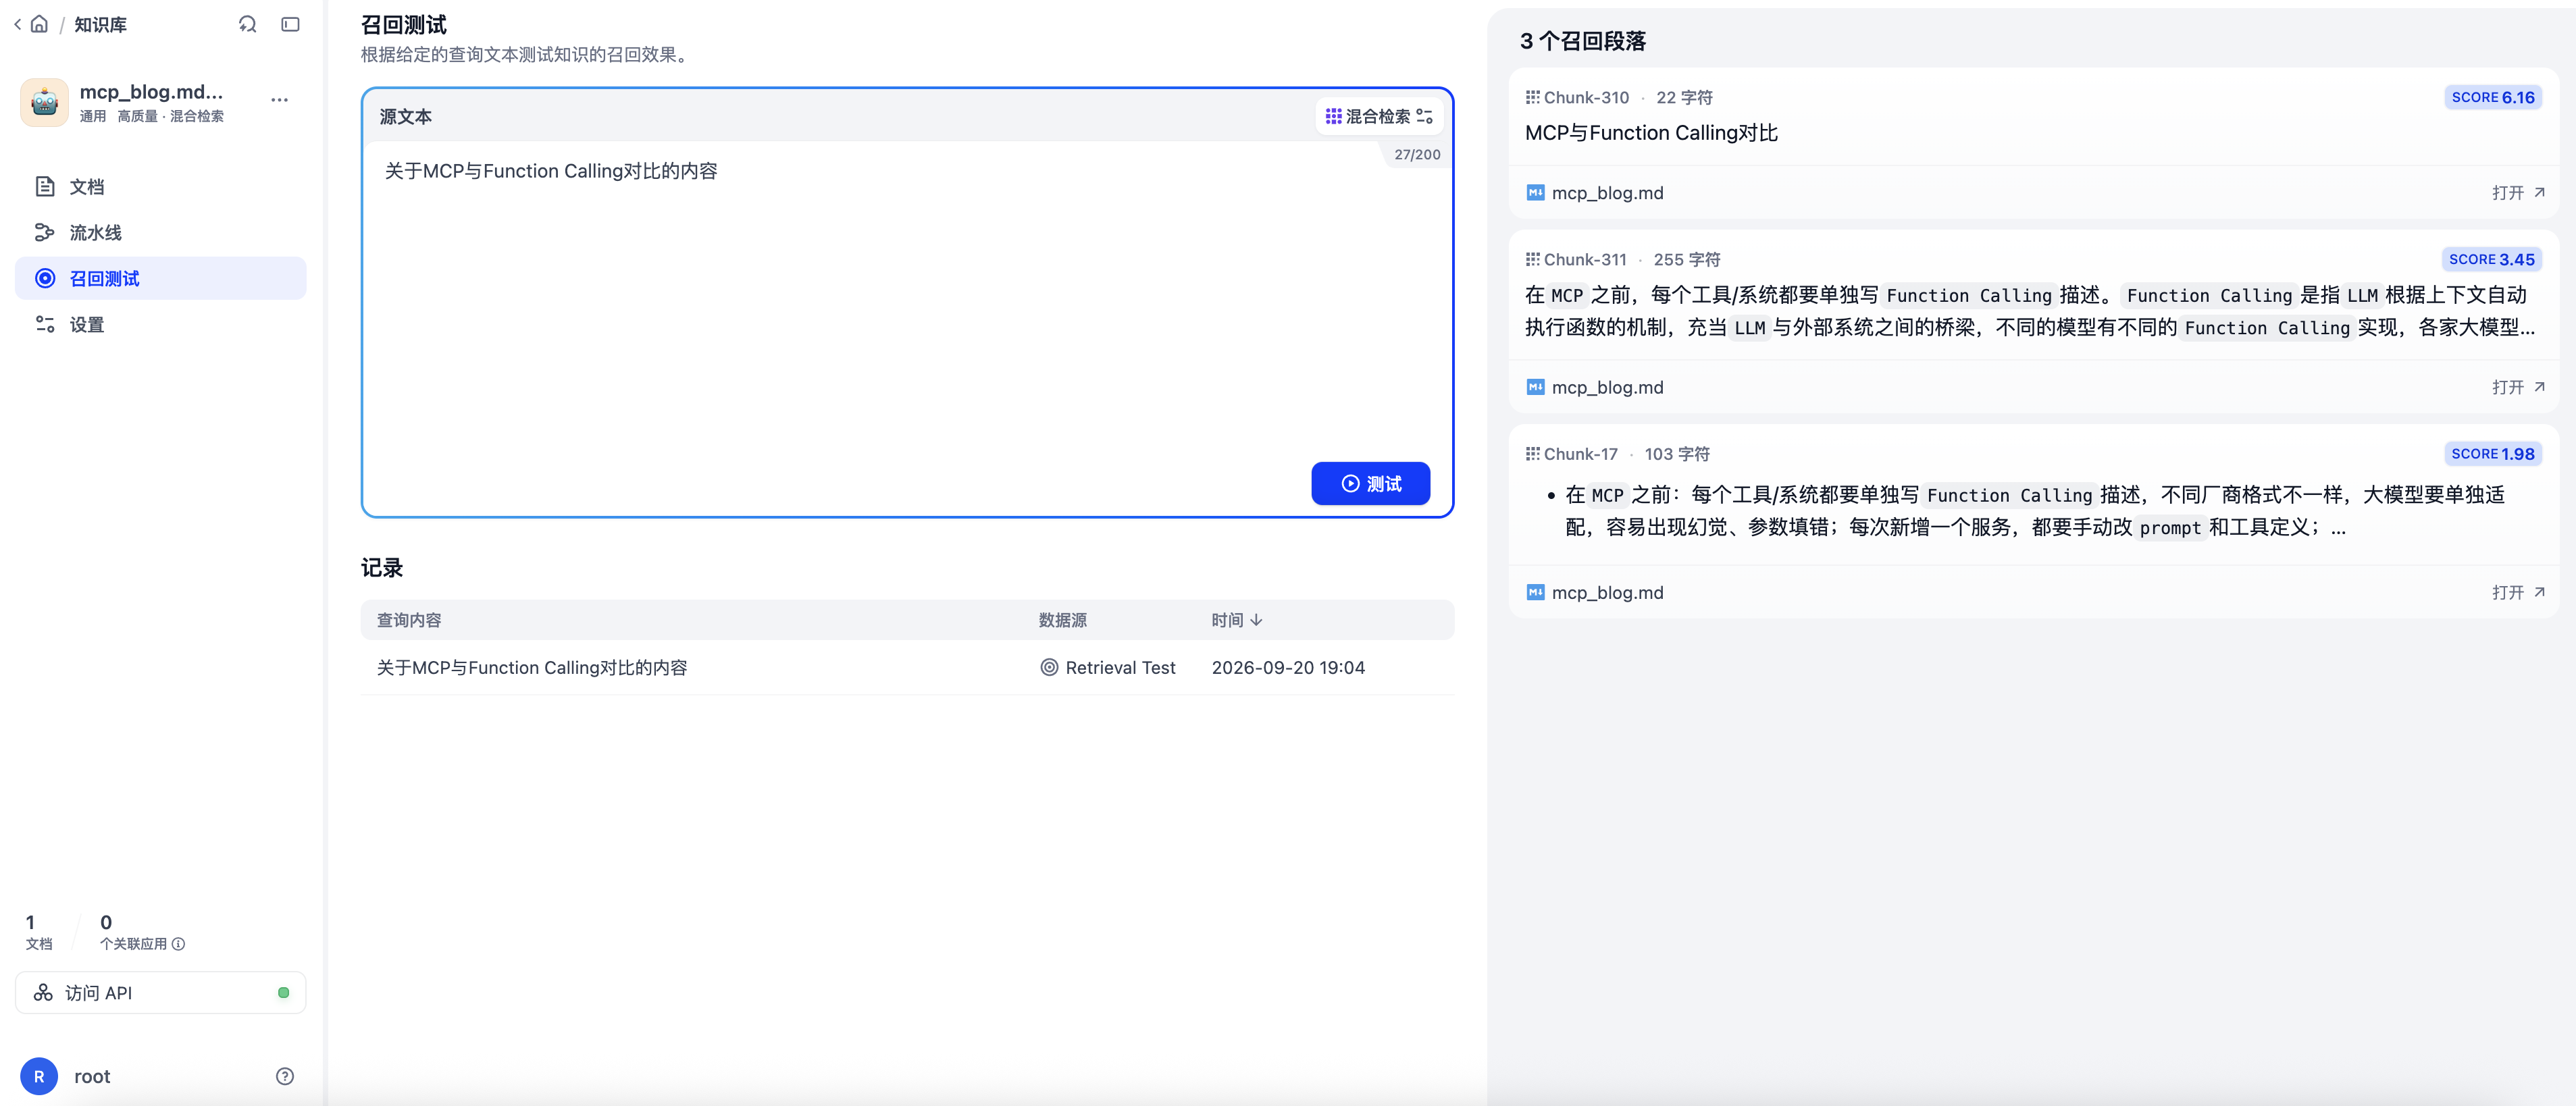 召回测试
Embedding模型一旦上传文档切片后,不能随意更换,向量维度不匹配会导致检索失效。
Workflow工作流(拖拽编排,条件分支+代码节点)
目标:测试节点串联、If-Else分支、Python代码沙箱、变量传递。
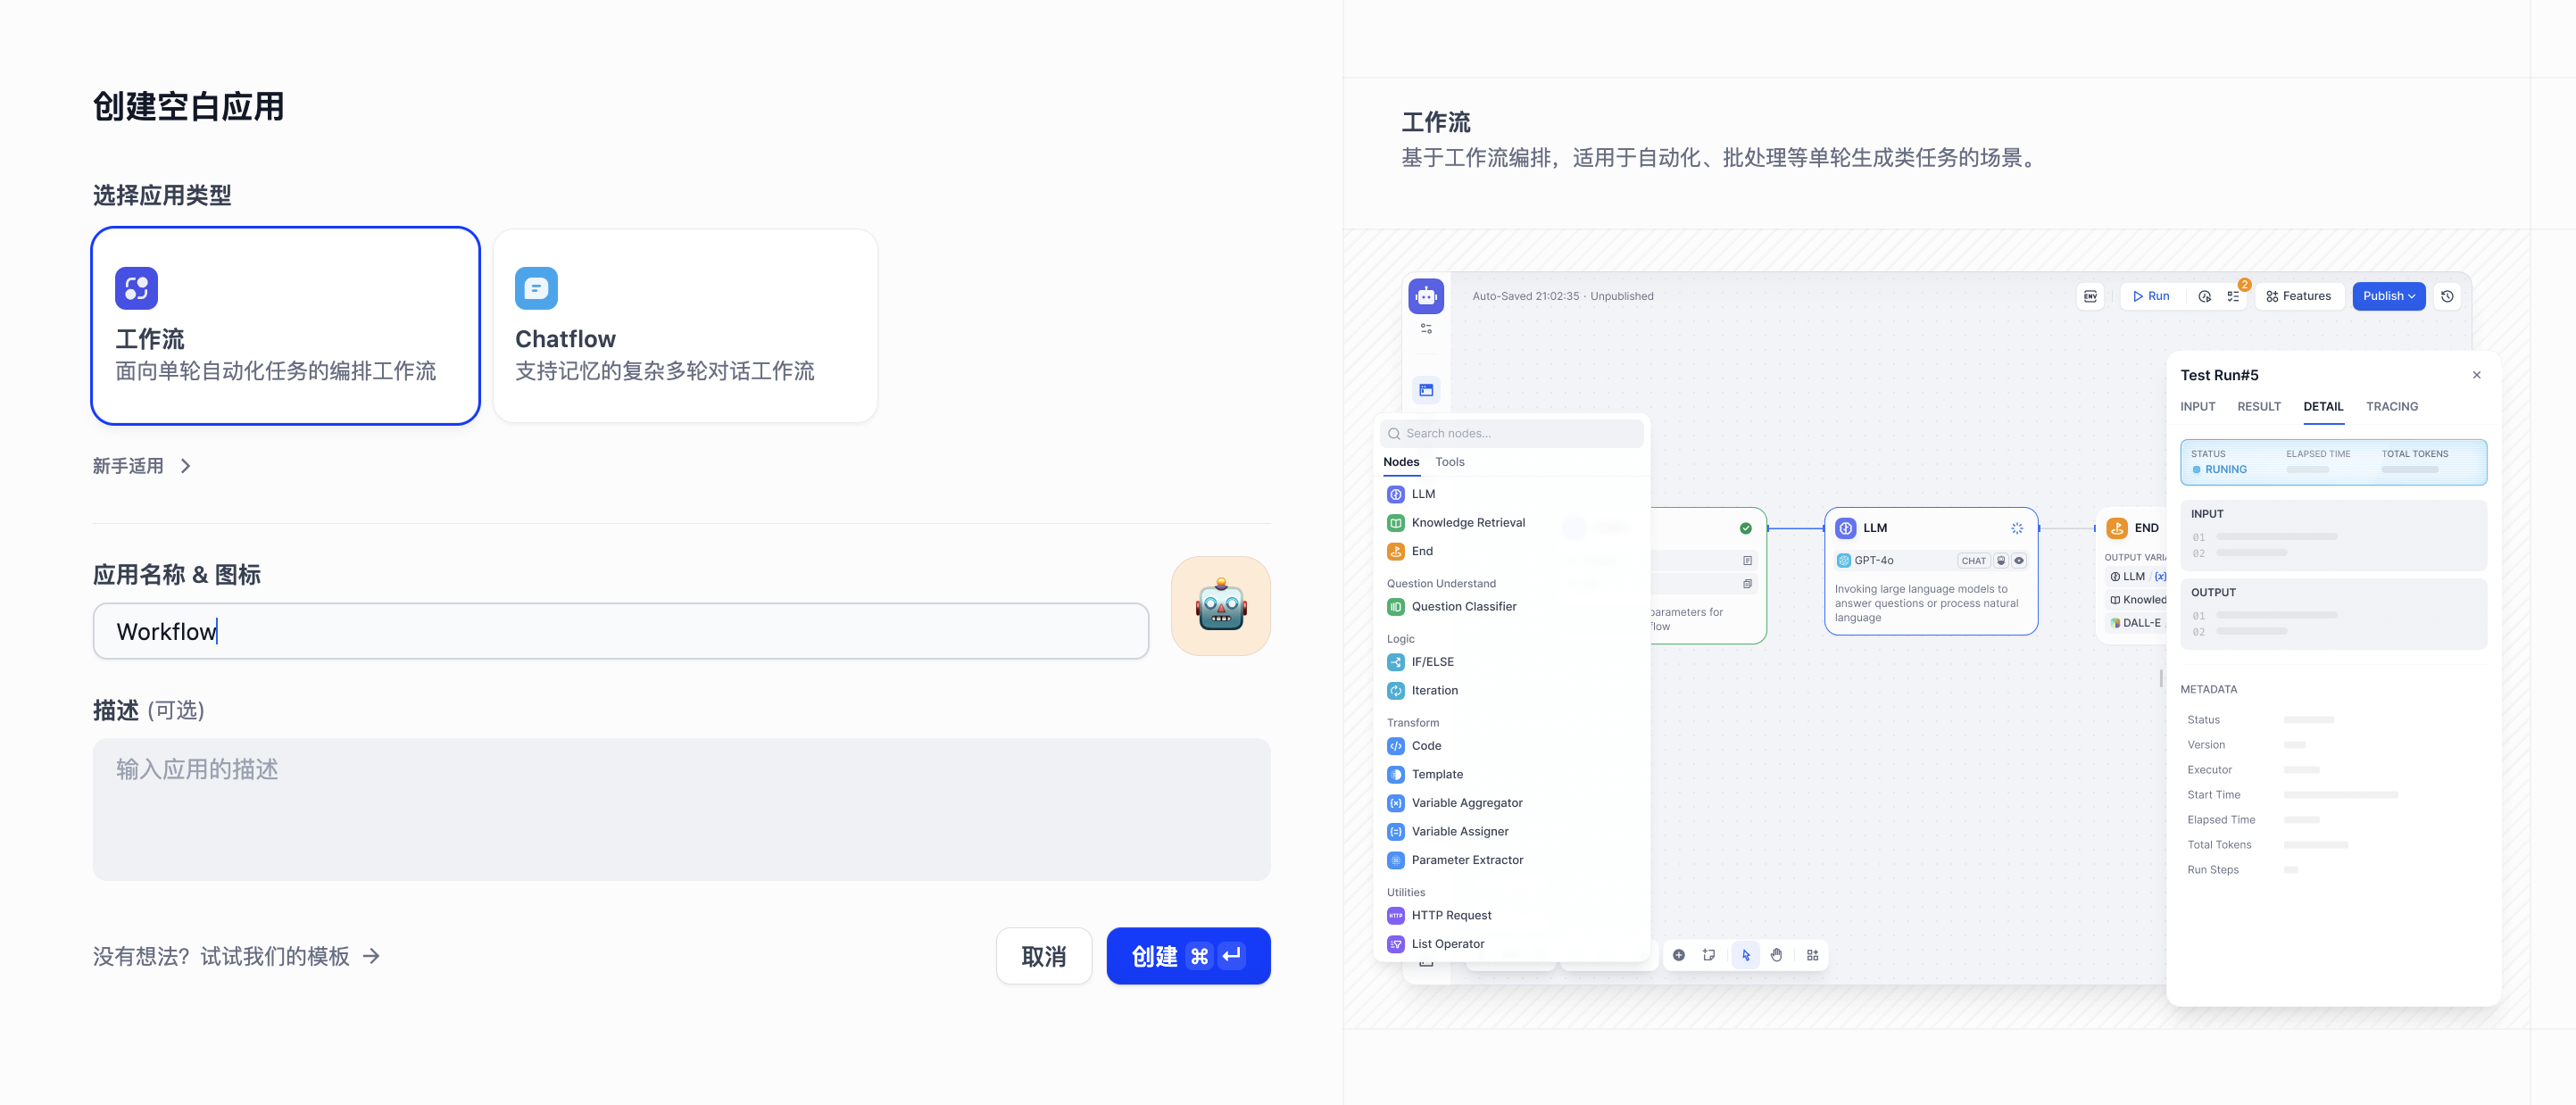 创建工作流
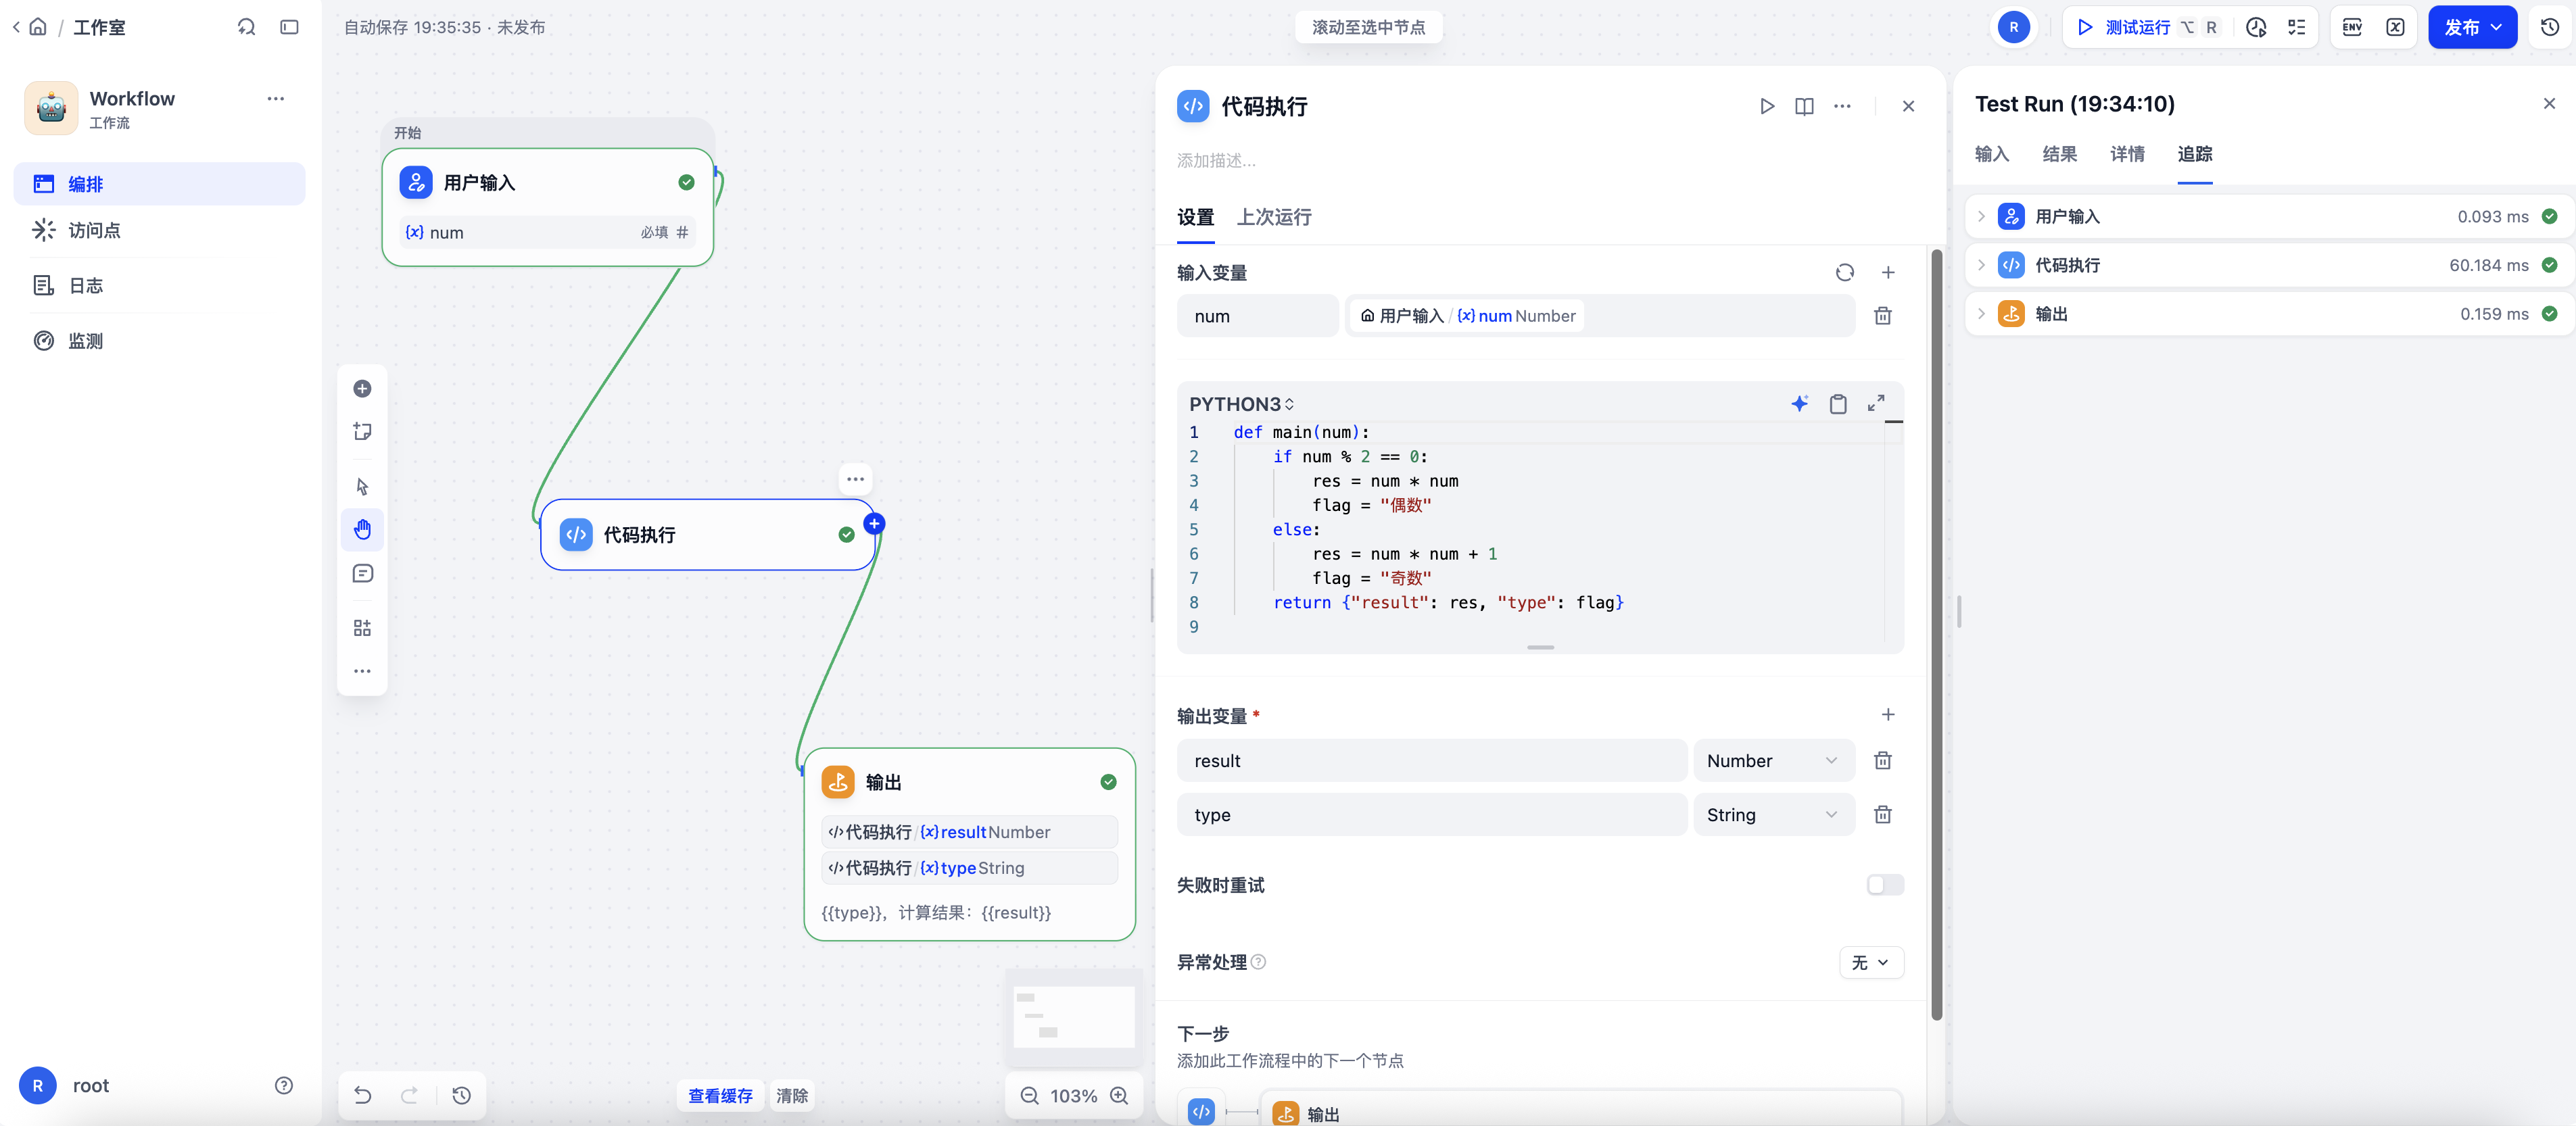 创建工作流:代码节点
Chatflow对话流(业务分类路由,适合客服场景)
目标:测试对话里动态路由,问题分类,不同问题走不同分支。
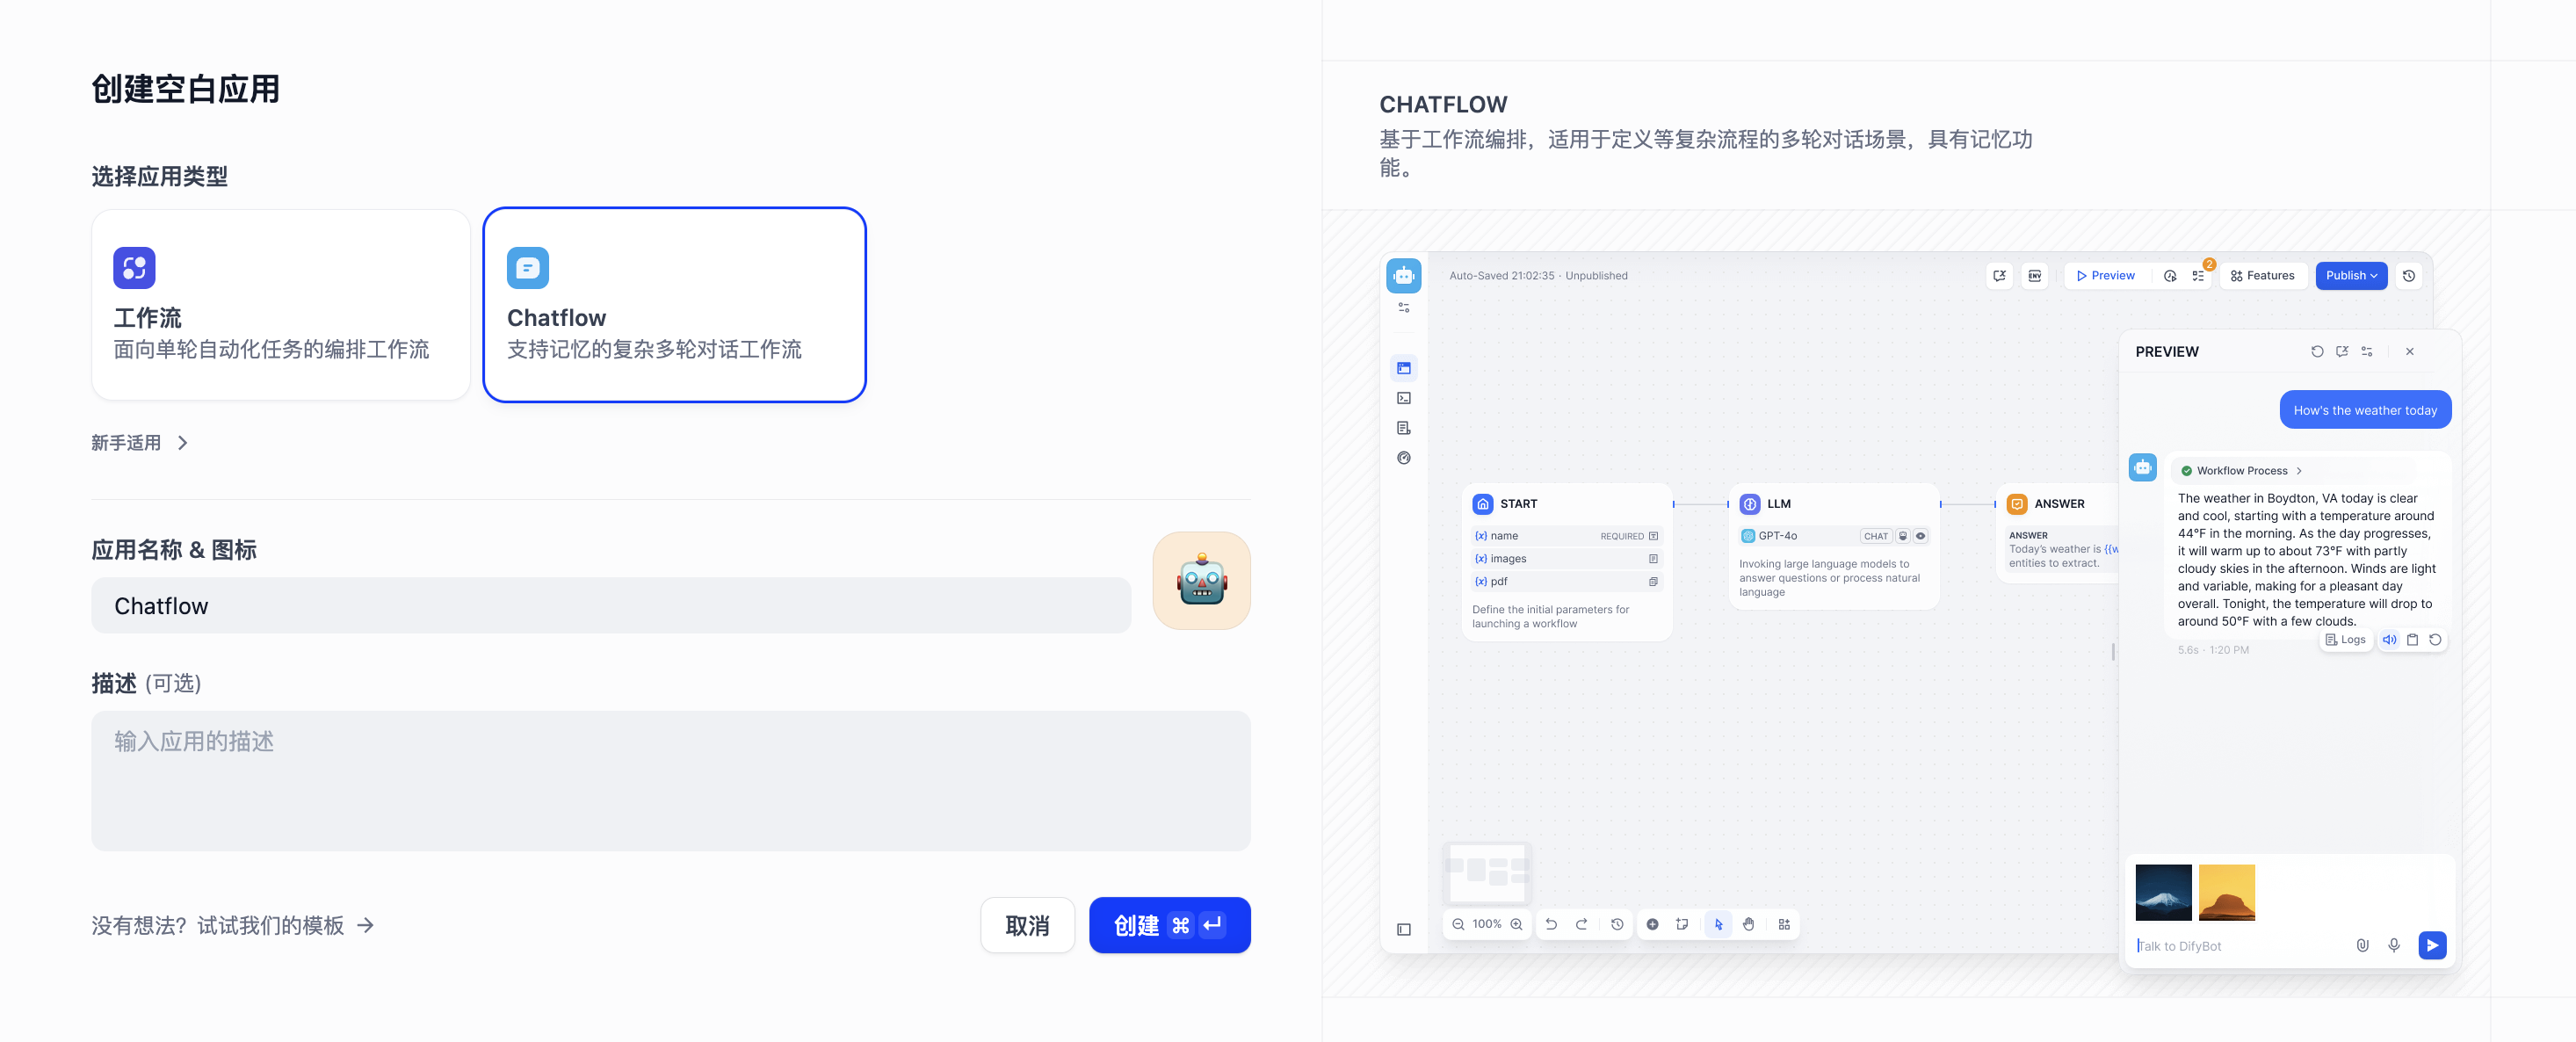 创建Chatflow
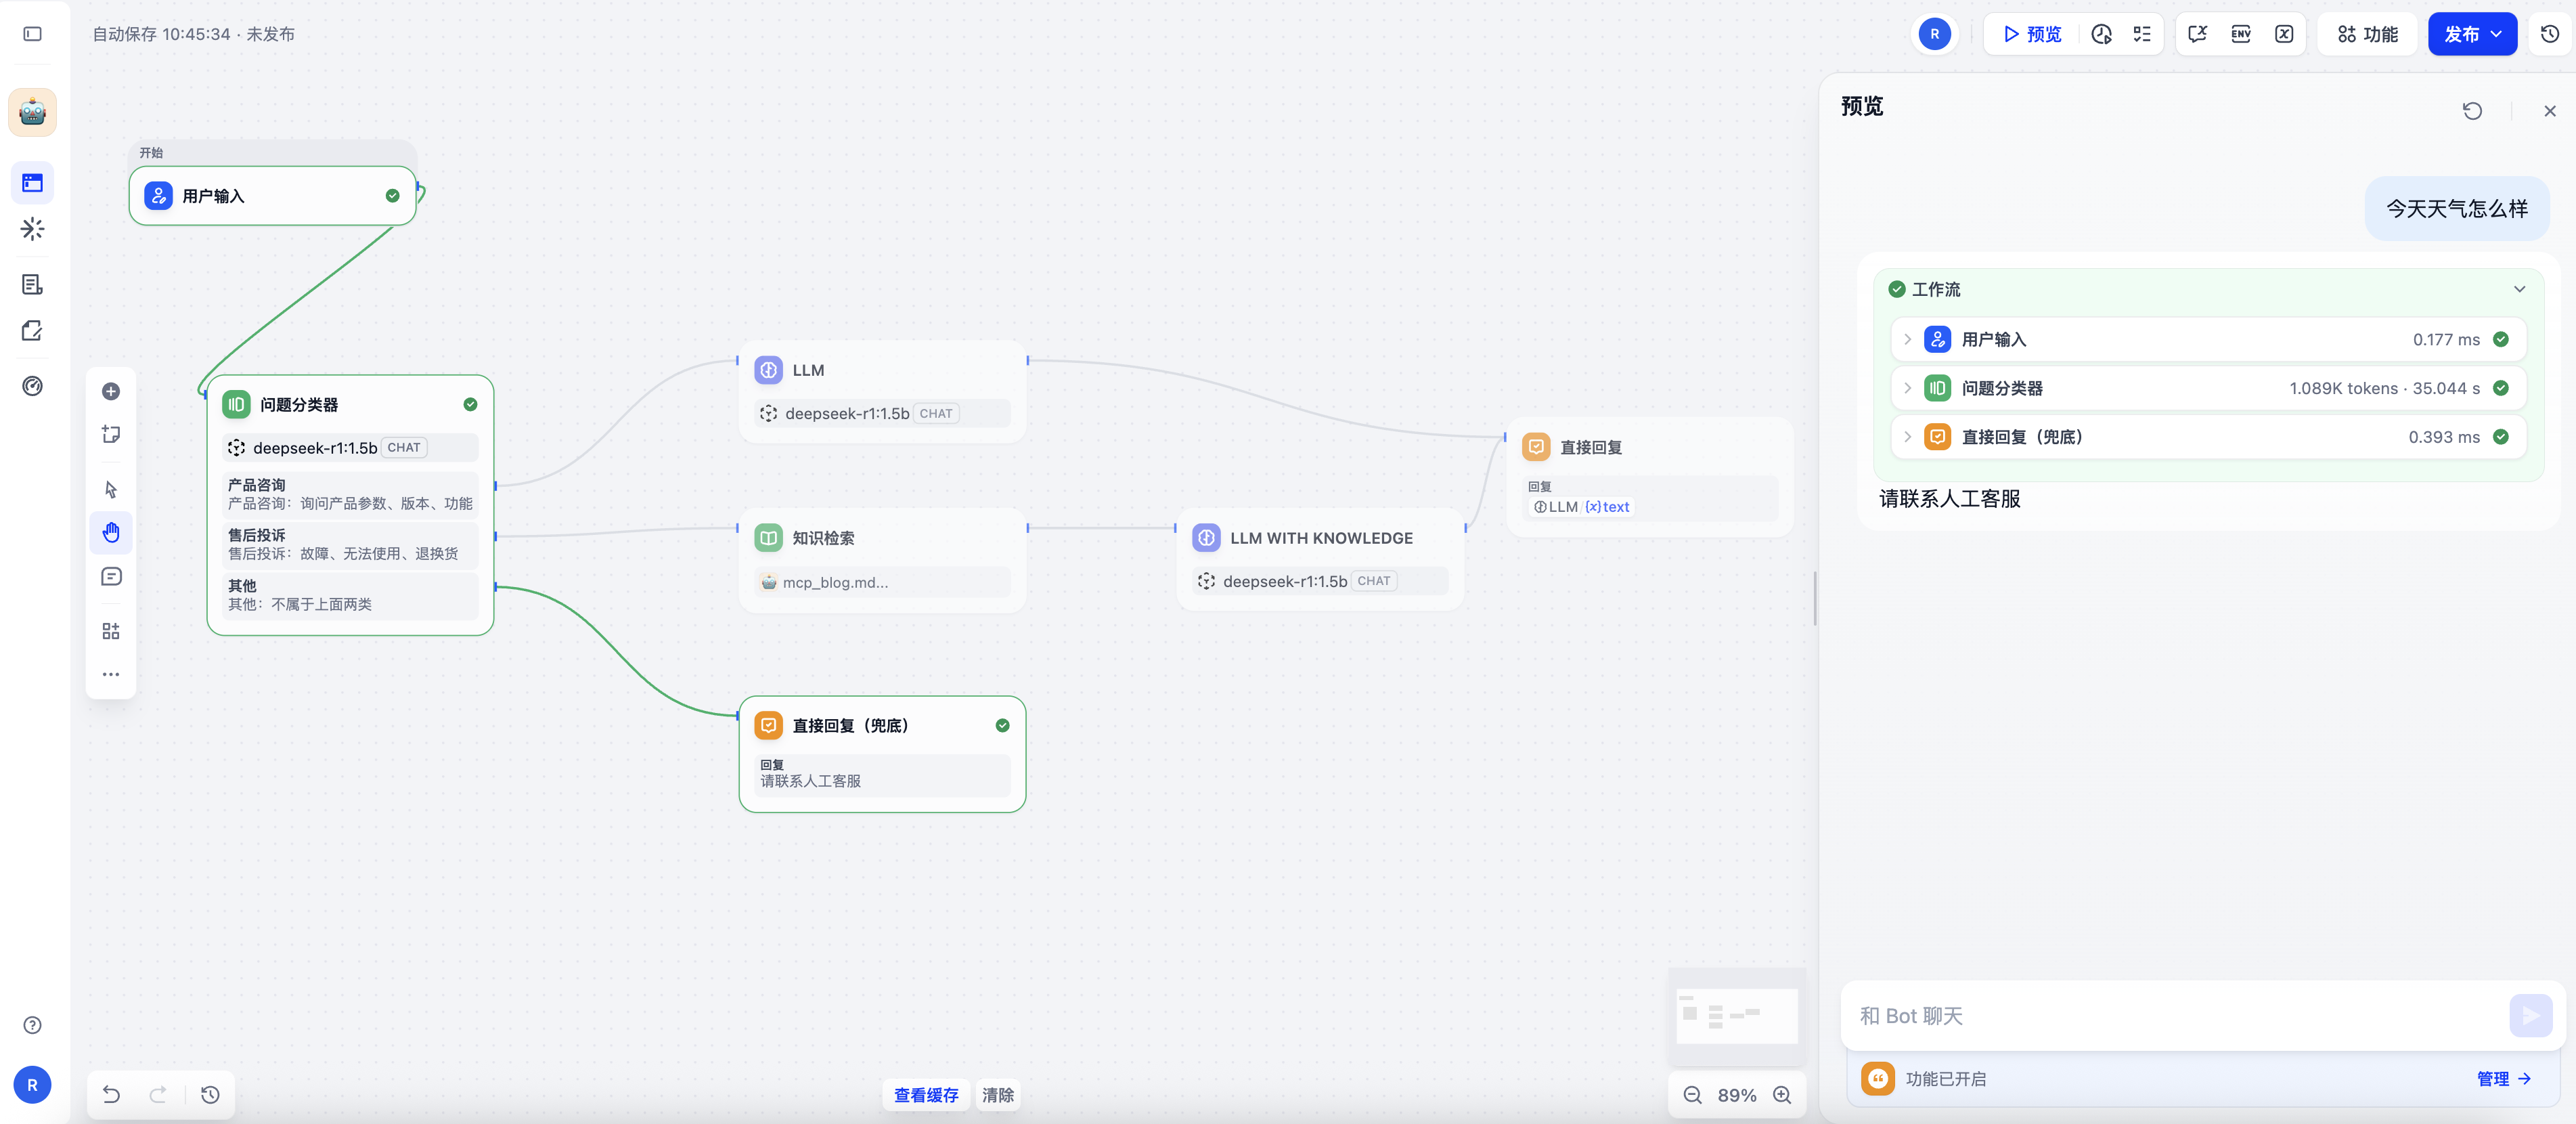 创建Chatflow:流程测试
特点:每个LLM节点可以独立选不同模型,比如一个工作流可以同时调用通义千问、DeepSeek两个模型。
Agent智能体(工具调用,ReAct模式)
目标:测试Agent自主思考、工具选择调用。
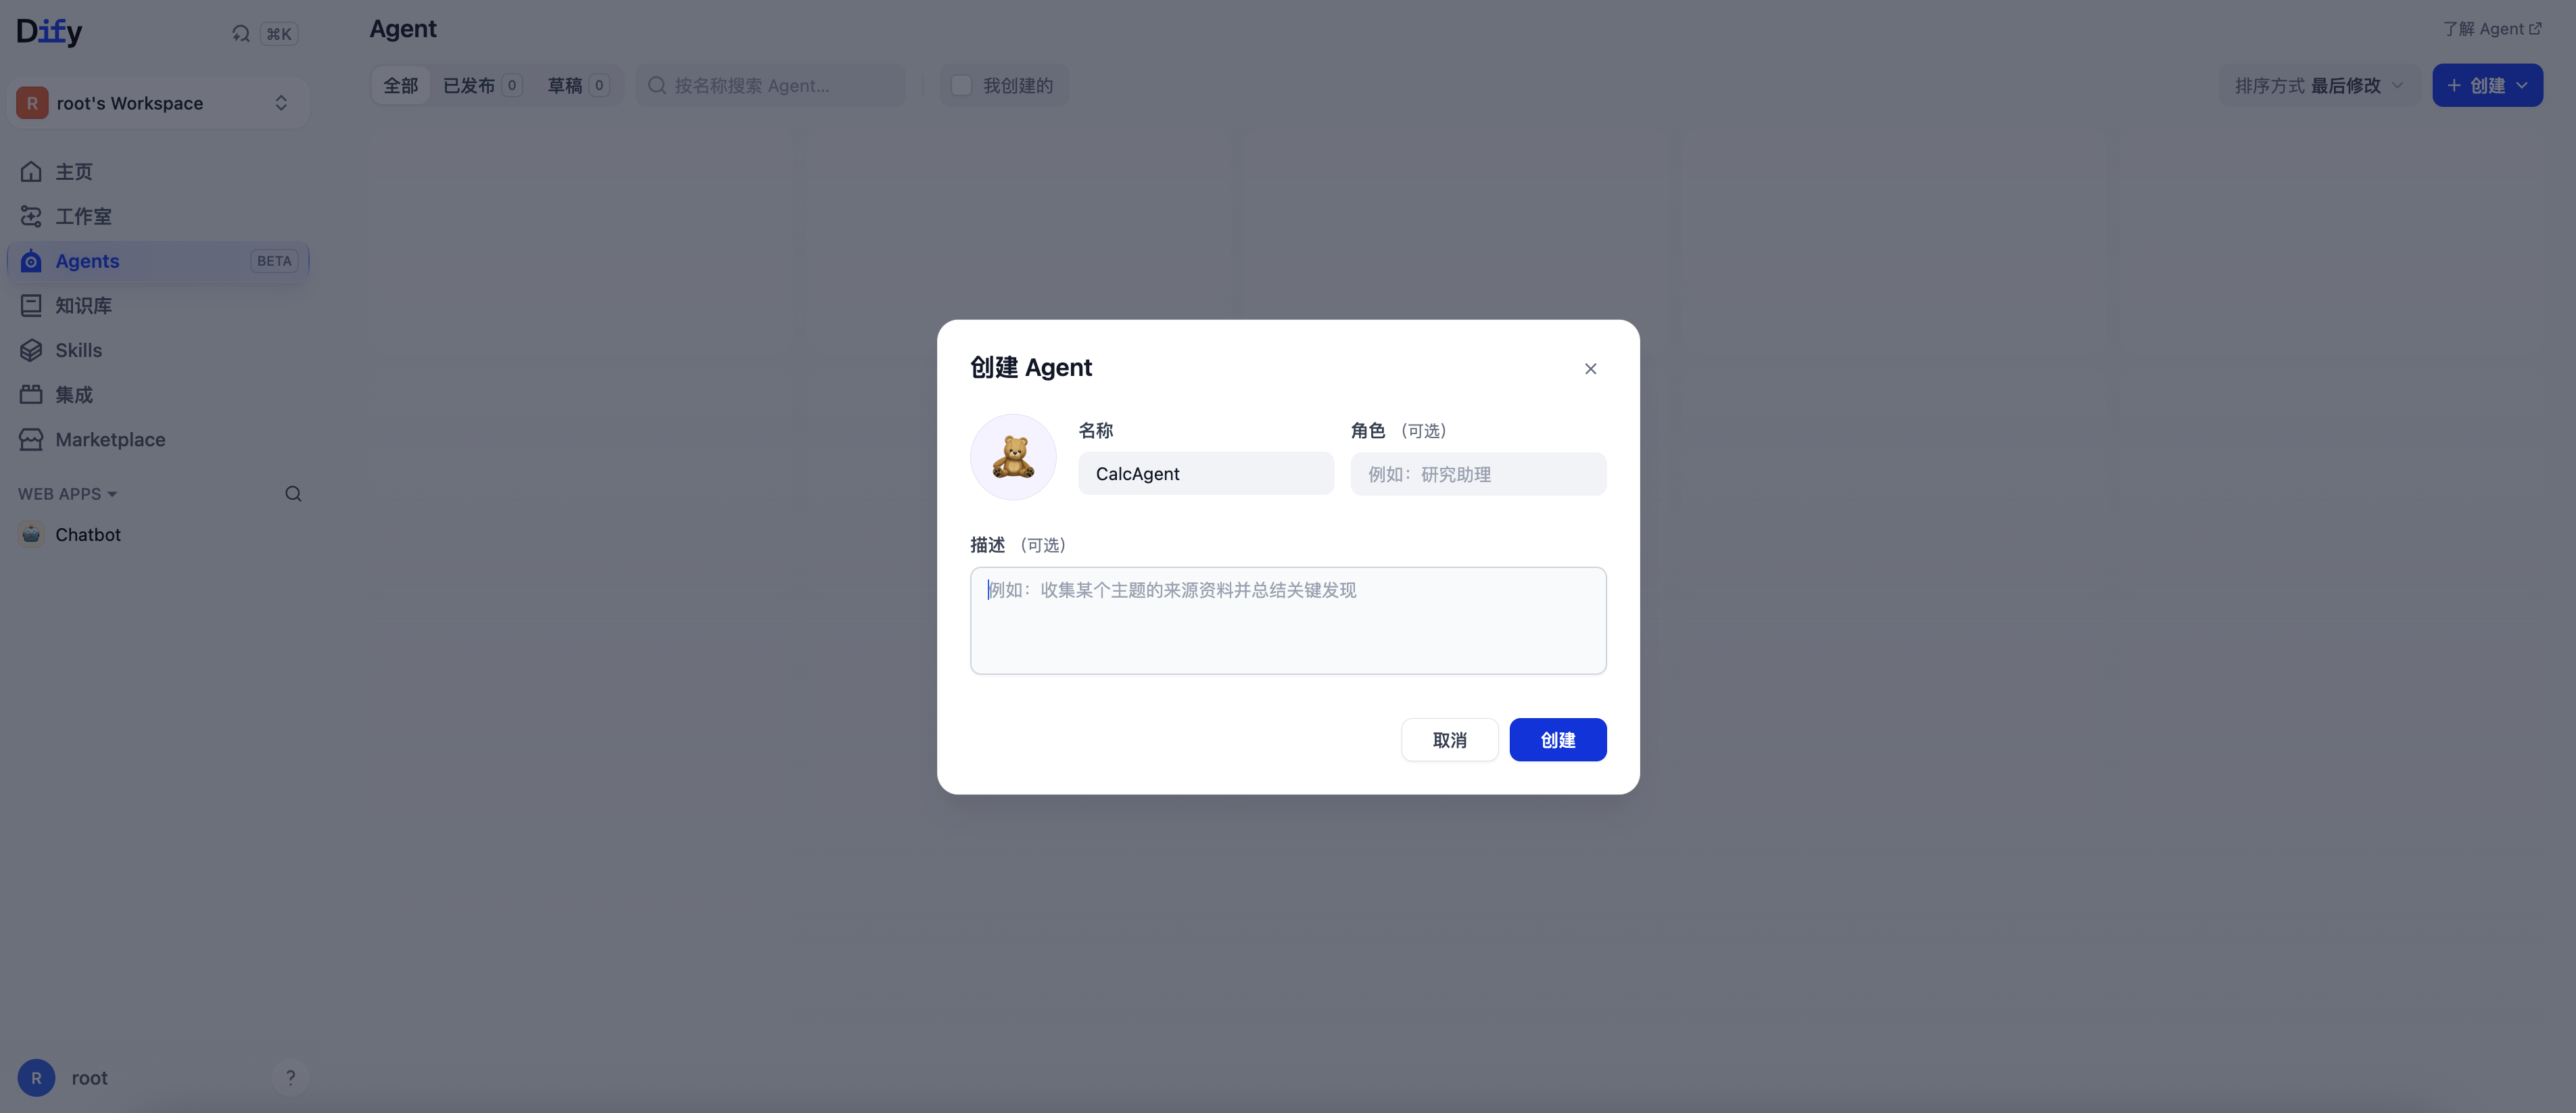 创建Agent
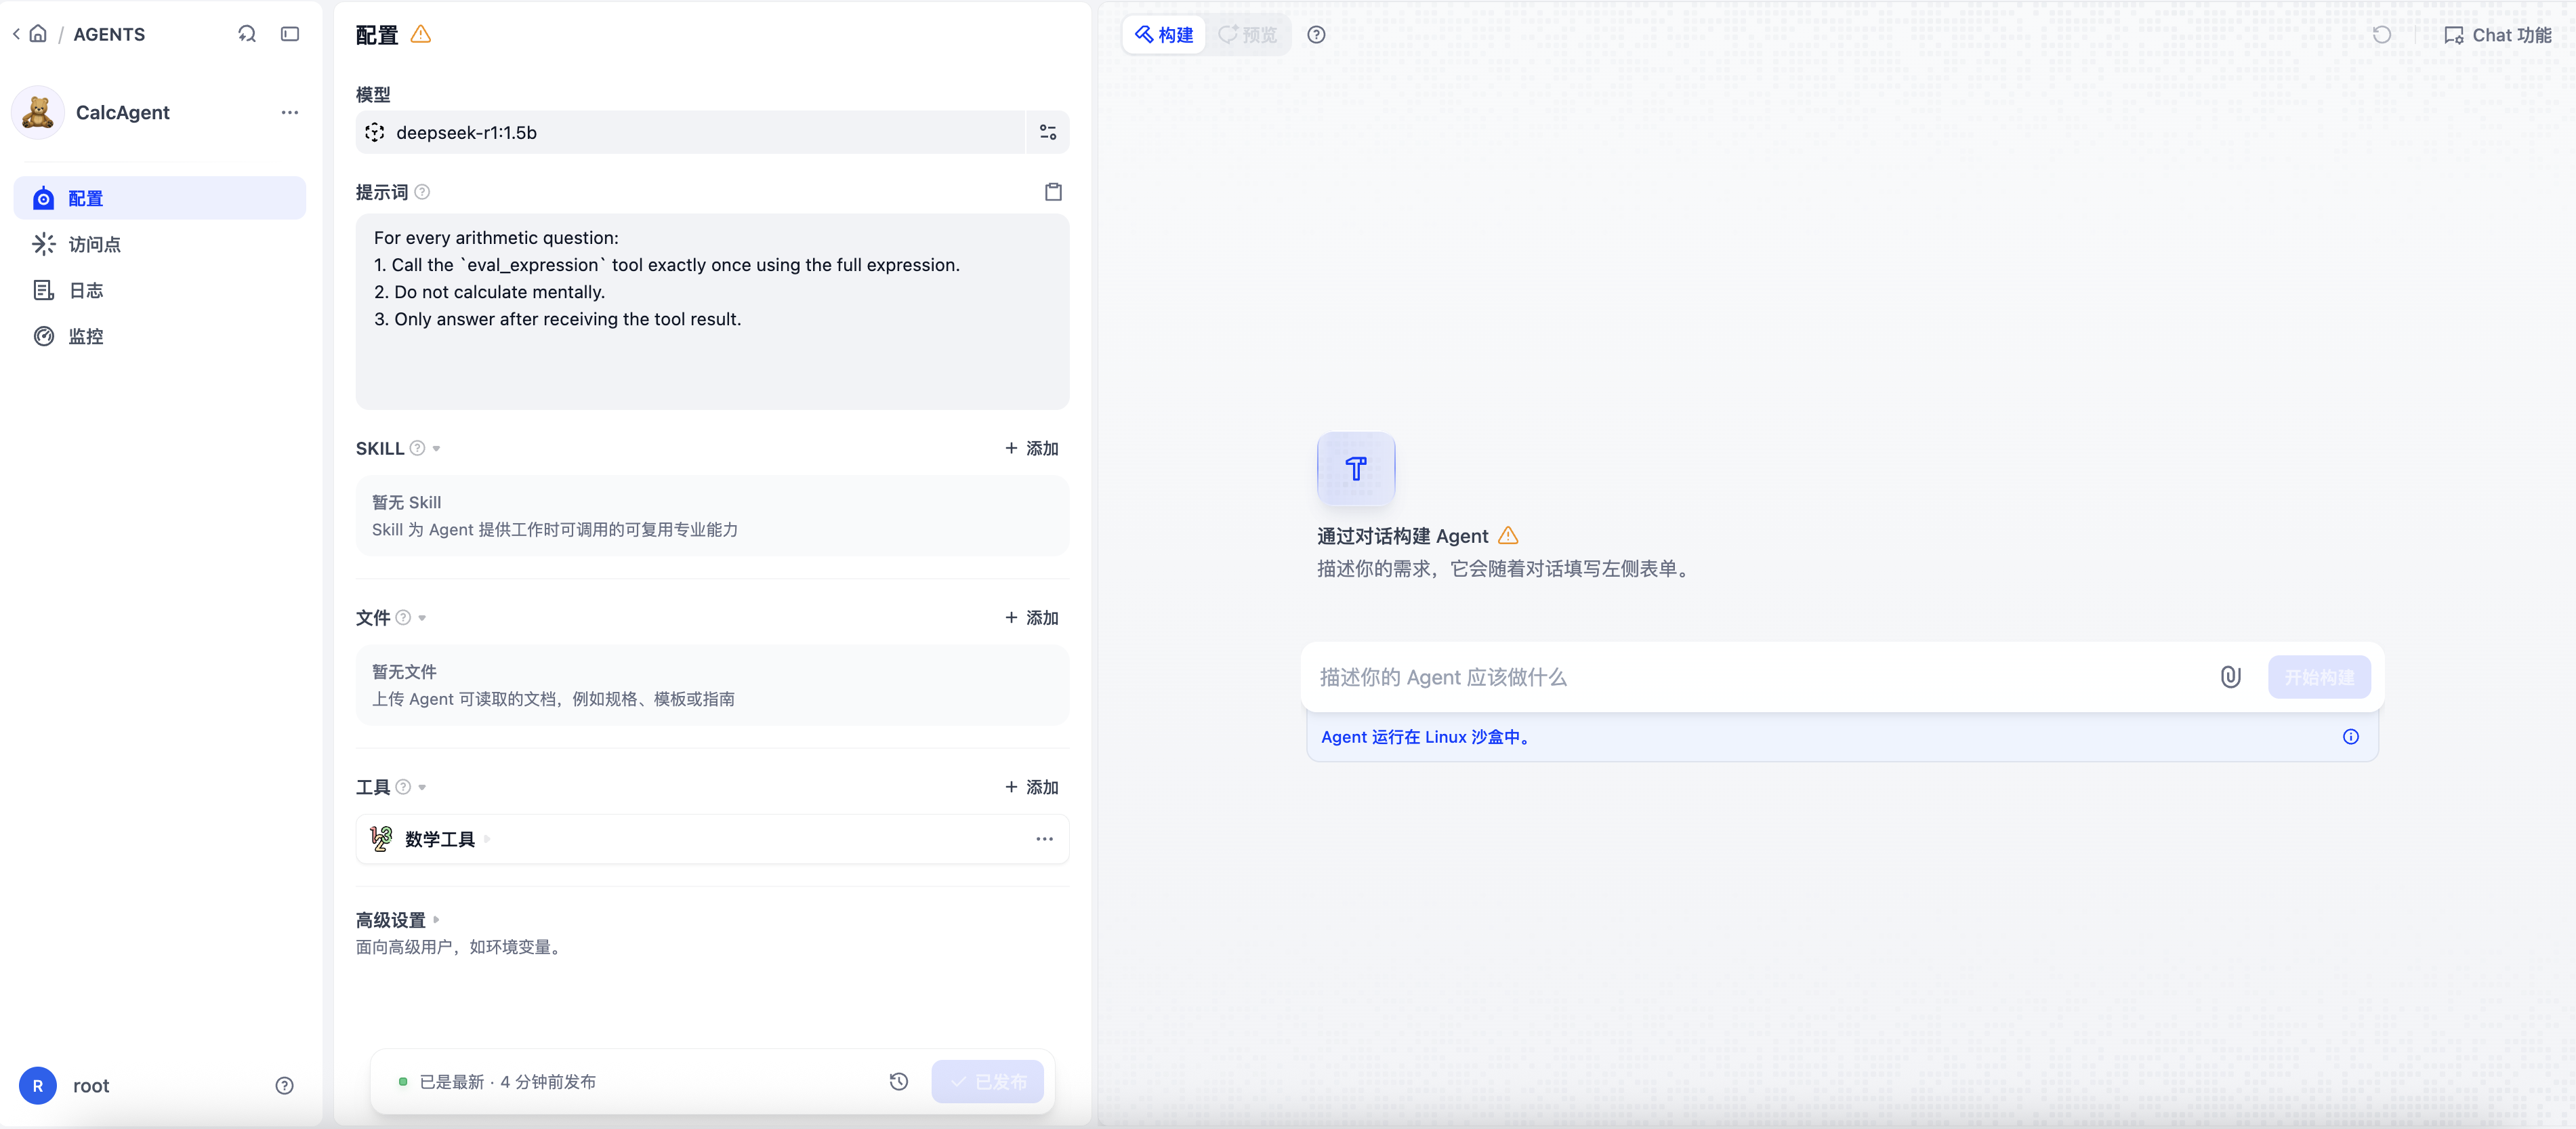 创建Agent
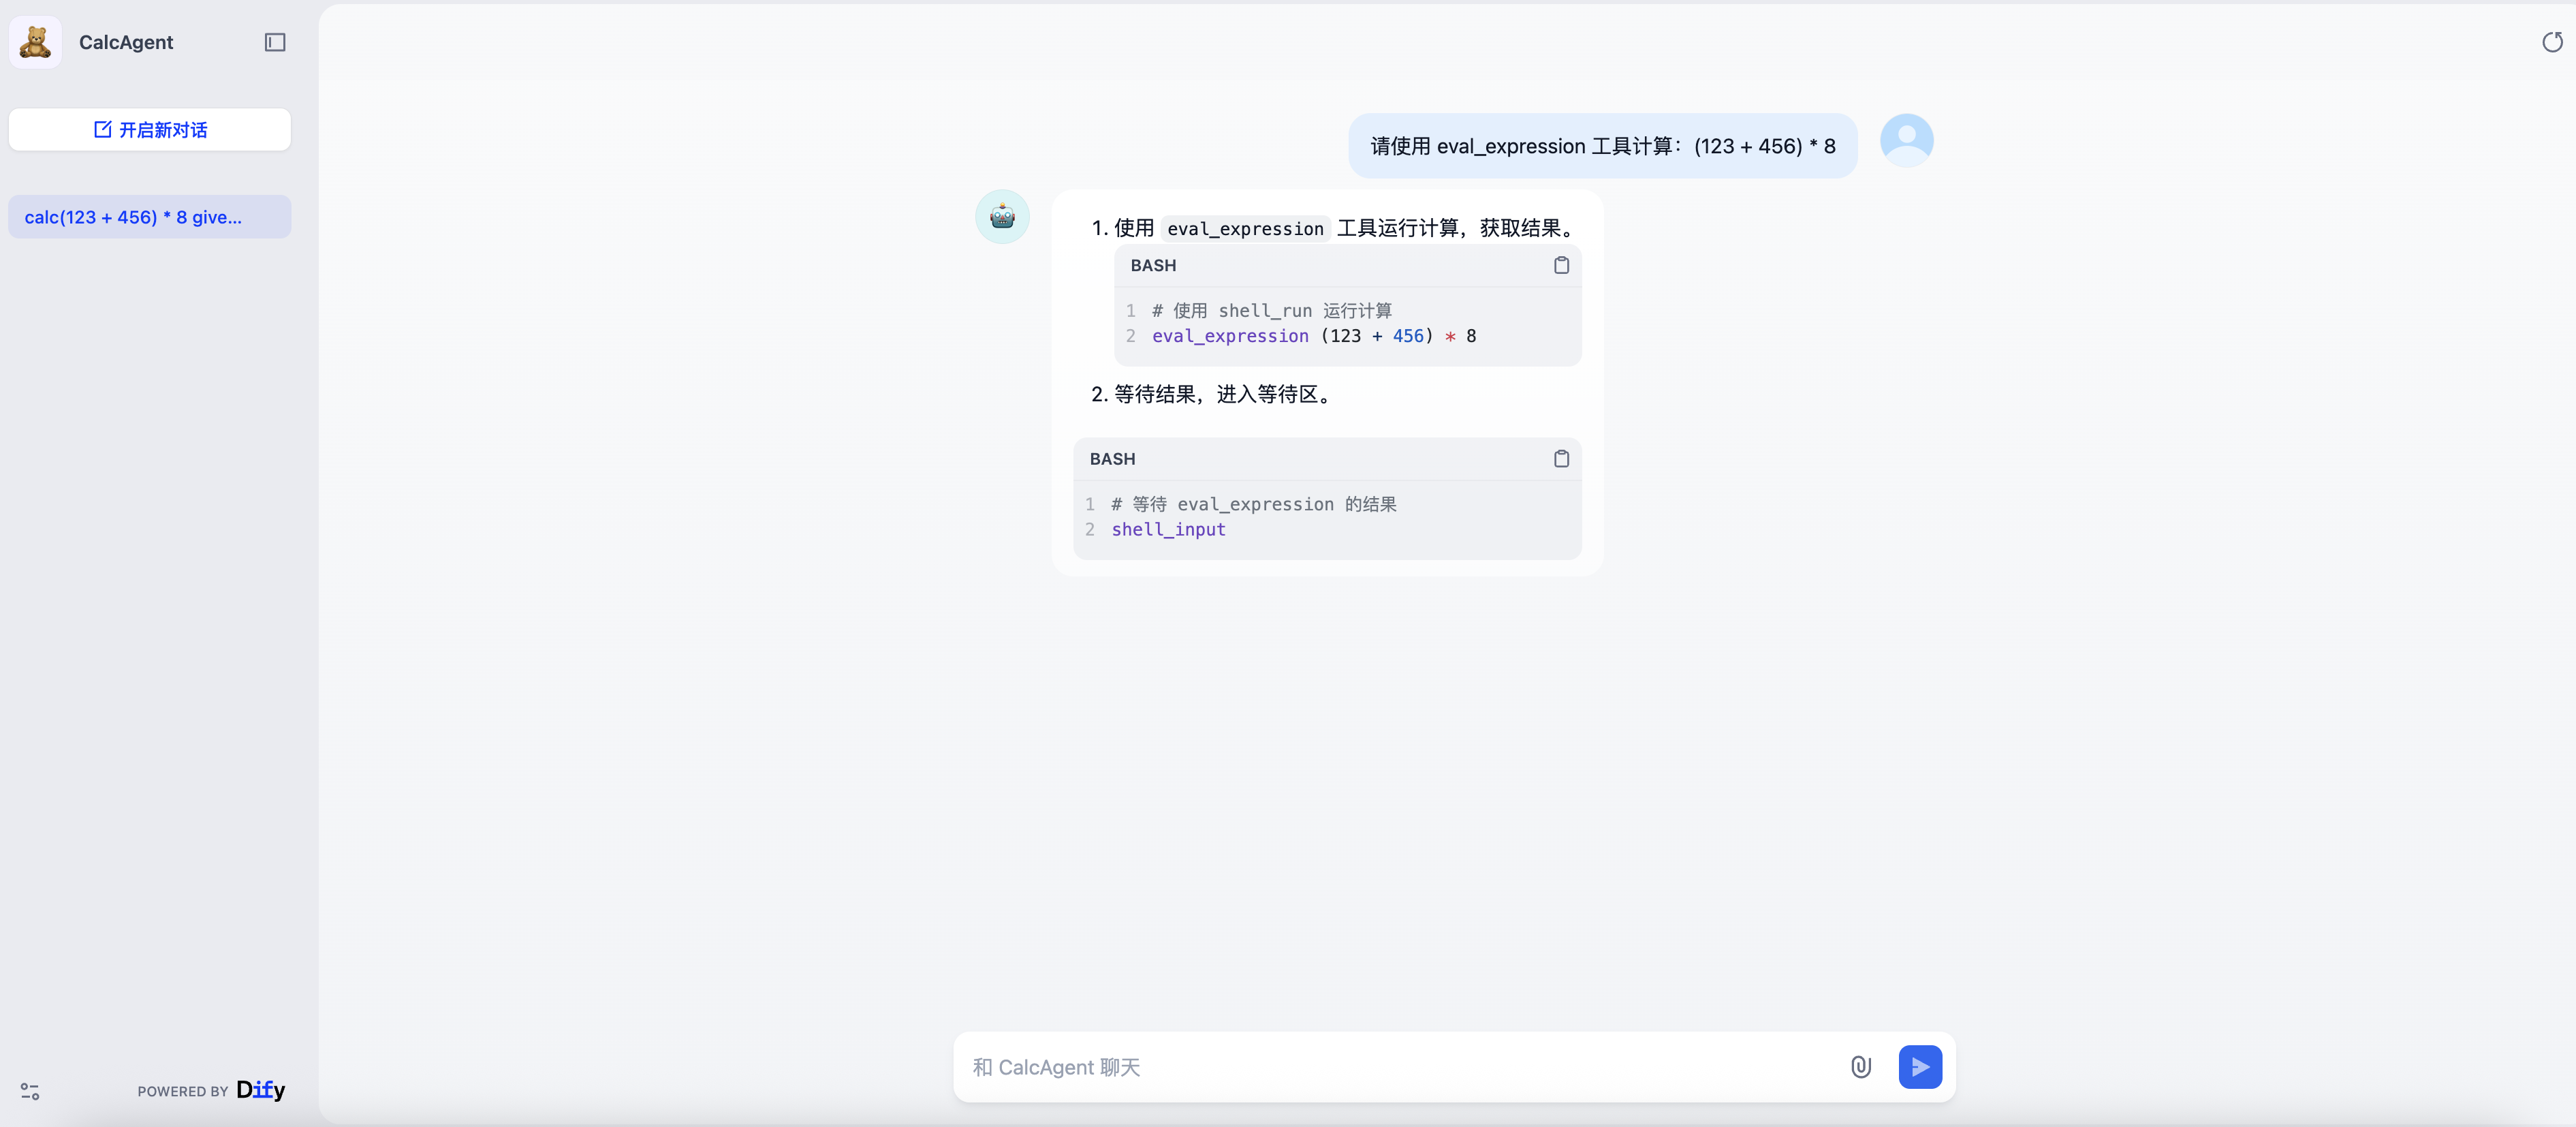 创建Agent
常见坑点
RAG更换Embedding模型:向量库内已经存储旧向量,直接换会检索异常,需要重新文档切片;Ollama跨主机访问:默认仅允许localhost,需要配置OLLAMA_HOST=0.0.0.0;- 多模态模型:必须选择支持图片输入的
LLM(如qwen-vl),普通文本模型无法识别图片;- 温度参数:做
Agent工具调用、RAG问答,温度建议调低(0.1~0.3),减少模型瞎编幻觉;文案创作调高0.7~0.9。
参考
附录
Dify作为模型网关,模型调用的底层实现
Dify模型网关模块使用Python开发,作为LLM请求代理层,
- 前端提交请求 →
Dify后端模型网关; - 读取该应用/节点配置的供应商、模型名称、
api-key、endpoint、参数; - 组装成厂商标准
API请求(自动适配OpenAI/千问/文心一言等不同协议); HTTP转发请求给模型服务;支持流式SSE返回;- 同时记录
token消耗、耗时、错误日志;失败自动重试; - 返回模型结果给前端。
核心能力
- 统一模型抽象层:不管哪家大模型,
Dify内部统一封装,上层应用(Chatbot/Workflow/Agent)不用关心底层模型API差异;- 模型路由、限流、
token统计、失败重试、日志监控;- 支持多模型混用,一个工作流内多个节点使用不同模型。
Dify不承载模型权重,也不做GPU推理。它把模型调用封装成统一接口,再通过plugin_daemon转交给各模型供应商插件;插件最终请求OpenAI、Anthropic、Gemini,或Ollama、vLLM等自托管推理服务的HTTP API。
调用链大致如下,
1
2
3
4
5
6
7
用户请求 / 工作流节点
  -> API组装Prompt、记忆、知识库上下文
  -> ModelInstance.invoke_llm()
  -> 模型Provider插件运行时
  -> plugin_daemon
  -> OpenAI/Ollama/vLLM/其他模型服务API
  -> 流式结果逐段返回给前端
以Chatbot为例,./api/core/app/apps/chat/app_runner.py会先组合系统提示词、用户问题、历史消息和RAG检索上下文,随后调用统一入口,
1
2
3
4
5
6
7
model_instance.invoke_llm(
    prompt_messages=prompt_messages,
    model_parameters=model_config,
    stop=stop,
    stream=stream,
    request_metadata=request_metadata,
)
这个model_instance定义在./api/core/model_manager.py。它负责根据当前工作区配置找到,
Provider,例如openai、ollama、anthropic;- 模型,例如
gpt-4o、qwen2.5、llama3; - 相应凭据、模型参数、能力信息;
- 负载均衡、额度与用量统计等。
然后将标准化后的参数转交给,
1
self.model_type_instance.invoke(...)
实际的桥接实现位于./api/core/plugin/impl/model_runtime.py。它不仅处理LLM,也用同一套机制处理embedding、rerank、TTS、语音识别和内容审核。
API并不直接在Python中为每家厂商写请求逻辑,而是经由Plugin Daemon。其HTTP通信实现可见./api/core/plugin/impl/base.py,使用httpx请求Plugin Daemon,并分别处理普通响应和流式响应。当前Docker配置中./docker/.env指向,
1
PLUGIN_DAEMON_URL=http://plugin_daemon:5002
即api容器请求Compose内部的plugin_daemon容器;Daemon根据已安装的Provider插件,用该工作区配置的凭据和endpoint请求外部模型。
所以责任划分是,
Dify API(Python):Prompt构造、会话记忆、RAG、工作流/Agent编排、日志、权限、SSE返回;plugin_daemon(独立服务):加载和执行模型供应商插件,适配不同厂商协议;- 模型服务:真正执行推理。可以是云端
API,也可以是你部署的Ollama/vLLM;后者才需要实际的模型权重和GPU。
Dify的价值在于,把不同模型的鉴权、请求格式、流式协议、工具调用、错误类型、token用量等差异统一起来,让上层Chatbot、Workflow、Agent不必绑定某一家模型厂商。
ChatBot、RAG、Workflow、Agent、Chatflow
这些能力不是五套独立程序,而是同一套Dify平台能力的不同编排方式,把不同节点、数据和运行方式组合起来。上面Dify源码部署的主语言和组件如下,
1
2
3
4
5
6
7
8
浏览器
  -> TypeScript / React / Next.js 前端
  -> Python / Flask API
       -> LLM 供应商或模型插件
       -> MySQL:业务、会话、工作流、运行记录
       -> Redis:队列、缓存、实时任务
       -> Milvus:知识库向量
       -> Sandbox:代码隔离执行
- 后端以
Python 3.12为主,使用Flask API、Gunicorn/gevent、Celery后台任务、SQLAlchemy和Graphon图执行引擎; - 前端是
TypeScript、React、Next.js,工作流画布使用React Flow; - 当前数据层:
MySQL存应用、会话、工作流和文档元数据;Milvus存向量; - 可见
API依赖./api/pyproject.toml、Web依赖./web/package.json; - 在工作流的
Code节点中可写Python 3或JavaScript,由sandbox容器隔离执行,不是在API容器内直接执行; Dify本身不训练或实现大模型,它负责把提示词、上下文、工具调用和模型供应商API串起来。
| 应用类型 | 核心语言 | 核心引擎 | 是否会话记忆 | 控制权 | 实现原理 |
|---|---|---|---|---|---|
Chatbot基础对话 | Python+TS | LLM会话封装 | ✅ | 模型,仅靠提示词 | 将系统提示词、用户输入、历史消息、可选文件组装成模型消息,调用模型并以流式响应返回。会话和消息保存在MySQL;对话记忆由TokenBufferMemory按模型token上限截取和加载历史,而不是无限保留所有消息。 |
RAG知识库问答 | Python | RAG检索管线 | ✅(依附Chatbot) | 检索+模型 | 文档上传后异步提取文本,按规则切片,调用Embedding模型生成向量,写入Milvus。提问时把问题向量化,检索相近片段,可做关键词/混合检索与rerank;命中的片段连同文档、段落等元数据注入Prompt,因此能返回引用来源。 |
Workflow工作流 | Python+TS | DAG图引擎 | ❌ | 开发者预先定义固定流程 | 前端将画布保存为节点和边的图配置;后端校验后用Graphon构建DAG,并维护变量池。引擎按照依赖运行节点,条件节点选择分支,LLM、HTTP、知识检索、工具、代码等都是节点。代码节点将代码和输入发送给Sandbox的/v1/sandbox/run隔离执行。 |
Agent智能体 | Python+Go插件 | ReAct/FunctionCall循环 | ✅ | 大模型自主选择工具和步骤 | 经典模式是ReAct循环:Thought -> Action -> Observation -> 下一轮。模型选择工具,Dify通过Tool Engine/Plugin Daemon调用,再把工具结果作为Observation放回上下文,直到模型给出最终答案或达到最大迭代次数。较新的Agent能力还使用独立的Python Agent Backend和受隔离工作区。 |
Chatflow对话流 | Python+TS | DAG图引擎(会话增强) | ✅ | 开发者定义分支,每轮消息完整跑图 | 本质是带会话语义的Workflow。它同样运行图,但会额外保存conversation_id、消息历史和会话变量,并将节点事件转为聊天流式输出。客服分类路由只是其常见用法:可用确定性的If/Else,也可用LLM的问题分类器,路由到不同知识库、不同模型或不同回答节点。 |
几个关键源码入口,
- 普通
Chatbot的提示词、记忆和知识库检索串联在./api/core/app/apps/chat/app_runner.py; RAG的切片、索引、检索和向量库适配在./api/core/rag;Workflow的图引擎入口是./api/core/workflow/workflow_entry.py;Chatflow对应的Advanced Chat Runner也是以WorkflowEntry驱动,见./api/core/app/apps/advanced_chat/app_runner.py;ReAct Agent的迭代和工具执行逻辑在./api/core/agent/cot_agent_runner.py。
所以可把它理解为,
Chatbot=Prompt + MemoryRAG=Chatbot/Workflow+ 知识检索Workflow= 无状态或弱状态的可视化DAG编排Agent= 模型驱动的工具调用循环Chatflow= 带会话记忆和聊天输出的Workflow
基础Chatbot
控制台操作
- 配置模型供应商和模型;
- 创建应用,选择
Chatbot; - 配置系统提示词、模型参数、开场白和上下文记忆;
- 发布后在
Web App或API中发送多轮消息。
运行链路:
1
2
3
4
用户问题 + 系统提示词 + 最近对话历史
  -> LLM
  -> 流式回答
  -> 保存 Message / Conversation
实现入口在./api/core/app/apps/chat/app_runner.py和./api/core/memory/token_buffer_memory.py。
- 用户发送消息,
Dify后端从MySQL读取当前conversation_id对应的历史消息列表; - 把系统提示词 + 历史对话消息 + 用户当前提问拼接成完整消息数组,转发给大模型
API; - 模型返回内容(支持流式
Socket.IO),Dify把本轮问答存入数据库,保存到这个conversation会话下; - 记忆窗口配置:后端做截断逻辑,当历史消息
token超过阈值,自动丢弃最早消息,控制上下文长度。
本质:只是对
LLM API做会话封装,没有编排引擎,没有节点。
记忆不是模型自己记住,是Dify数据库保存历史,每次请求塞到prompt里传给大模型。
链路:用户输入 → 加载会话历史 →prompt组装 → 调用LLM→ 保存本轮消息 → 返回结果。
RAG知识库问答
控制台操作
- 创建知识库,上传
PDF、Word、Markdown、网页等; - 设置切片规则,例如
chunk长度、重叠长度、分段方式; - 选择
Embedding模型,等待索引完成; - 在
Chatbot中关联知识库,或在Workflow/Chatflow中加入知识检索节点; - 开启引用与归属,调节
Top K、相似度阈值、混合检索和Rerank。
运行链路:
1
2
3
4
5
6
文档 -> 文本提取 -> 切片 -> Embedding -> Milvus

问题 -> Embedding -> Milvus 相似度检索
     -> 可选关键词检索 / Rerank
     -> 命中文本片段 + 来源元数据 -> LLM Prompt
     -> 回答 + 引用来源
Milvus保存向量和检索索引;MySQL保存文档、切片、数据集及来源关联。引用溯源来自命中片段携带的文档/段落元数据,并不代表模型的每一句话都能被自动严格证明。
相关实现位于./api/core/rag,分为两个阶段:文档入库阶段、用户查询阶段
- 文档入库(异步
Celery任务)- 文件上传 → 文本提取(
PDF/Word等)→ 文本清洗 →Chunk切片; - 调用
Embedding模型,每个chunk转为向量; - 向量+原文+元数据存入向量数据库。
- 文件上传 → 文本提取(
- 用户提问阶段(
Chatbot绑定知识库)- 用户问题 →
Embedding生成问题向量; - 混合检索:向量相似度检索 + 关键词检索,召回
TopK片段; - 可选:
Rerank重排模型,对召回结果重新打分过滤; - 将检索到的原文片段,注入提示词上下文,一起发给
LLM; LLM生成回答,Dify绑定原文引用标记,前端展示引用来源。
- 用户问题 →
核心:不修改大模型,在调用
LLM之前增加检索步骤,私有知识作为上下文增强。
两种使用形态:
Chatbot应用绑定知识库(无画布);Workflow/Chatflow里调用知识库检索节点。
Workflow
控制台操作可以搭一个最小案例:
1
2
3
4
5
Start
  -> LLM
  -> If/Else 或 Question Classifier
  -> Code
  -> End
If/Else:根据变量作确定性条件分支;Question Classifier:让LLM把问题分到预设类别;Code:做字段清洗、价格计算、JSON重组等;LLM:生成分类后的业务回答;End:定义API或页面最终输出。
画布保存的是节点、连线和配置组成的JSON图。后端将其校验为DAG,建立变量池,并按依赖执行节点;条件节点决定下游路径。工作流引擎入口在./api/core/workflow/workflow_entry.py。Code节点会调用Sandbox的/v1/sandbox/run,其请求逻辑在./api/core/helper/code_executor/code_executor.py。
实现选型
- 后端
Graph引擎:Python(自研GraphEngine) - 前端画布拖拽:
TypeScript + React Flow - 代码节点执行:用户写的
Python代码在独立沙箱服务运行(隔离环境,防止安全风险)
Workflow的本质:DAG有向无环图执行引擎
- 前端拖拽节点连线,保存为
JSON DSL(描述节点、边、变量); - 触发执行时,后端
GraphEngine加载这份DSL,解析节点依赖关系,生成执行拓扑; - 按拓扑顺序串行/并行执行节点:
LLM节点、HTTP节点、条件分支If-Else、代码节点; - 节点之间通过全局上下文变量传递数据;每个节点输出写入上下文,下游节点读取;
- 执行结束返回结果;默认无会话记忆,每次调用都是全新上下文,不会保存历史。
流程是固定写死的路径,人提前定义好分支逻辑;模型无权决定下一步走哪个节点,节点执行顺序由
DAG拓扑决定,不是模型自主决策。
Agent智能体
控制台中可创建Agent,或在Workflow/Chatflow中放置Agent节点。配置包括模型、系统指令、知识库、工具/插件、最大迭代次数。
ReAct的实际循环是:
1
2
3
4
5
6
用户问题
  -> LLM 生成 Thought / Action
  -> Dify 调用 Action 指向的工具
  -> 得到 Observation
  -> Observation 回填给 LLM
  -> 重复,直到 Final Answer 或超出最大迭代
工具可能是HTTP API、搜索、数据库、代码执行或插件。工具实现语言不受Dify限制,只要以插件或OpenAPI/HTTP工具方式暴露;Dify负责参数校验、调用、记录和把结果回填给模型。经典ReAct循环在./api/core/agent/cot_agent_runner.py。
实现选型
Agent推理循环:Python;- 工具调用的插件服务:
Go插件daemon
Agent是Chatbot对话应用的增强模式,不是独立应用类型,复用对话会话存储。采用ReAct(Thought-Action-Observation)循环,或者Function Calling:
- 把可用工具定义(工具名称、描述、入参J
SON Schema)一起放进prompt; LLM思考(Thought):判断用户问题是否需要调用工具、调用哪个工具、参数是什么;- 如果决定调用工具:
Dify后端解析模型输出的工具调用指令,执行对应工具(计算器、HTTP、代码沙箱等),拿到返回结果(Observation); - 把工具返回结果放回上下文,再次交给
LLM继续思考;循环直到模型判断不需要工具,可以直接输出最终答案; - 多轮对话会把所有历史思考、工具调用记录全部保存在
conversation会话中。
和
Workflow最大区别
Workflow:人预先固定流程走向;Agent:由大模型动态决定下一步动作、工具、调用顺序。
Chatflow
Chatflow是带会话状态的Workflow,典型客服路由如下:
1
2
3
4
5
Start
  -> Question Classifier
  -> 售前分支:知识检索 -> LLM -> Answer
  -> 售后分支:工具/API -> LLM -> Answer
  -> 人工分支:转人工或创建工单
它和普通Workflow共用图执行引擎,但会额外维护会话历史、conversation_id、会话变量和流式聊天事件。因此更适合客服、多轮引导和业务路由。分类可以是确定性的If/Else,也可以是概率性的LLM分类;生产场景应设置兜底分支。
源码中Chatflow对应Advanced Chat,它同样通过WorkflowEntry执行图,但额外持久化会话变量,见./api/core/app/apps/advanced_chat/app_runner.py。
实现语言
Graph引擎同样是Python;- 前端画布
TypeScript。
Chatflow = 带会话记忆能力的Workflow
- 底层复用和
Workflow完全一样的DAG图引擎、节点库; - 额外增加会话上下文存储:每一条用户消息都会完整跑一遍
DAG流程; - 内置会话变量:变量持久保存在同一个
conversation_id下,多轮对话之间可以读写、跨轮次保留数据; - 典型场景:意图分类节点(
LLM做问题分类),不同意图走不同分支,分支内可以调用知识库、提取用户信息、生成回答。
对比
Workflow vs Chatflow
Workflow:一次性任务,无会话变量,不记忆历史;Chatflow:对话场景,会话变量持久化,多轮交互,每次消息重跑DAG。
Dify Skills
Skill是什么、在Dify怎么用、运行原理,和Tool/Workflow区分开。
Skill是给Agent用的、封装好的业务SOP能力包。Tool = 单个原子动作(计算器、HTTP调用);Skill = 一套完整任务流程(包含执行步骤、规则、参考文档、内嵌脚本),专门挂载在Agent上,Agent识别到匹配场景,自动加载整套SOP执行。
核心文件:每个Skill包必须有SKILL.md,定义触发条件、分步执行流程、输出规范;还可以附带参考资料、脚本文件,打包成.skill/zip上传到Dify。
Skill怎么用
入口位置:Dify对话应用(Chatbot)→ 开启Agent → Agent配置页找到Skills,在这里添加/管理Skill包。
Skill只能给Agent使用,不能直接拖拽到Workflow画布;但做好的Agent节点可以放进Workflow/Chatflow里面调用。
使用流程
- 准备
Skill包- 新建文件夹,创建核心文件
SKILL.md(固定规范) - 可选:添加参考文档、脚本(
python/bash)、附件 - 打包成
.skill或者zip压缩包 示例SKILL.md极简模板:
1
2
3
4
5
6
7
8
9
10
 # 文档摘要Skill
 ## 触发条件:用户要求总结文档、提取要点
 ## 执行步骤
 1. 读取用户上传文档,提取核心事实
 2. 区分事实和观点,列出3条关键结论
 3. 生成摘要,输出风险提示
 ## 输出格式
 - 核心摘要
 - 关键要点列表
 - 潜在风险
- 新建文件夹,创建核心文件
- 导入
DifyAgent配置 →Skills→ 上传skill包,平台解析读取SKILL.md内容。 - 挂载到
Agent勾选启用这个Skill;同时保持已启用Tools(联网/代码沙箱等)。 - 测试对话 用户提问命中
Skill触发条件 →Agent自动读取整套Skill SOP,按文档里规定步骤执行。
简单测试案例
- 测试
Skill名称:产品竞品分析Skill - 触发条件:用户需要做竞品对比、产品调研
- 执行步骤
- 确认对比产品清单
- 调用联网搜索工具,收集参数、定价
- 对比优缺点,输出风险点
- 输出对比表格+结论建议
- 测试提问:帮我对比
Dify和FastGPT的优缺点 - 预期:
Agent识别命中Skill,自动按上面4步顺序执行,自动调用搜索工具,最后输出规范表格。
Skill vs Tool vs Workflow区分如下,
| 对象 | 归属 | 本质 | 控制权 |
|---|---|---|---|
Tool工具 | Agent | 原子单动作(http/计算器) | Agent按需调用单个动作 |
Skill技能包 | Agent | 一套完整任务SOP,包含多步骤、规则、参考资料,内部可以调用多个Tool | Agent识别场景后,完整加载整套SOP并按步骤执行 |
Workflow | 独立应用/节点 | 人提前拖拽连线固定DAG流程图 | 开发者预先写死执行路径 |
通俗类比
Tool= 螺丝刀、扳手(单个工具);Skill= 《拆装电脑完整维修手册》(手册里告诉你什么时候用螺丝刀、什么时候用扳手,完整步骤);Workflow= 工厂固定流水线,一步一步固定死,不能改顺序。
Skill运行底层实现原理
Skill的解析、上下文注入逻辑:Python;脚本执行复用Dify内置Python沙箱服务(Go守护进程隔离)。
Skill包本身是markdown+附件,不是编译程序,只是一套结构化任务描述。
完整运行链路
- 加载阶段(
Agent初始化)Dify后端读取所有挂载的Skill包,解析每个SKILL.md,提取:触发条件、执行步骤、输出规范、内嵌脚本。 把所有Skill的元信息,整理成结构化描述,注入到Agent的系统提示词上下文。 - 用户提问 → 匹配阶段 用户输入消息,送入
Agent推理循环(ReAct/FunctionCall);LLM判断:当前任务是否匹配某个Skill的触发条件; 命中:Agent把这个Skill完整SOP(SKILL.md全部内容)加载进当前推理上下文。 SOP执行阶段(核心)Agent严格按照SKILL.md里写的步骤,进入循环执行:- 步骤需要外部信息:自动调用对应的
Tool(搜索/代码/http); - 步骤有内嵌脚本:交给
Dify沙箱执行,拿到返回Observation; - 每一步结果放回上下文,继续执行下一条
SOP;
和普通
Agent最大差别:普通Agent自己自由思考;启用Skill后,Agent被约束必须按照Skill文档写好的步骤执行任务。- 步骤需要外部信息:自动调用对应的
- 输出阶段 执行完成,严格遵守
SKILL.md定义的输出格式返回结果;保留完整思考日志,可在Dify调试面板查看Skill加载、每一步SOP执行记录。 - 会话持久化
Skill执行过程中的中间变量,保存在当前conversation_id会话上下文,多轮对话可以继续延续当前Skill任务。
底层关键点
Skill不是独立引擎,是增强Agent Prompt上下文的结构化规范;运行还是复用Agent原有的ReAct/FunctionCall循环,没有新增独立执行引擎;Skill内部脚本在Dify隔离沙箱执行,和代码节点安全机制一致,防止恶意代码;- 多个
Skill可以同时挂载:Agent会自动选择匹配度最高的Skill;不会同时执行多个Skill; - 权限隔离:
Workspace级别的Skill,可以多个Agent应用复用,团队统一维护一套业务SOP,不用每个Agent重复写提示词。
优势
- 业务
SOP可沉淀、可复用:一套竞品分析/测试报告Skill,多个Agent直接挂载使用; - 提示词模块化:不用把超长业务规则全部塞在系统
prompt里,分开维护; - 强制执行规范:保证
Agent做同类任务,输出格式、分析步骤统一,减少随机性。
局限
- 只能依附
Agent,不能脱离Agent单独跑;不能直接在Workflow画布直接调用Skill包; Skill本质是Prompt增强,复杂分支强逻辑场景,稳定性不如Workflow固定DAG;- 依赖
LLM识别触发条件,极端场景下可能出现匹配失败、没有加载Skill。
和前面5个案例联动对比
Chatbot(基础对话):纯prompt,无工具、无SOP;RAG知识库:检索私有文档,返回片段;Workflow:固定DAG,人定义所有分支,无模型自主决策;Agent:模型自主思考,按需调用单个Tool;Agent + Skills:Agent识别场景,加载完整业务SOP,按手册步骤调用多个Tool完成复杂任务;Chatflow:带会话记忆的DAG流程。
Skill就是把业务SOP封装成标准化包,增强Agent,让Agent遇到对应任务自动按固定步骤执行。
Dify中的Agent React模式
Dify的Agent框架本质上是一个由大模型负责决策、由工具负责执行、由平台负责编排和约束的智能任务执行框架。它让模型不只是一次性生成文本,而是能够根据目标自主规划步骤、调用工具、读取结果,并持续迭代直到完成任务。
Agent原理
核心执行流程
- 接收任务
- 用户输入问题、目标或任务描述。
- 系统将用户输入、系统提示词、历史对话、上下文变量和知识检索结果组合成模型上下文。
- 模型决策
- 大模型分析当前状态,判断应该直接回答,还是调用某个工具。
- 它可以决定下一步动作、工具参数以及必要时的执行顺序。
- 调用工具
Agent可以调用搜索、代码执行、HTTP请求、数据库、知识库、文件处理、第三方插件或自定义工具。- 工具执行结果会被返回给模型,作为下一轮决策的依据。
- 循环迭代
- 模型根据工具结果继续规划下一步。
- 这个过程通常表现为:思考/决策 → 执行动作 → 获取观察结果 → 再次决策。
- 达到目标、模型认为信息足够,或触发最大迭代次数后,流程结束。
- 生成最终结果
Agent综合中间步骤和工具返回值,生成面向用户的最终回答。- 在流式模式下,过程中的状态、工具调用和最终内容也可以逐步返回。
主要组成部分
Agent策略- 决定模型如何规划和调用工具。
- 常见模式包括基于
ReAct的循环推理,以及基于Function Calling/Tool Calling的结构化工具调用。 - 不同模型能力不同,因此策略需要与模型的工具调用能力匹配。
- 模型
- 负责理解任务、制定计划、选择工具、生成参数和组织答案。
Dify通常通过模型供应商抽象层接入不同的语言模型,并统一处理调用、参数、Token和流式输出。
- 工具系统
- 工具向
Agent暴露名称、用途、输入参数和返回结果。 Agent不需要了解工具内部实现,只需根据工具描述决定是否调用。- 工具可以是平台内置能力、插件、工作流、外部
API或MCP等可连接服务。
- 工具向
- 上下文与记忆
- 上下文包括系统指令、用户输入、会话历史、变量、知识检索结果和工具输出。
- 会话记忆用于保留多轮对话信息,但通常需要受到上下文长度、隐私和成本限制。
- 文件、知识库和结构化变量可以作为
Agent的外部信息来源。
- 工作流编排
Agent可以作为独立应用运行,也可以作为Workflow中的一个Agent节点。- 在工作流中,
Agent负责处理需要动态决策的部分,其他节点负责条件判断、数据转换、知识检索、代码执行或固定流程控制。 - 这形成了确定性流程 + 非确定性
Agent的混合架构。
- 执行控制
- 平台通常会限制最大迭代次数、工具调用次数、超时时间和输出长度。
- 还需要处理工具失败、参数错误、模型拒绝调用、上下文过长和循环不收敛等情况。
- 开发者可以通过提示词、工具权限、节点配置和流程分支约束
Agent行为。
Agent与普通LLM应用的区别
普通LLM应用通常是:
1
用户输入 → 模型生成答案
Dify Agent通常是:
1
2
3
4
5
6
7
用户任务
  → 模型分析
  → 选择工具
  → 工具执行
  → 读取结果
  → 再次分析
  → 继续执行或输出答案
因此,Agent更适合搜索研究、数据分析、自动化操作、复杂问答和多步骤任务;而对于格式固定、步骤明确的场景,普通工作流往往更稳定、更容易控制。
总结下,Dify的Agent框架是一个以大模型为决策中心、以工具调用为执行手段、以记忆和上下文为状态、以工作流和运行限制为控制机制的多步骤智能任务执行系统。
React代码实现
Dify里边有两个版本的React实现,两者都实现了模型思考/决定动作 -> 执行工具 -> 把结果带回模型的语义,但代码层面的技术路线已经完全不同。
- 一种是
ReAct(Reason + Act)文本协议模式,属于旧版agent-chat运行链路; - 新版
mode=agent,由Agent Backend的Pydantic AI Agent.run()负责工具循环。
旧版agent-chat
入口是AgentChatAppGenerator -> AgentChatAppRunner,循环在API服务进程内直接执行:./api/core/app/apps/agent_chat/app_runner.py:28。
旧版实际上有两条策略,
| 策略 | 选择条件 | 工具调用方式 |
|---|---|---|
CHAIN_OF_THOUGHT / ReAct | 不支持原生Tool Calling的模型可走此路径 | Prompt约定 + 文本/JSON解析 |
FUNCTION_CALLING | 模型schema含TOOL_CALL或MULTI_TOOL_CALL时自动切换 | 原生函数调用 |
AgentChatAppRunner会先读模型能力;发现原生Tool Calling后,即使旧配置曾偏向ReAct,也会改走FunctionCallAgentRunner。选择逻辑在./api/core/app/apps/agent_chat/app_runner.py:139
旧版文本ReAct链路,
1
2
3
4
5
6
7
8
用户请求
-> CotChatAgentRunner
-> 拼出带工具 JSON、工具名、历史、Scratchpad 的长 Prompt
-> LLM 文本流输出 Thought / Action / Action Input
-> CotAgentOutputParser 增量解析文本或 JSON
-> ToolEngine.agent_invoke()
-> 将 Observation 拼回下一轮 Prompt
-> 模型输出 Final Answer
核心循环在./api/core/agent/cot_agent_runner.py:44,
- 工具定义被放进
、工具名放进,最后成为系统提示词的一部分,参见./api/core/agent/cot_chat_agent_runner.py:17; - 模型请求显式传
tools=[],因此不是原生调用;还会设置Observation stop token,避免模型自行伪造后续观察结果; - 输出解析器逐字符处理
Thought:、Action:、代码块JSON、普通JSON,并试图还原action_name和action_input,参见./api/core/agent/output_parser/cot_output_parser.py:10; - 解析到工具动作后,旧
API进程内通过ToolEngine.agent_invoke()执行,结果写入Scratchpad,再拼接为下一轮assistant prompt; - 每轮直接写
MessageAgentThought,并通过QueueAgentThoughtEvent驱动前端过程展示; - 上限是用户配置的
max_iteration,代码进一步限制到最多99次工具迭代。
这是典型的Prompt驱动状态机 + 自定义解析器选型。优势是能兼容没有原生Tool Calling的模型;代价是格式依赖强,易受输出格式、流式半截JSON、提示注入和工具参数解析质量影响。
旧版原生函数调用分支仍在同一API进程中自己维护循环:给ModelInstance.invoke_llm()传PromptMessageTool,收集模型tool_calls,用ToolEngine.agent_invoke()执行,然后把ToolPromptMessage加入下一轮上下文,参见./api/core/agent/fc_agent_runner.py:83。
新版mode=agent
新版App类型与旧agent-chat分开定义:AGENT_CHAT是遗留ReAct App,AGENT是绑定Agent Soul快照、由独立Agent Backend驱动的新App,参见./api/models/model.py:379。
1
2
3
4
5
6
7
8
9
用户请求
-> AgentAppRunner
-> API 根据 Agent Soul snapshot 构建 CreateRunRequest
-> 调用独立 dify-agent Backend
-> Agenton Compositor 装载 model / tools / skill / history / shell 等 layers
-> Pydantic AI Agent(model, tools).run()
-> Pydantic AI 原生工具循环
-> Backend 事件流回 API
-> API 转成现有聊天 SSE 与 MessageAgentThought 兼容记录
API侧不再亲自跑工具循环,而是构建Agent Backend请求;Tools、Skills、Knowledge、Shell、会话snapshot会一起装入运行请求,参见./api/core/app/apps/agent_app/runtime_request_builder.py:115。
Backend内部技术选型,
- 用
Agenton Compositor把prompt、history、Skill、Tool、Knowledge、Shell、MCP等建成可组合Layer,而非将所有内容集中拼到一个ReAct Prompt,参见./dify-agent/src/dify_agent/runtime/compositor_factory.py:149; - 用
Pydantic AI创建Agent(model, tools=tools);Dify不再维护自己的文本Action解析器,参见./dify-agent/src/dify_agent/runtime/agent_factory.py:16; Agent.run()负责模型请求、工具调用、Tool Return回填、下一轮调用和最终输出;当前单次run的请求步数上限为500,参见./dify-agent/src/dify_agent/runtime/runner.py:399;- 模型适配层把
Pydantic AI的ToolDefinition转为Dify/Graphon PromptMessageTool,并只从模型响应的结构化message.tool_calls还原ToolCallPart,参见./dify-agent/src/dify_agent/adapters/llm/model.py:565; - 工具执行分层:``Plugin Tool
可走Plugin Daemon;Builtin/API/Workflow/MCP走dify.core.tools,再经Dify内部API回到ToolEngine`执行; - 会话状态不再只是重拼历史
Prompt,而是保存Pydantic AI消息历史和Agenton Composition Snapshot;API仍把Backend事件映射回MessageAgentThought,以兼容现有聊天界面。
Dify Agent Backend所接收到的模型响应必须能产生结构化tool_calls;不一定要求最底层供应商API天生叫这个字段。理论上,Dify的模型提供商适配层可以把某种兼容协议转换成该结构。代码链路很明确:
1
2
3
4
5
6
7
Agent.run()
  -> 将 Pydantic AI ToolDefinition 转成 Dify PromptMessageTool
  -> Dify LLM Gateway 调模型,并传入 tools
  -> Gateway 返回 message.tool_calls
  -> Adapter 转成 Pydantic AI ToolCallPart
  -> Pydantic AI 执行本地注册的 Tool
  -> observation 回到下一轮模型调用
Agent的创建就是直接传入tools,没有ReAct文本解析器:./dify-agent/src/dify_agent/runtime/agent_factory.py:16。随后由Agent.run()驱动多轮执行:./dify-agent/src/dify_agent/runtime/runner.py:399。
模型适配器会把工具定义送往Dify LLM Gateway:./dify-agent/src/dify_agent/adapters/llm/model.py:565,并且只从响应的message.tool_calls构造ToolCallPart:./dify-agent/src/dify_agent/adapters/llm/model.py:630。
注意
- 新版
React Agent不配置任何Tool时,不要求模型支持原生tool_calls。Agent.run()可以只生成普通文本;- 新版
React Agent要执行MCP、知识检索、Shell等工具时,当前新版Agent Backend要求模型网关能完成结构化Tool Calling;否则工具循环无法成立。
关键差异
| 维度 | 旧agent-chat ReAct | 新mode=agent |
|---|---|---|
| 循环拥有者 | API内的CotAgentRunner/FunctionCallAgentRunner | 独立Agent Backend中的Pydantic AI |
| 非原生模型兼容 | 文本ReAct可用 | Backend无文本Action解析降级 |
| 工具契约 | Prompt中的工具JSON,或旧函数调用协议 | JSON Schema + 结构化tool_calls |
| 状态 | Scratchpad文本 + MessageAgentThought | Pydantic AI history + Agenton snapshot |
| 扩展方式 | Runner类、Prompt模板、API内逻辑 | Layer composition:Skill、MCP、Shell、Knowledge、HITL等 |
| 工具执行 | API进程直接ToolEngine.agent_invoke | Backend Tool wrapper,再回调API/Plugin执行 |
| 可靠性重点 | 提升文本格式解析容错 | 依赖Provider的原生/等价Tool Calling协议 |
因此,新版ReAct更准确叫作基于原生Tool Calling的Agent Loop:仍然是Reason/Act/Observe的行为模型,但不再通过Thought:/Action:文本协议实现。它以结构化tool call作为边界,这也是它比旧文本ReAct更稳定、也更依赖模型工具调用能力的根本原因。