MCP工具网关——让业务快速融入MCP生态系统
序言
在开篇,我们不探讨MCP是什么,也不探讨MCP解决了什么问题,以及MCP和Agent的实现边界,这些问题都放在了附录部分。
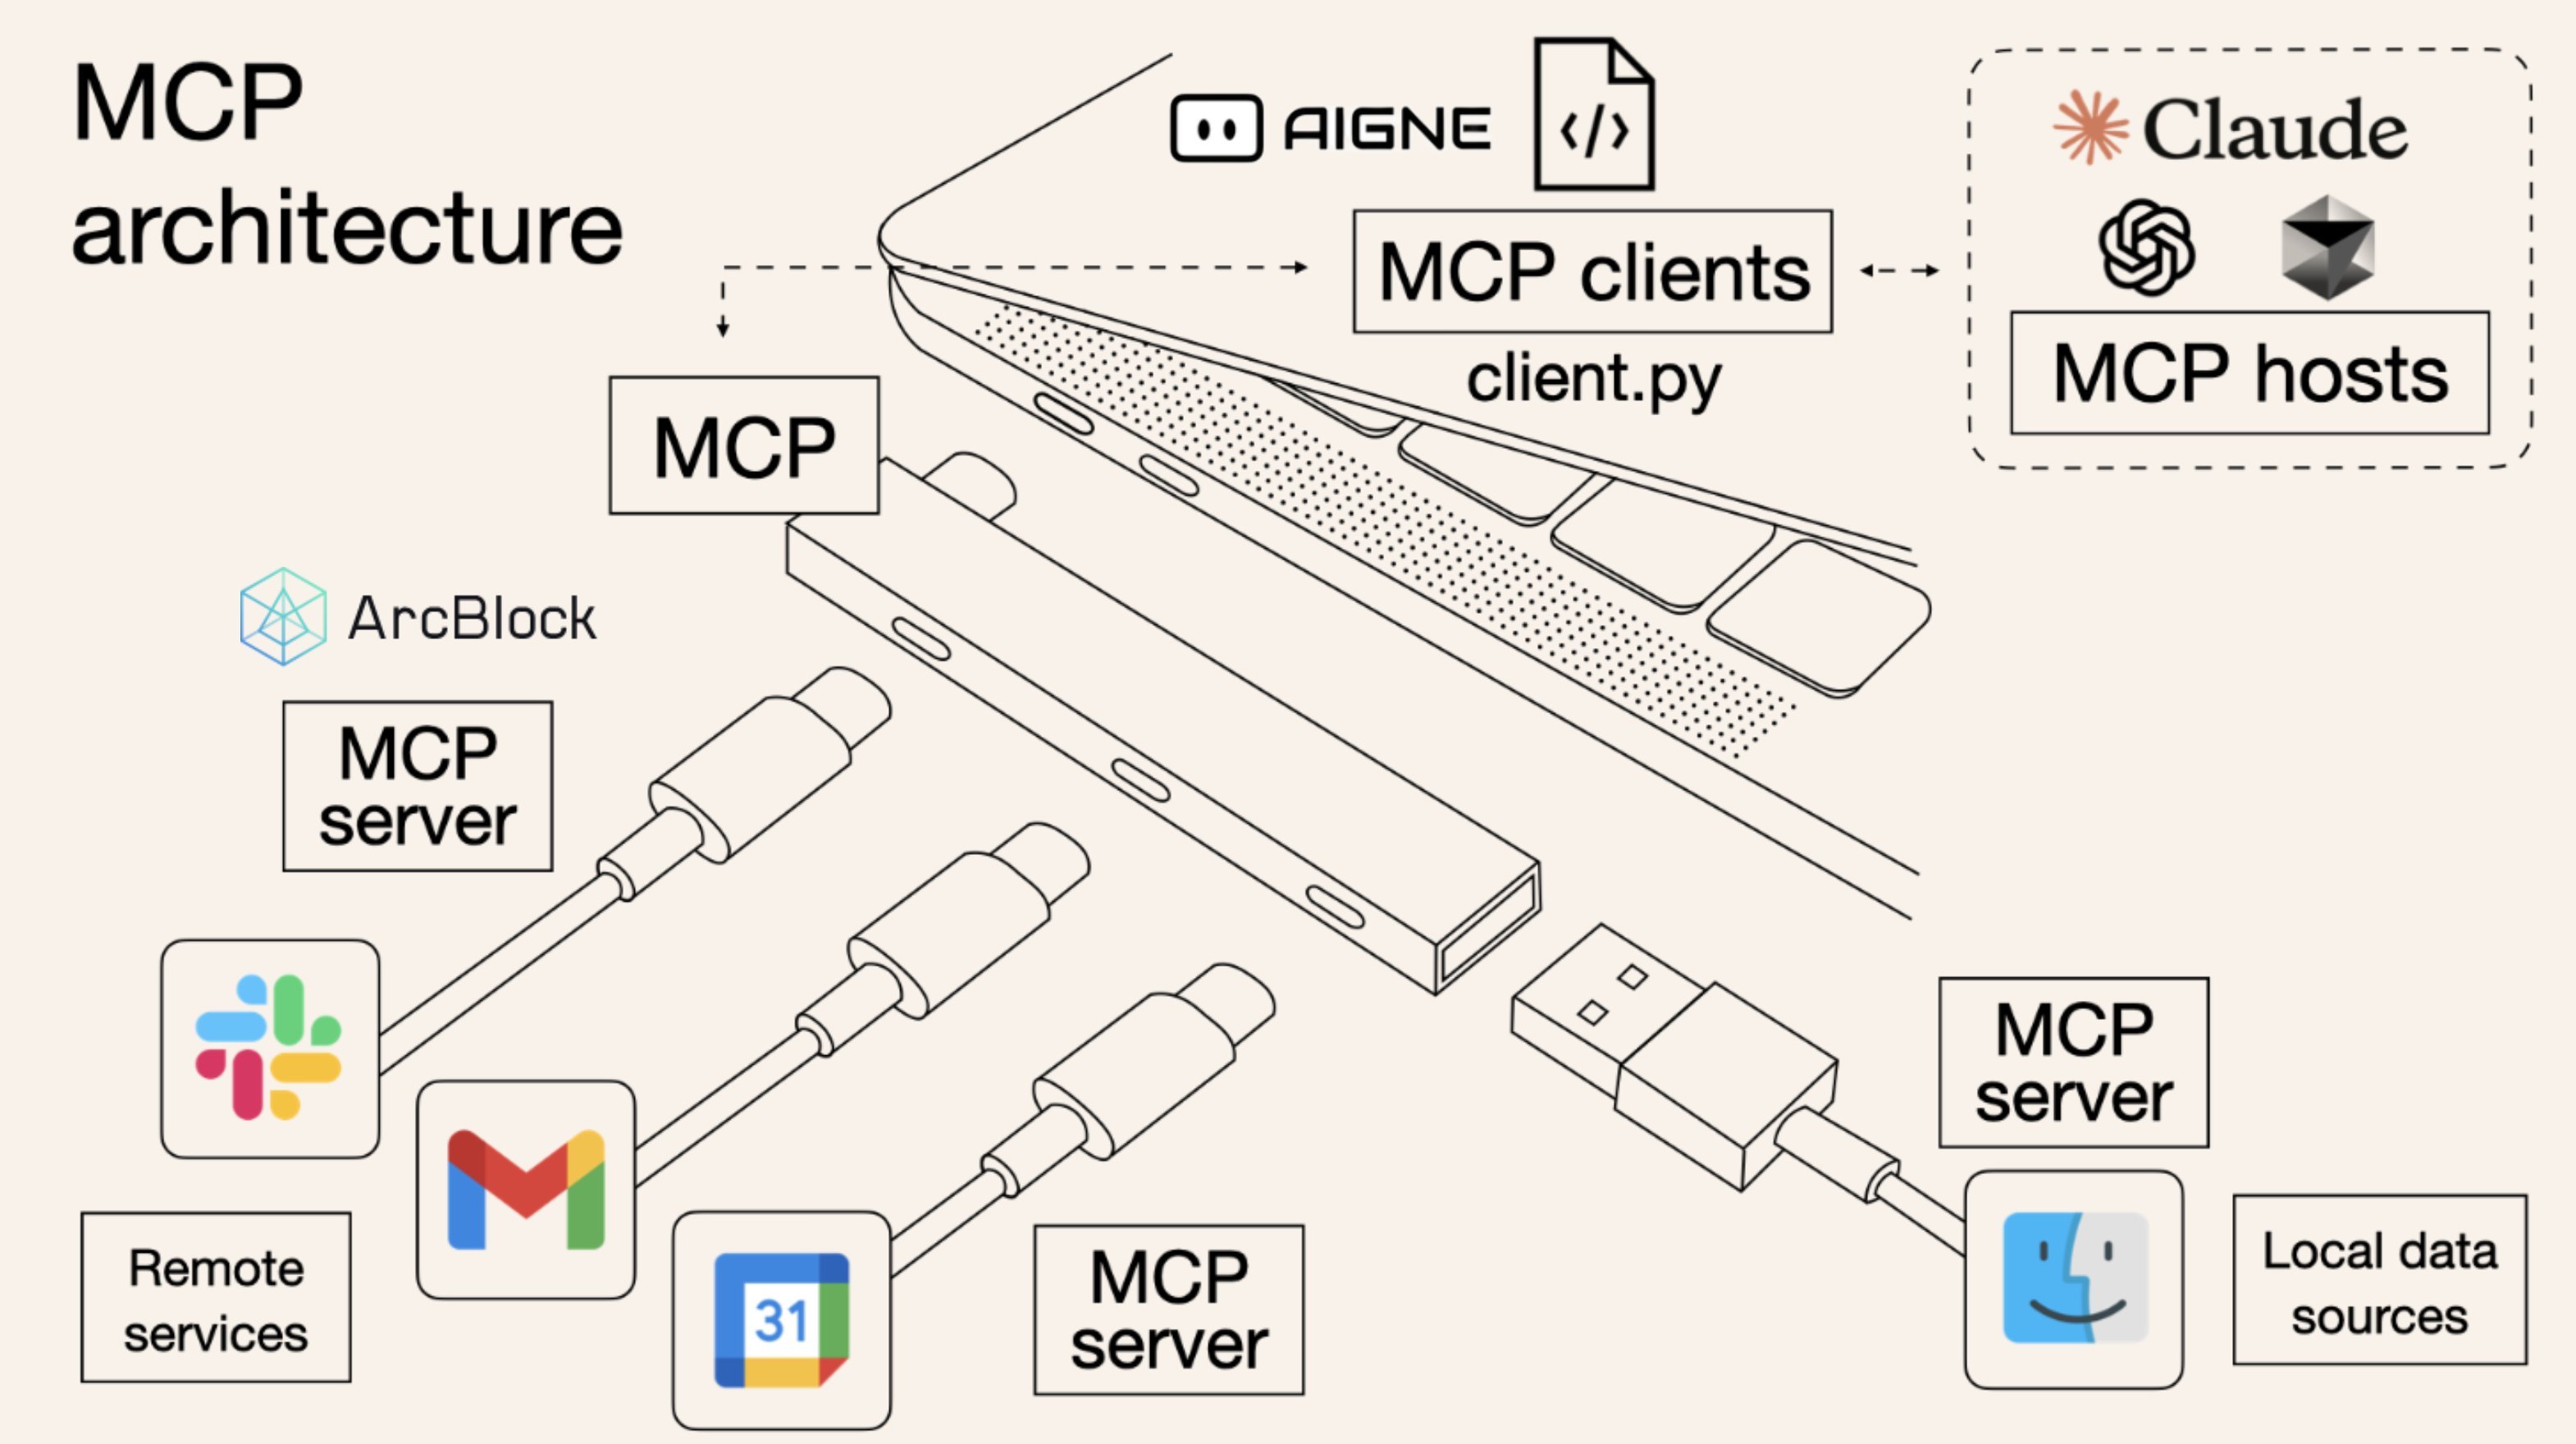 MCP印象(来自X)
这里主要关注从MCP革新软件范式,延伸到怎么让业务快速融入MCP生态系统。
MCP范式革新
MCP标志着软件服务开始原生支持以LLM/Agent作为一等公民调用方;大量后台工具、企业服务、数据服务的主要使用者,会逐步从人类开发者变成AI Agent。
但人依然是权限、决策、体验层的主体,人用的UI产品会继续存在,不会变成全部都是LLM在用。
MCP(Model Context Protocol)本质不是给人设计的接口,是给大模型Agent设计的外设总线。但不是说人不再使用服务,而是服务会分化成两套面向不同消费者的形态。
- 旧形态:面向人。接口是
UI、网页、REST API(人写代码调用,最终决策是人),返回内容优先考虑可读性,错误提示、分页、交互弹窗都是为人类理解设计; - 新形态:面向
LLM Agent。接口是MCP Server,返回结构化机器可读数据,不需要美化渲染,重点是能力声明、参数校验、稳定输出、可工具调用、权限隔离。
为什么
MCP会推动这个变化?
MCP解决了Agent调用外部服务最大的痛点:工具描述碎片化、协议不统一、上下文传递混乱。
- 在
MCP之前:每个工具/系统都要单独写Function Calling描述,不同厂商格式不一样,大模型要单独适配,容易出现幻觉、参数填错;每次新增一个服务,都要手动改prompt和工具定义; - 在
MCP之后:服务端(MCP Server)主动对外声明自己有哪些能力(tools/resources/prompts)。LLM客户端自动发现能力,自动读取入参、返回schema。
类比:以前每个硬件都要单独写驱动;现在
MCP就是标准化协议(Type-C),设备插上,系统自动识别能力。
这个设计目标,从根上就是服务AI Agent,而不是人。人不会去消费MCP原生的二进制/结构化消息。
人依然是最终决策者、权限所有者,Agent只是代理执行,
- 账号、资金、敏感操作的授权主体还是人;
Agent拿到MCP返回的数据之后,再整理成人类可读的结果交给人;- 复杂业务、高风险决策依然要人确认。
LLM变成服务的调用客户端,人变成权限所有者和最终验收者。
两套服务形态会长期共存
- 面向人的:
Web/APP/前端页面,强调体验、可视化、交互; - 面向
Agent的:MCP Server,作为独立的能力暴露层,和前端解耦。
很多产品会同时提供两套出口:同一个底层业务,一边给人看UI,一边暴露MCP能力给Agent调用。
举个例子:
Notion现在既有人用网页,也提供MCP服务。人可以手动编辑笔记;LLM Agent可以通过MCP读写、查询页面。底层存储是一套,消费端分成人vs LLM。
服务设计逻辑会彻底改写。以前设计API/服务,优先思考人会怎么用这个功能?MCP时代设计服务,新增一条核心思考Agent会怎么调用这个能力?
- 返回优先结构化,减少自然语言自由文本,防止大模型解析出错;
- 能力要原子化:不要大而全的接口,拆成小工具,方便
Agent组合编排; - 强错误结构化:返回错误码+机器可读描述,而不是一句操作失败,请重试;
- 权限做细粒度隔离:
Agent只能拿到被授权的资源,防止越权; - 提供资源订阅:
MCP支持resources,Agent可以监听数据变更,而不是人主动轮询。
这和面向人类开发的思路完全不一样。
让业务快速融入MCP生态系统
MCP出现在大众面前最初的姿态,是通过大模型产品作为Host(比如Claude Desktop、DeepSeek DeepChat等),通过Client调用各种MCP Server(本地的或者互联网上已有数万种),再访问、更新后面的资源(更新文件、查询天气、订外卖、送快递等等)。
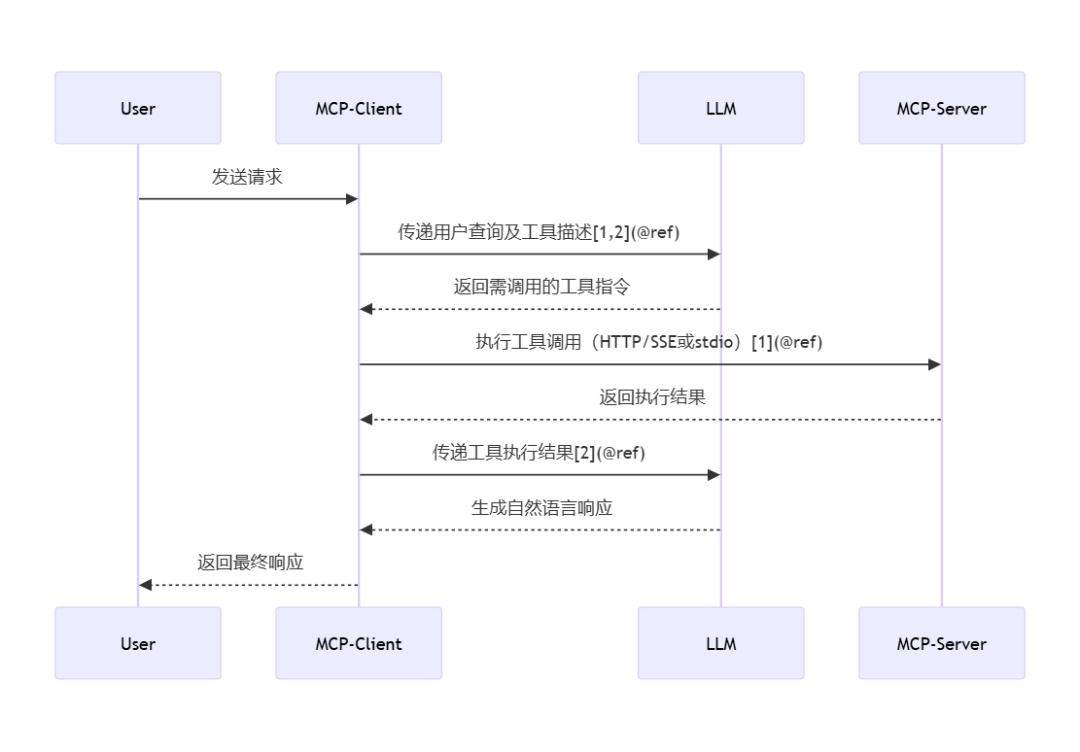 MCP时序图
这就相当于让大模型长出了无数个触角(拉丁文中,Manus的意思是手),可以和现实世界互动。照这样的趋势发展下去,今天使用的各种互联网服务,未来可能都是变成一个个隐藏在MCP server之后的Resource,就像今天获取信息主要通过搜索引擎一样,我们也会越来越多通过大模型来使用这些服务,服务厂家只需要跟各种大模型做适配,这就是AI原生。
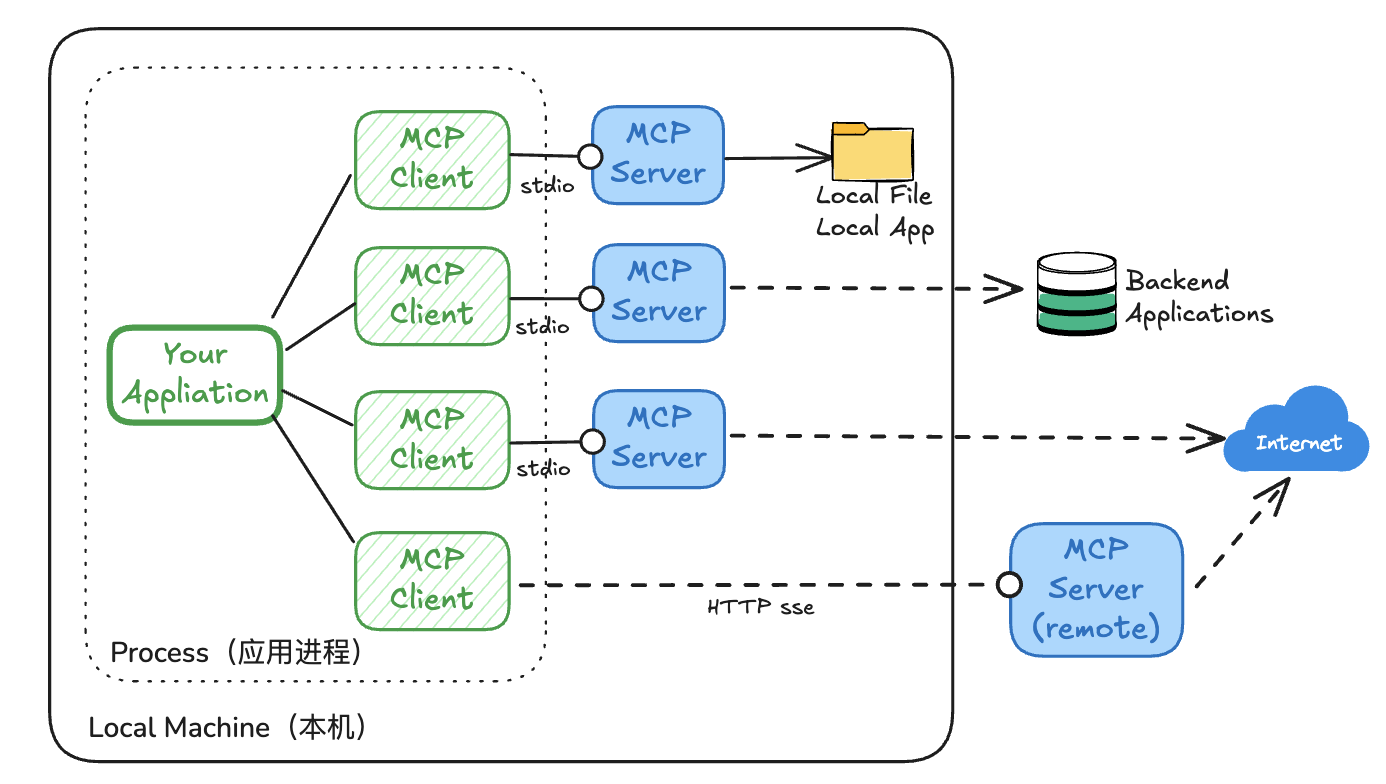 MCP能力范围(来自网络)
Claude桌面应用程序已经成为默认的MCP客户端,大多数服务器都有专门的说明来指导如何与该客户端集成。但MCP并不局限于Claude桌面,它可以用在任何支持它的其他LLM客户端,能不能有这样一种假设,MCP的LLM客户端可以是任何微服务呢?
站在分布式微服务开发者的角度来看,把业务快速融入MCP生态系统,是否需要跟进,以及如何快速跟进,无疑是有价值的,而且是有挑战的。这不仅涉及到技术层面的适配和集成,还包括对MCP生态系统的理解和规划。开发者需要评估MCP对他们业务的潜在价值,以及如何利用MCP来增强他们的产品和服务。
下面介绍一种无需修改应用代码,就能实现让应用快速融入MCP生态的方法。通过搭建一个LLM可调用的MCP工具网关,可以将微服务无缝适配为MCP Server,从而快速将现有的微服务集成到MCP生态系统中。这种方法的优势在于,它允许业务在不中断现有技术栈的情况下,平滑过渡到MCP生态。企业可以在不影响业务连续性和技术债务的前提下,探索和利用AI原生应用的基础设施。通过保留对AI原生应用基础设施的选择权,企业可以灵活地评估和选择最适合其业务需求的技术解决方案。
MCP工具网关有什么?
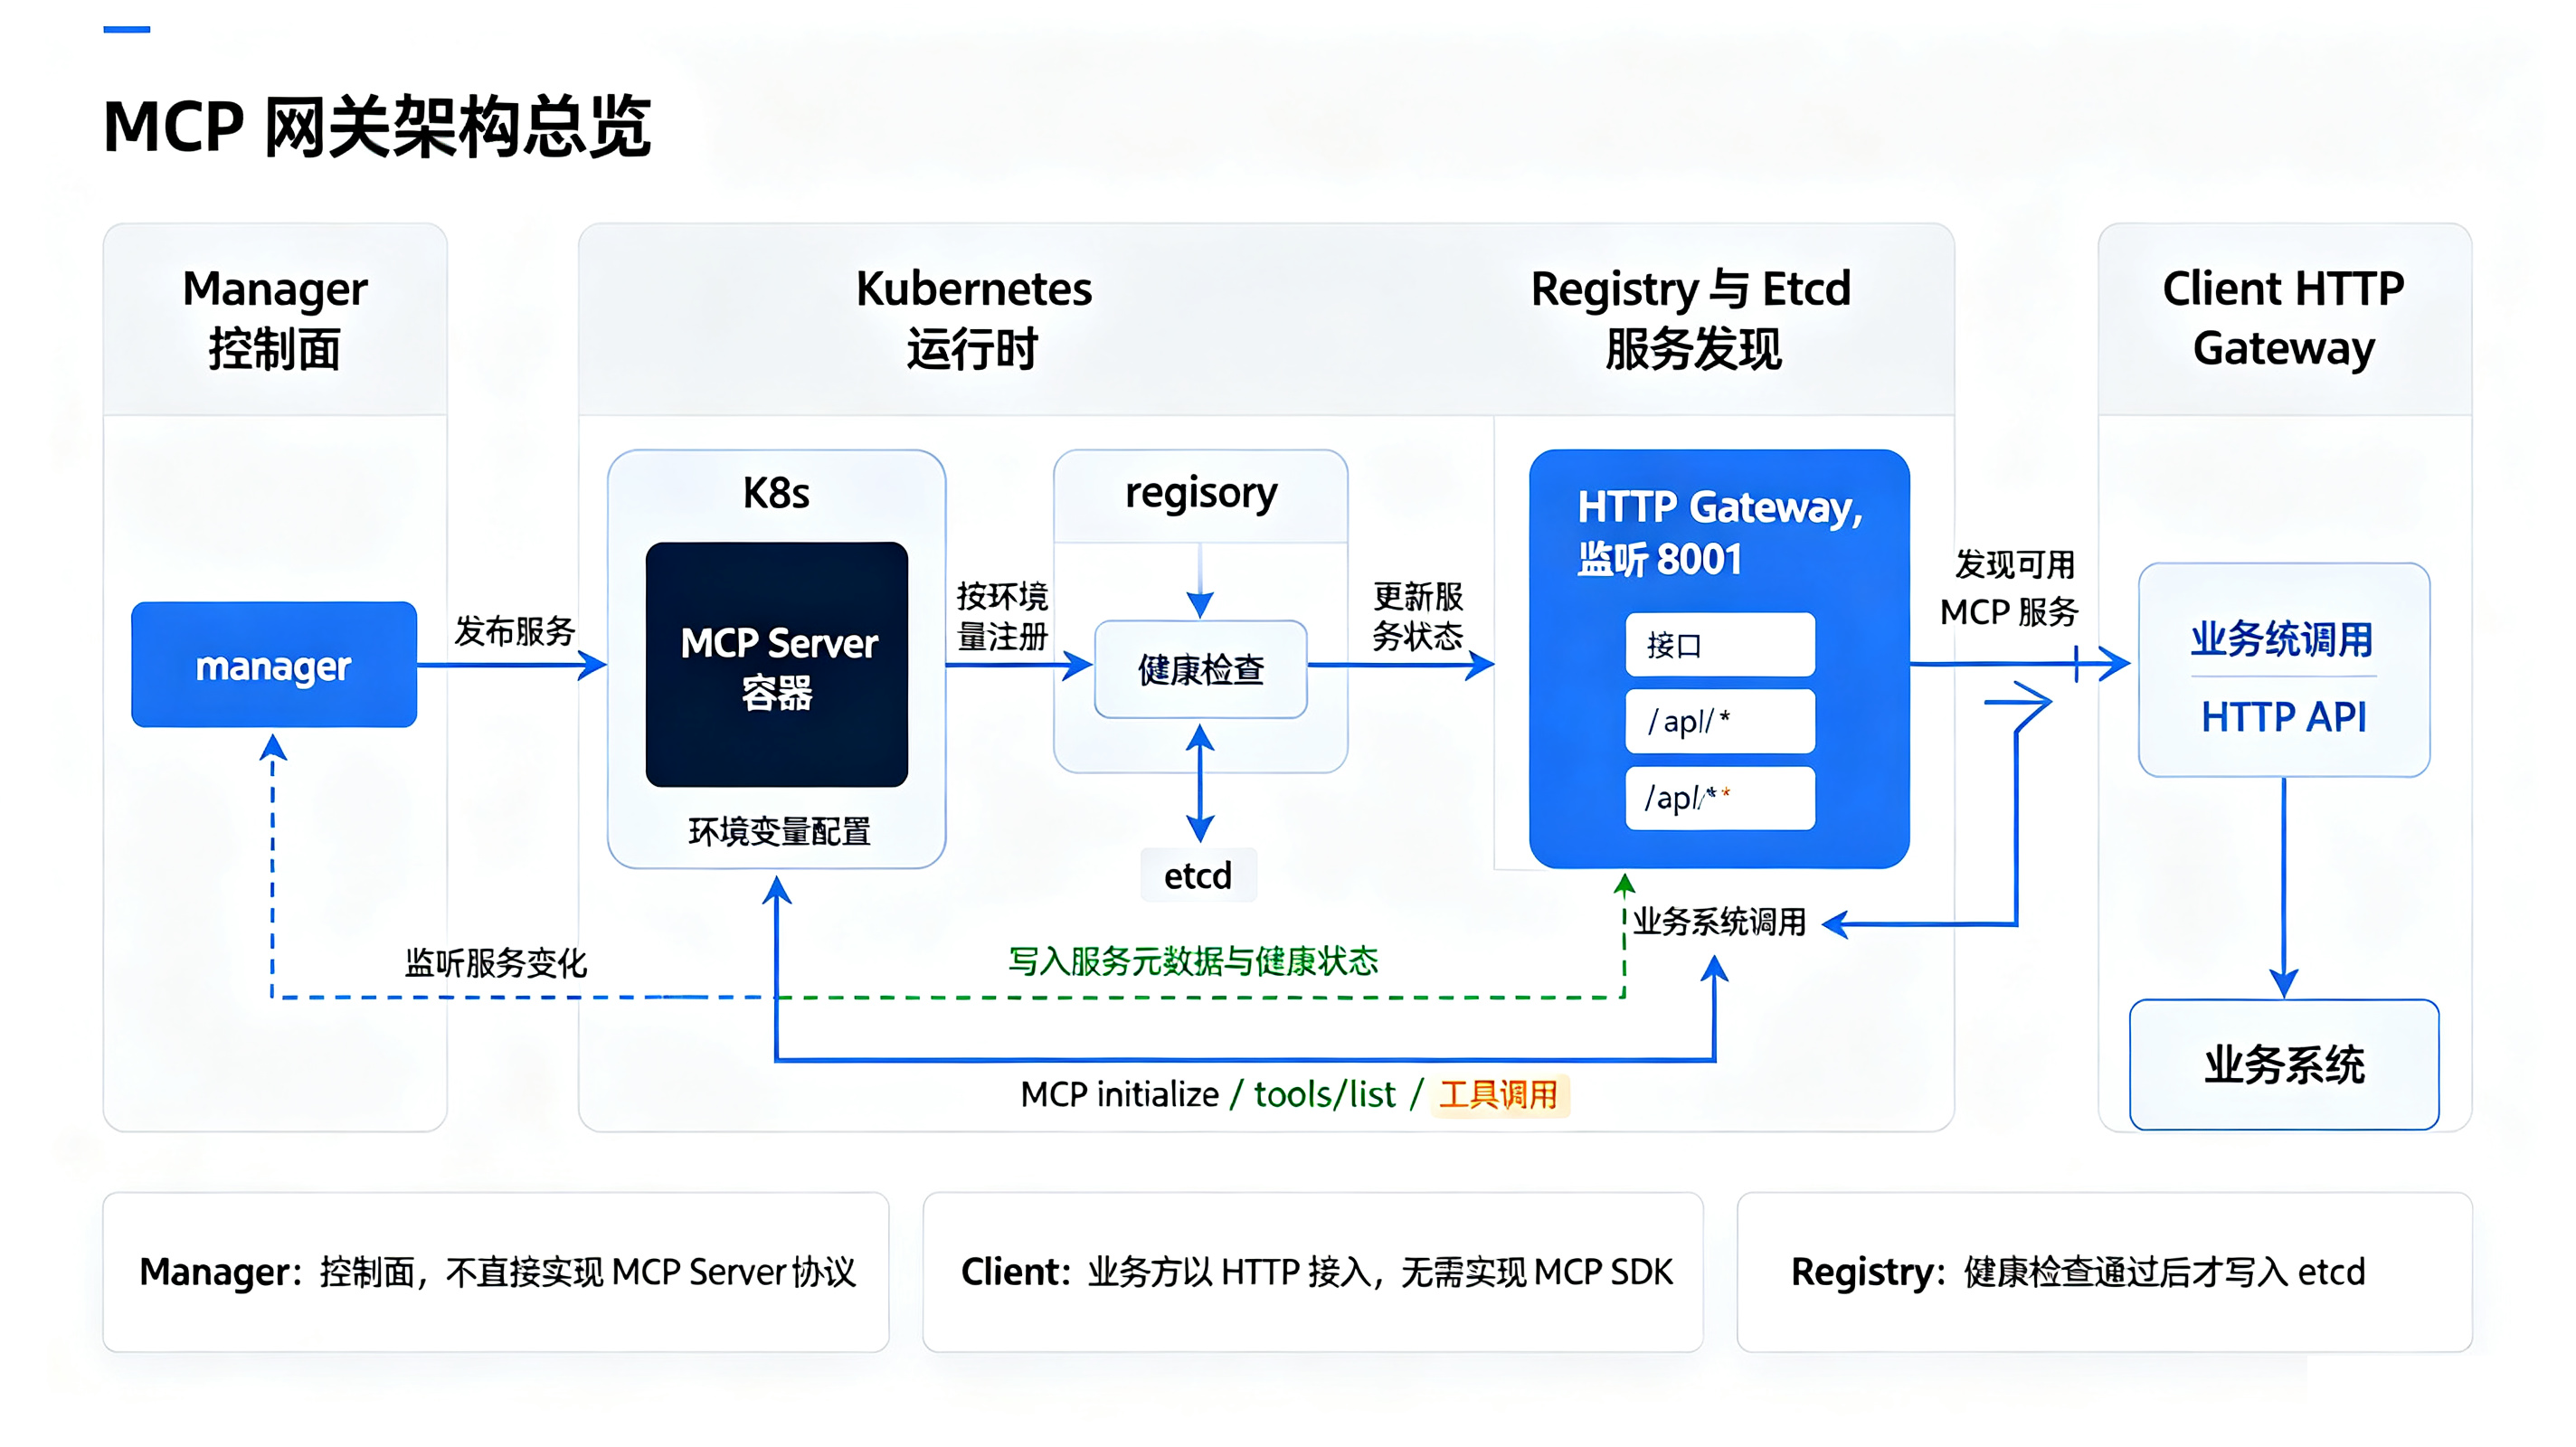 MCP工具网关架构总览(AI生成)
该架构采用控制面与数据面彻底分离的AI云原生架构,
- 基于
K8s实现MCP服务全生命周期托管,由Manager控制面完成服务发布与资源编排,自动生成标准化MCP Server数据面Pod作为唯一工具执行单元; - 依托云原生服务注册发现体系,通过
Registry健康校验+etcd元数据持久化,实现MCP服务自动化注册、探测与动态发现,摒弃传统固定节点对接模式,具备分布式弹性扩容能力; - 基于
MCP全新Streamable HTTP传输协议,兼容短请求与动态流式长连接,突破传统SSE传输局限,天然适配云网关、CDN与Serverless部署,大幅提升MCP服务的兼容性、稳定性与可扩展性; - 平台封装标准化
MCP Client HTTP网关,向下屏蔽底层MCP协议与服务发现细节,向上为业务提供极简HTTP调用接口,业务无需接入MCP SDK,可完全保有自身鉴权、会话、RAG与模型Agent控制权,实现AI工具能力的轻量化、标准化、安全化接入; - 同时通过
K8s资源配额、最小权限隔离、Pod内业务权限兜底、优雅生命周期管理,构建了一套云原生标准化、可观测、高安全、可分布式大规模部署的AI工具服务基础设施。
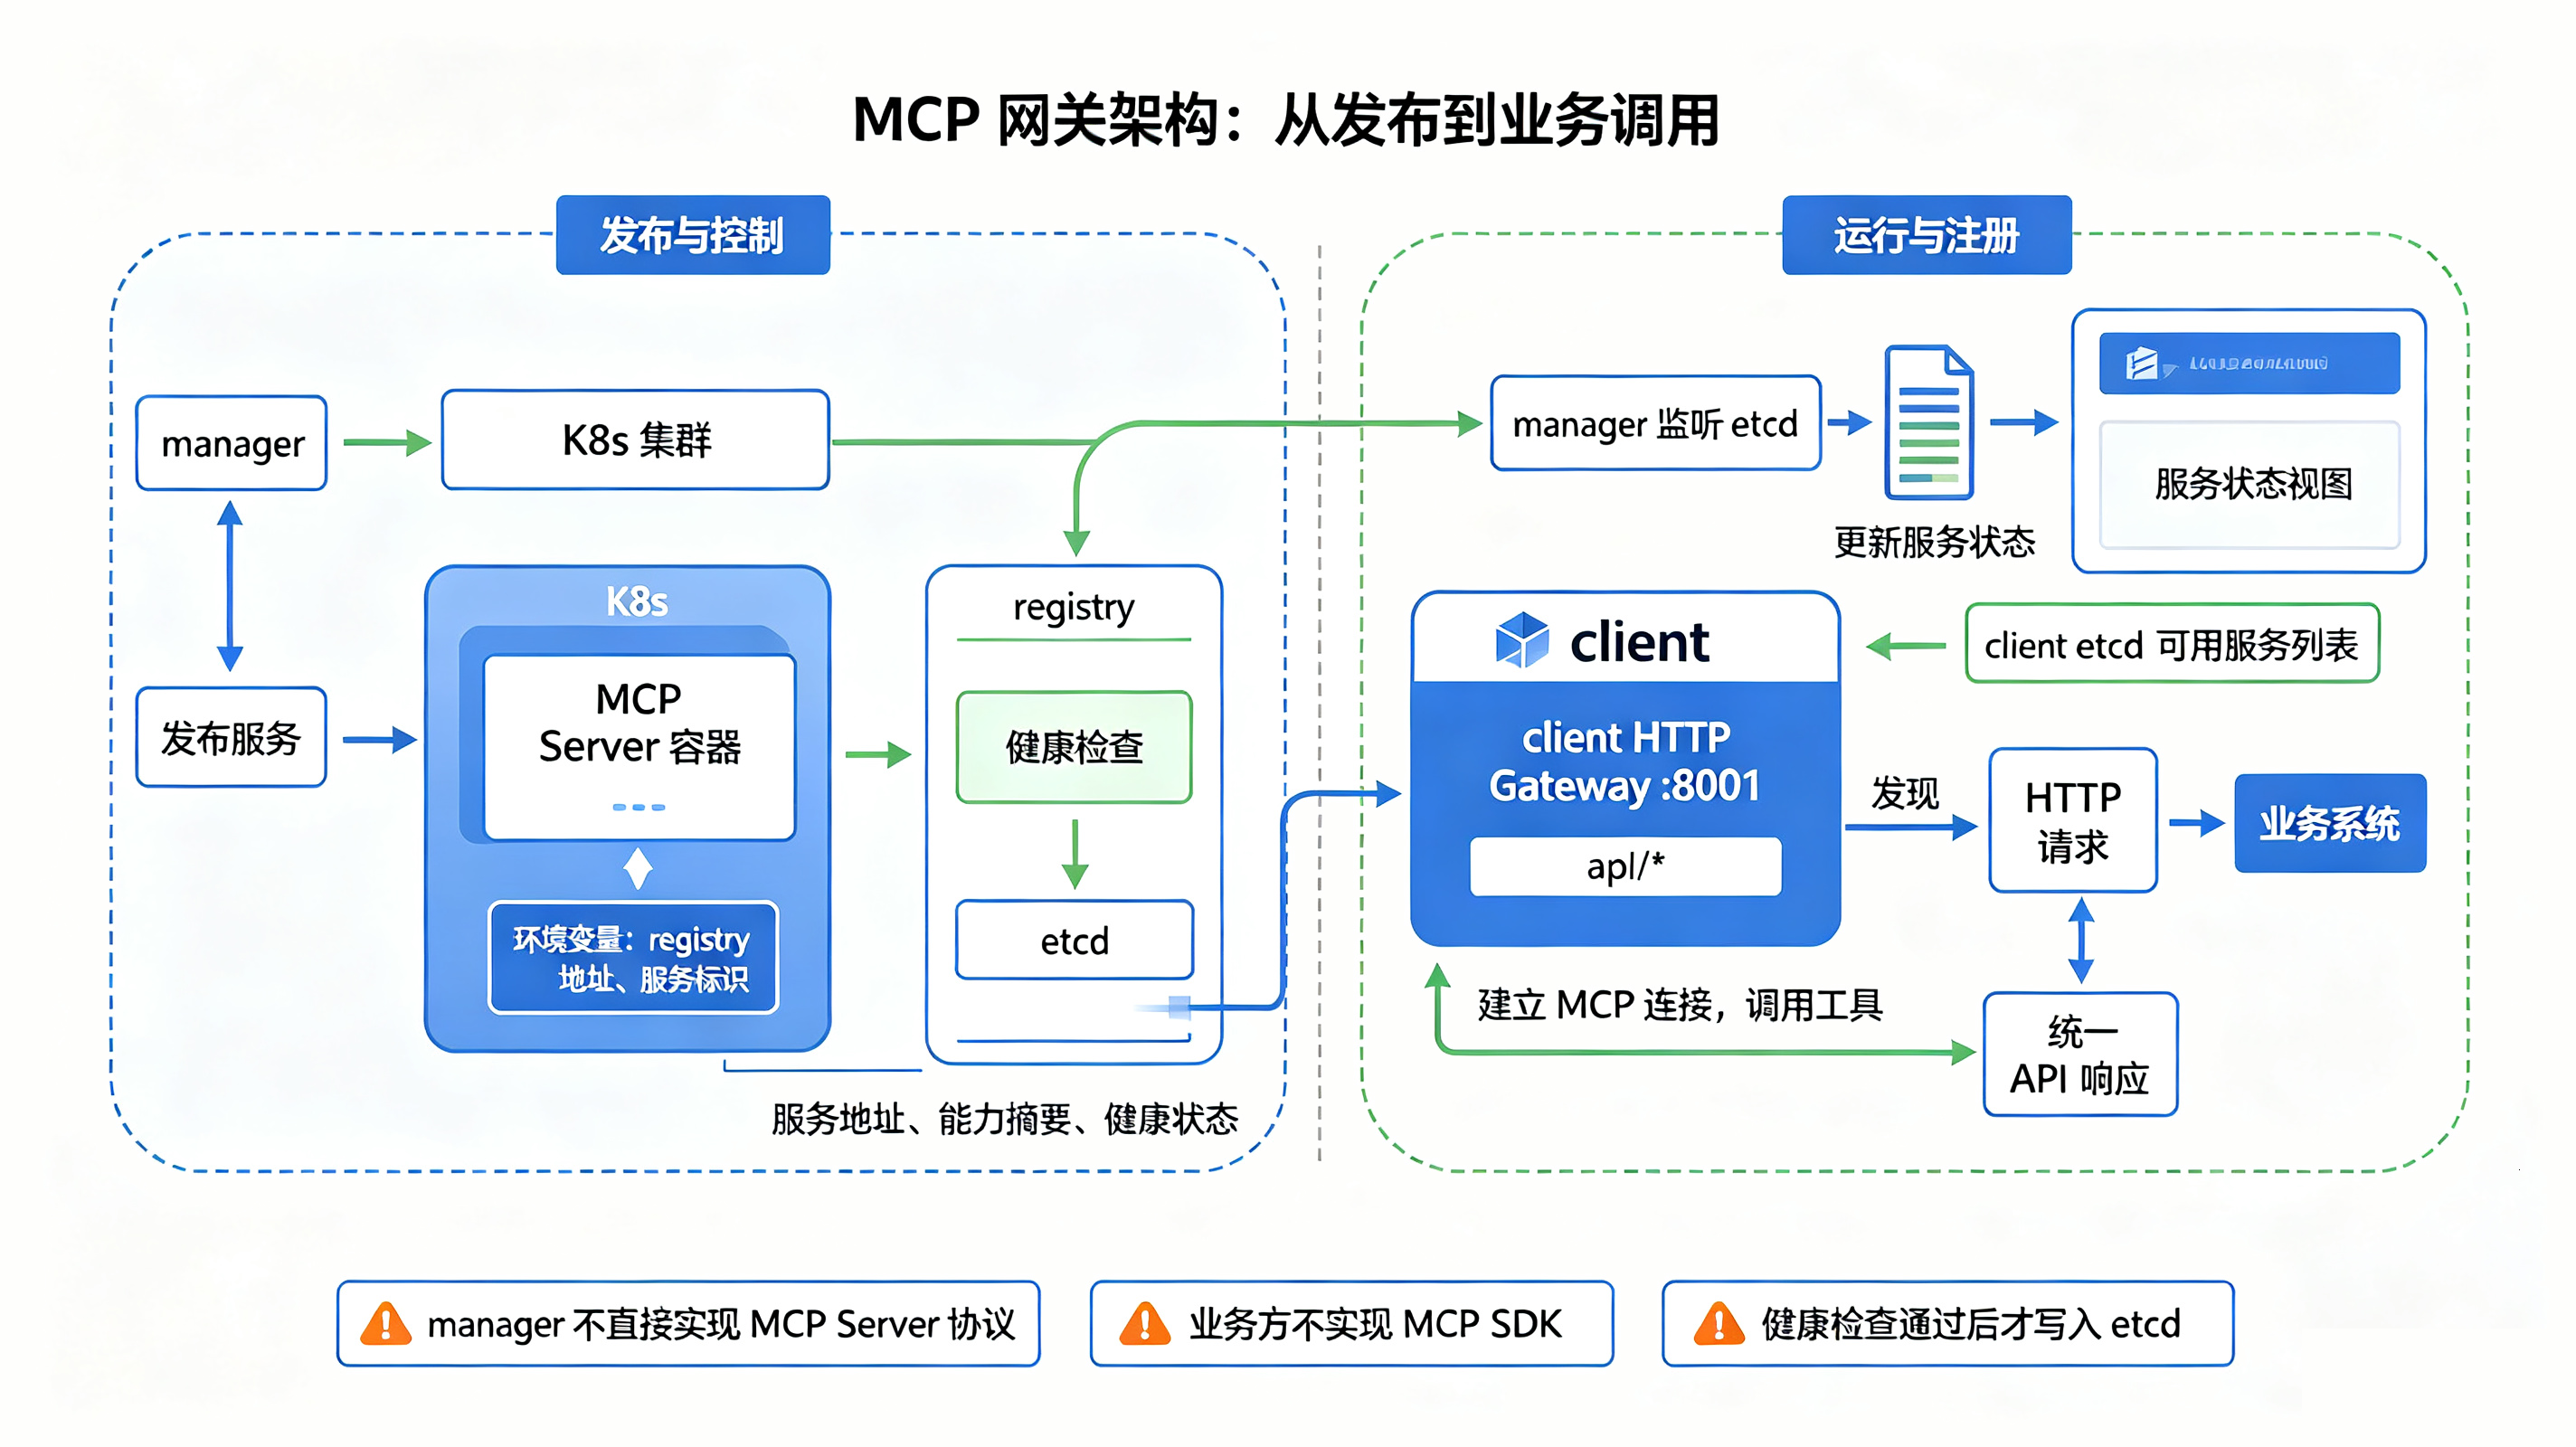 MCP工具网关架构图(AI生成)
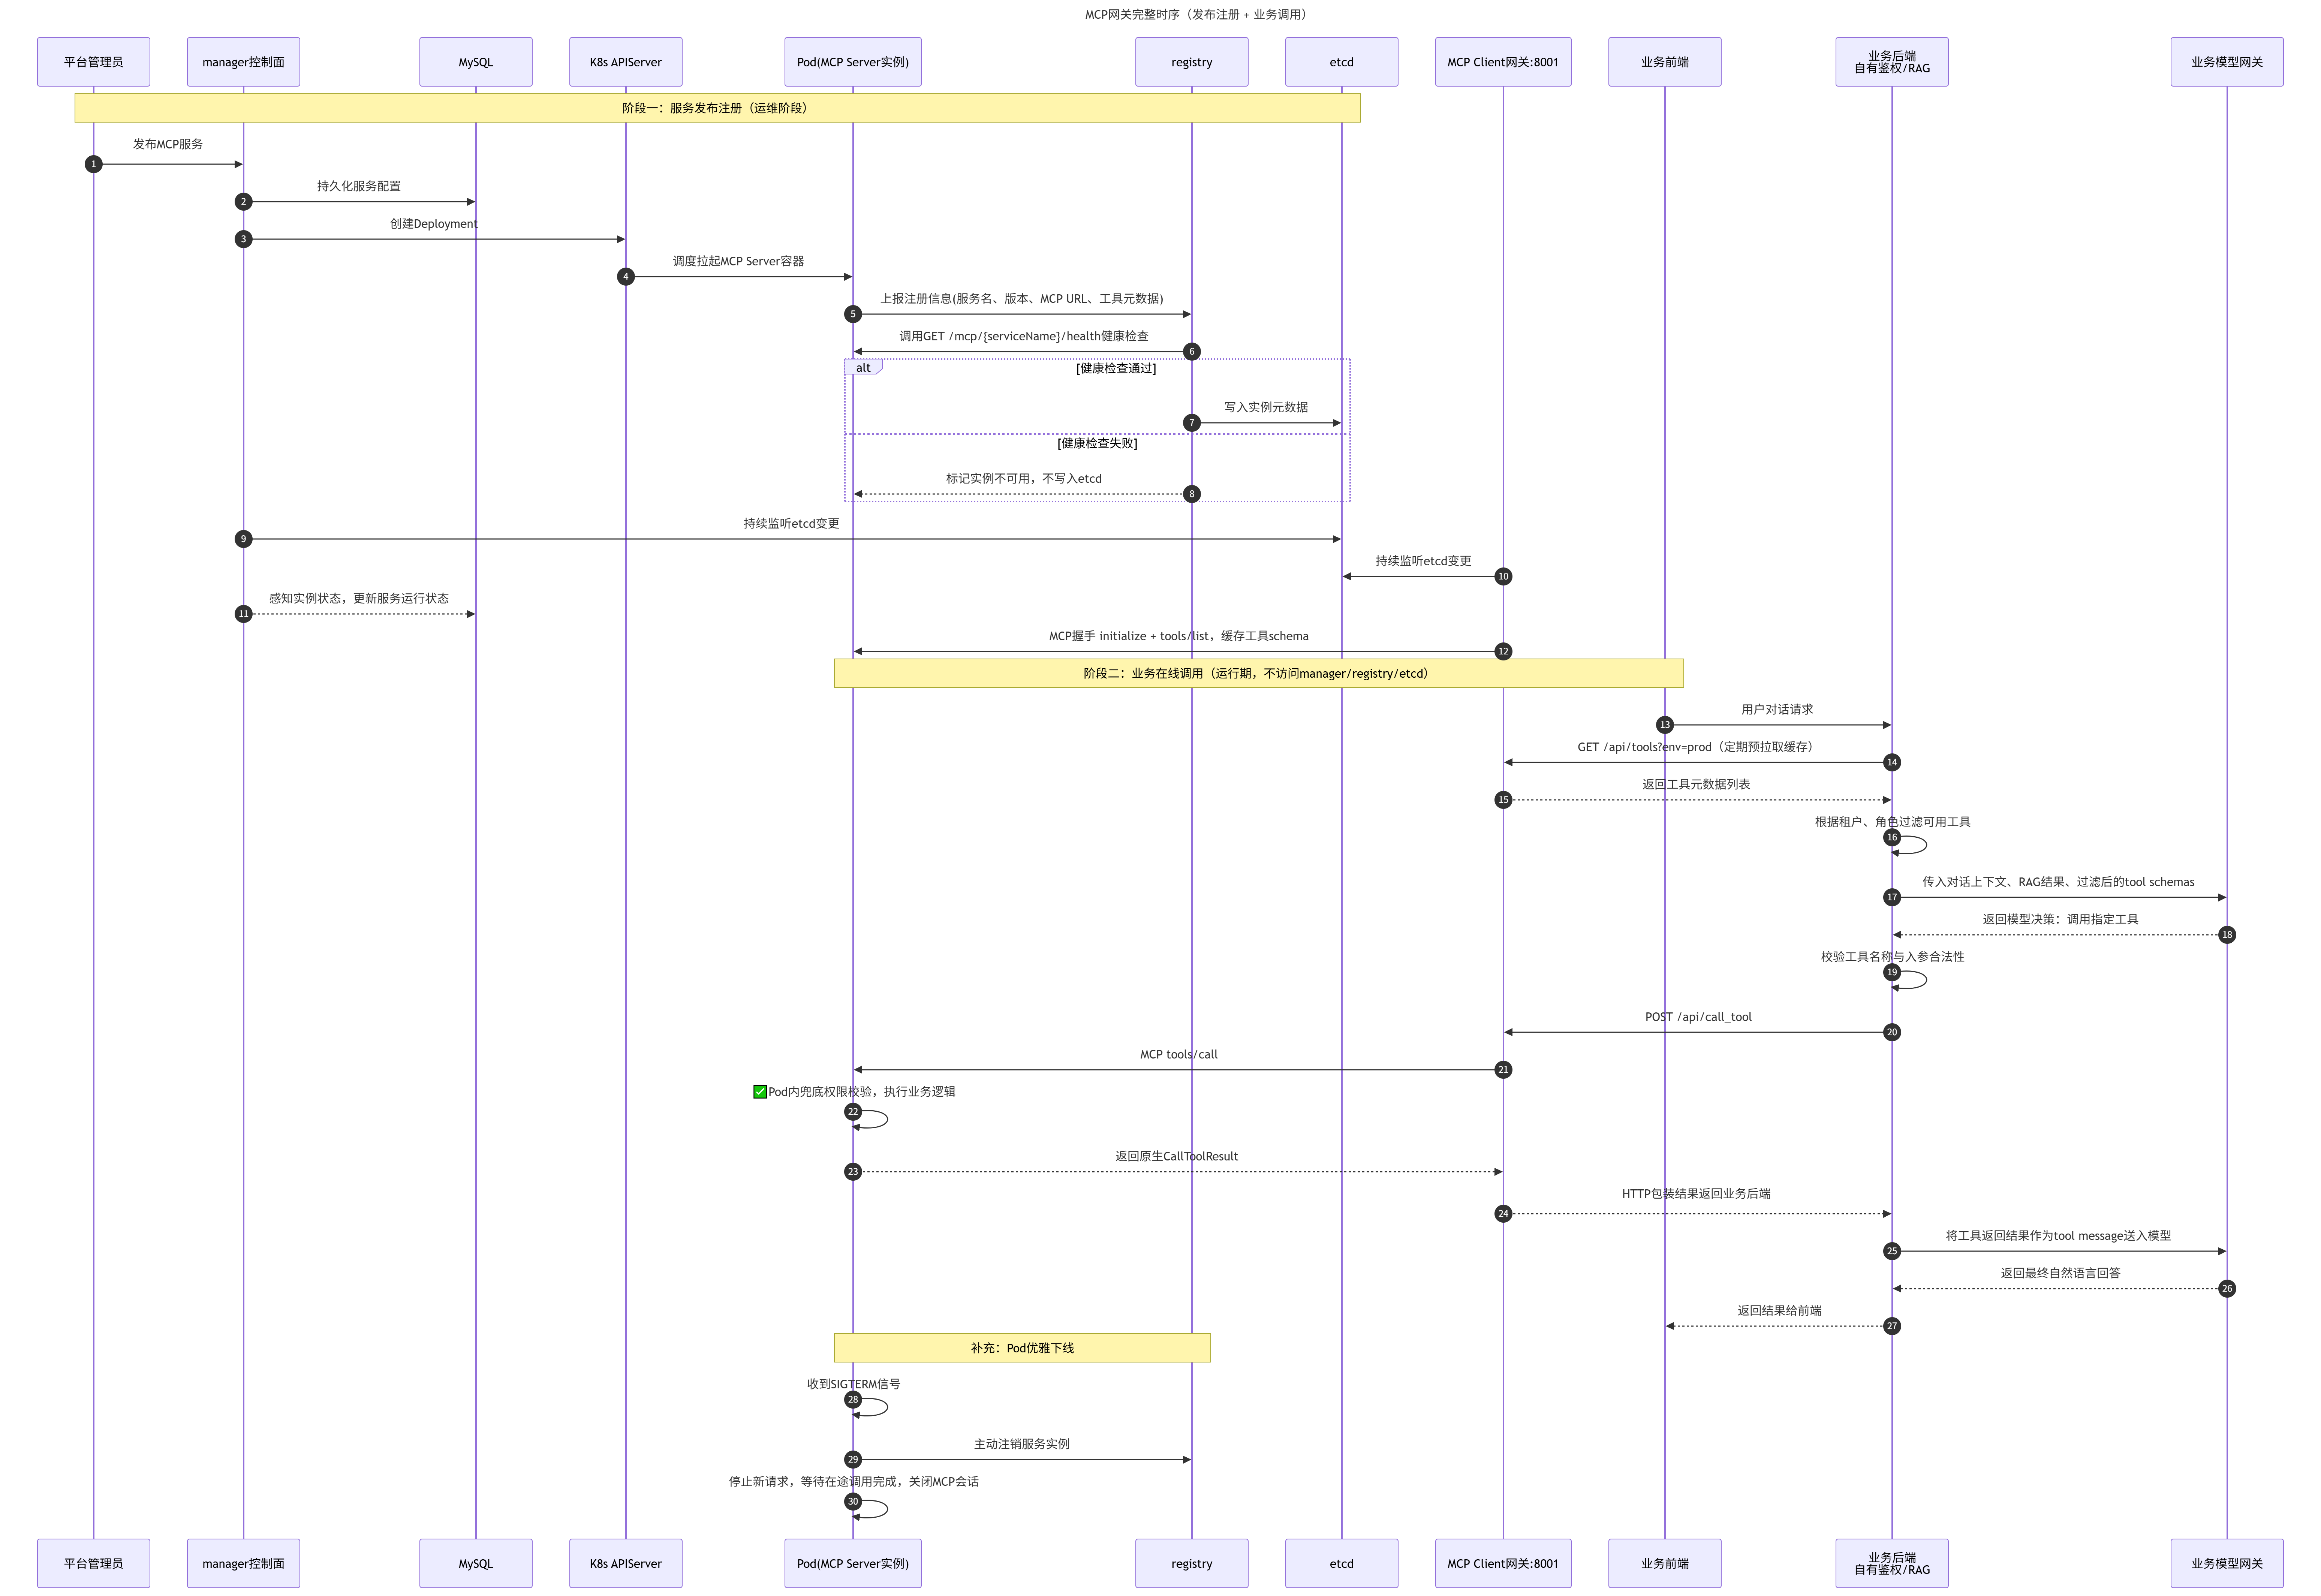 MCP工具网关时序图
搭建MCP Client HTTP网关
假设业务方已有自己的模型网关、会话记忆、RAG和权限体系,这里只关注业务后端和MCP网关怎么交互。
基础环境准备
dockermysqletcdk8straefikmcp命名空间
- 大模型(需要支持
native tools的模型)
启动服务
启动MySQL、etcd,
1
2
3
4
5
6
$ docker ps
CONTAINER ID   IMAGE                        COMMAND                   CREATED          STATUS          PORTS                                           NAMES
cdd9029c0fa3   hkube/etcd-ui:latest         "/bin/sh -c './etcdk…"   10 seconds ago   Up 10 seconds   0.0.0.0:12000->8080/tcp, [::]:12000->8080/tcp   mcp_platform-etcdui-1
a5a3086e87e6   quay.io/coreos/etcd:v3.5.1   "etcd --name=mcp-nod…"   10 seconds ago   Up 10 seconds   0.0.0.0:2379->2379/tcp, [::]:2379->2379/tcp     etcd
66fef91ff6c0   mysql:5.7                    "docker-entrypoint.s…"   10 seconds ago   Up 10 seconds   0.0.0.0:3309->3306/tcp, [::]:3309->3306/tcp     mcp_platform-mysql-1
768eb7fb48c7   phpmyadmin/phpmyadmin        "/docker-entrypoint.…"   10 seconds ago   Up 10 seconds   0.0.0.0:13000->80/tcp, [::]:13000->80/tcp       mcp_platform-phpmyadmin-1
启动k8s,安装traefik,并创建mcp命名空间,
1
2
3
4
5
6
7
8
9
10
11
12
13
$ kubectl get pods -A
NAMESPACE              NAME                                         READY   STATUS    RESTARTS        AGE
kube-system            coredns-764897d7b-8cc6l                      1/1     Running   2 (34h ago)     2d22h
kube-system            etcd-minikube                                1/1     Running   2 (34h ago)     2d22h
kube-system            kube-apiserver-minikube                      1/1     Running   2 (34h ago)     2d22h
kube-system            kube-controller-manager-minikube             1/1     Running   2 (34h ago)     2d22h
kube-system            kube-proxy-tcj45                             1/1     Running   2 (34h ago)     2d22h
kube-system            kube-scheduler-minikube                      1/1     Running   2 (34h ago)     2d22h
kube-system            metrics-server-59f7ccdc54-g5jsj              1/1     Running   0               2m59s
kube-system            storage-provisioner                          1/1     Running   4 (4m51s ago)   2d22h
kube-system            traefik-dcd895cd4-j8xvx                      1/1     Running   2 (34h ago)     2d20h
kubernetes-dashboard   dashboard-metrics-scraper-5565989548-vv7jf   1/1     Running   2 (34h ago)     2d22h
kubernetes-dashboard   kubernetes-dashboard-b84665fb8-c88tn         1/1     Running   3 (4m50s ago)   2d22h
检查启动状态,看到都已经正常启动,继续往下走。
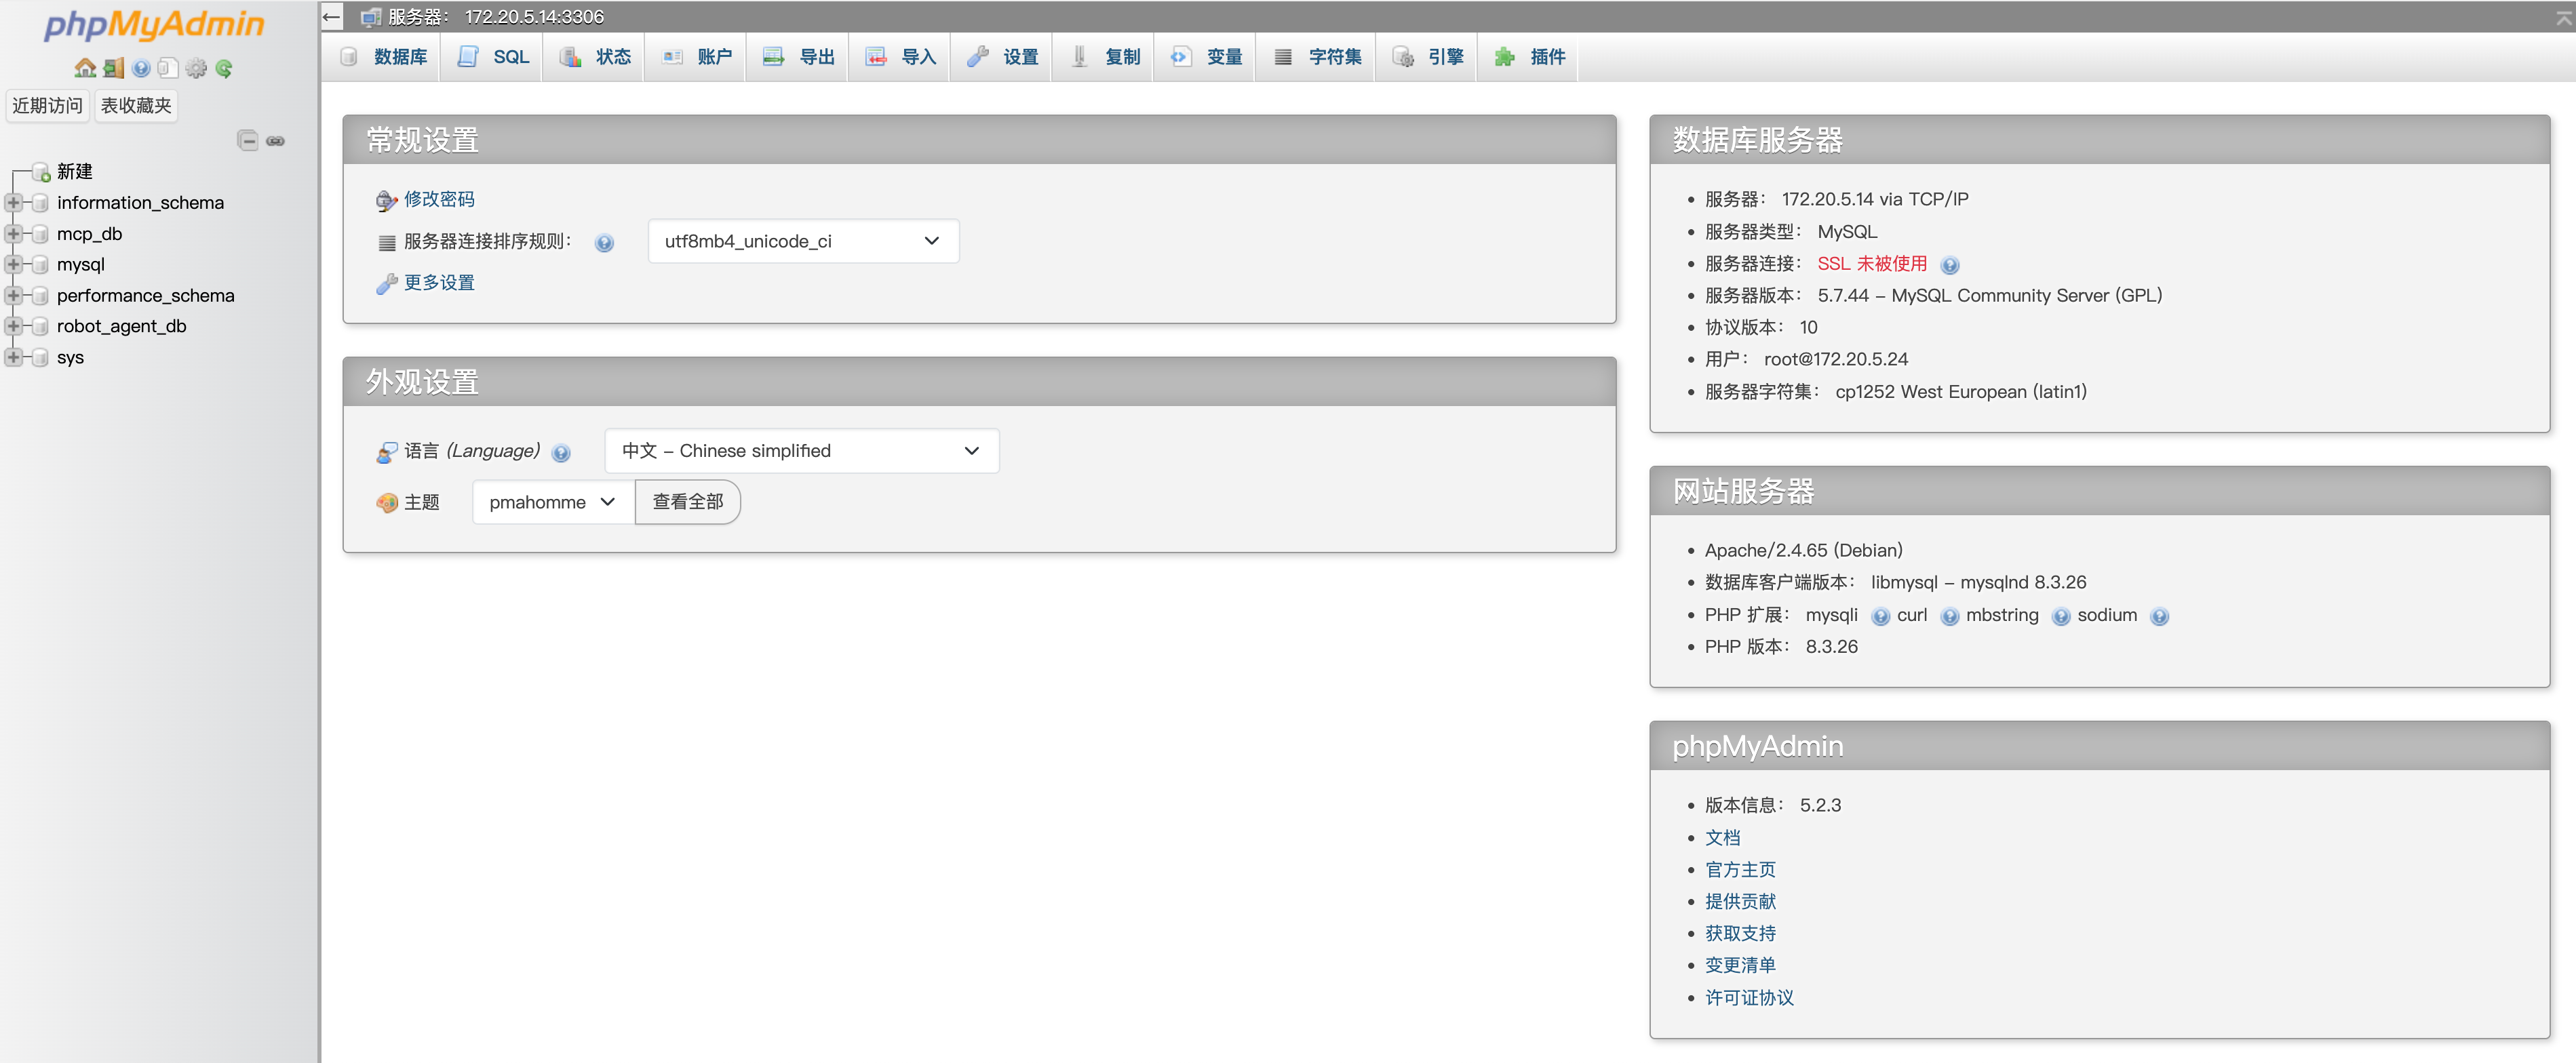 MySQL
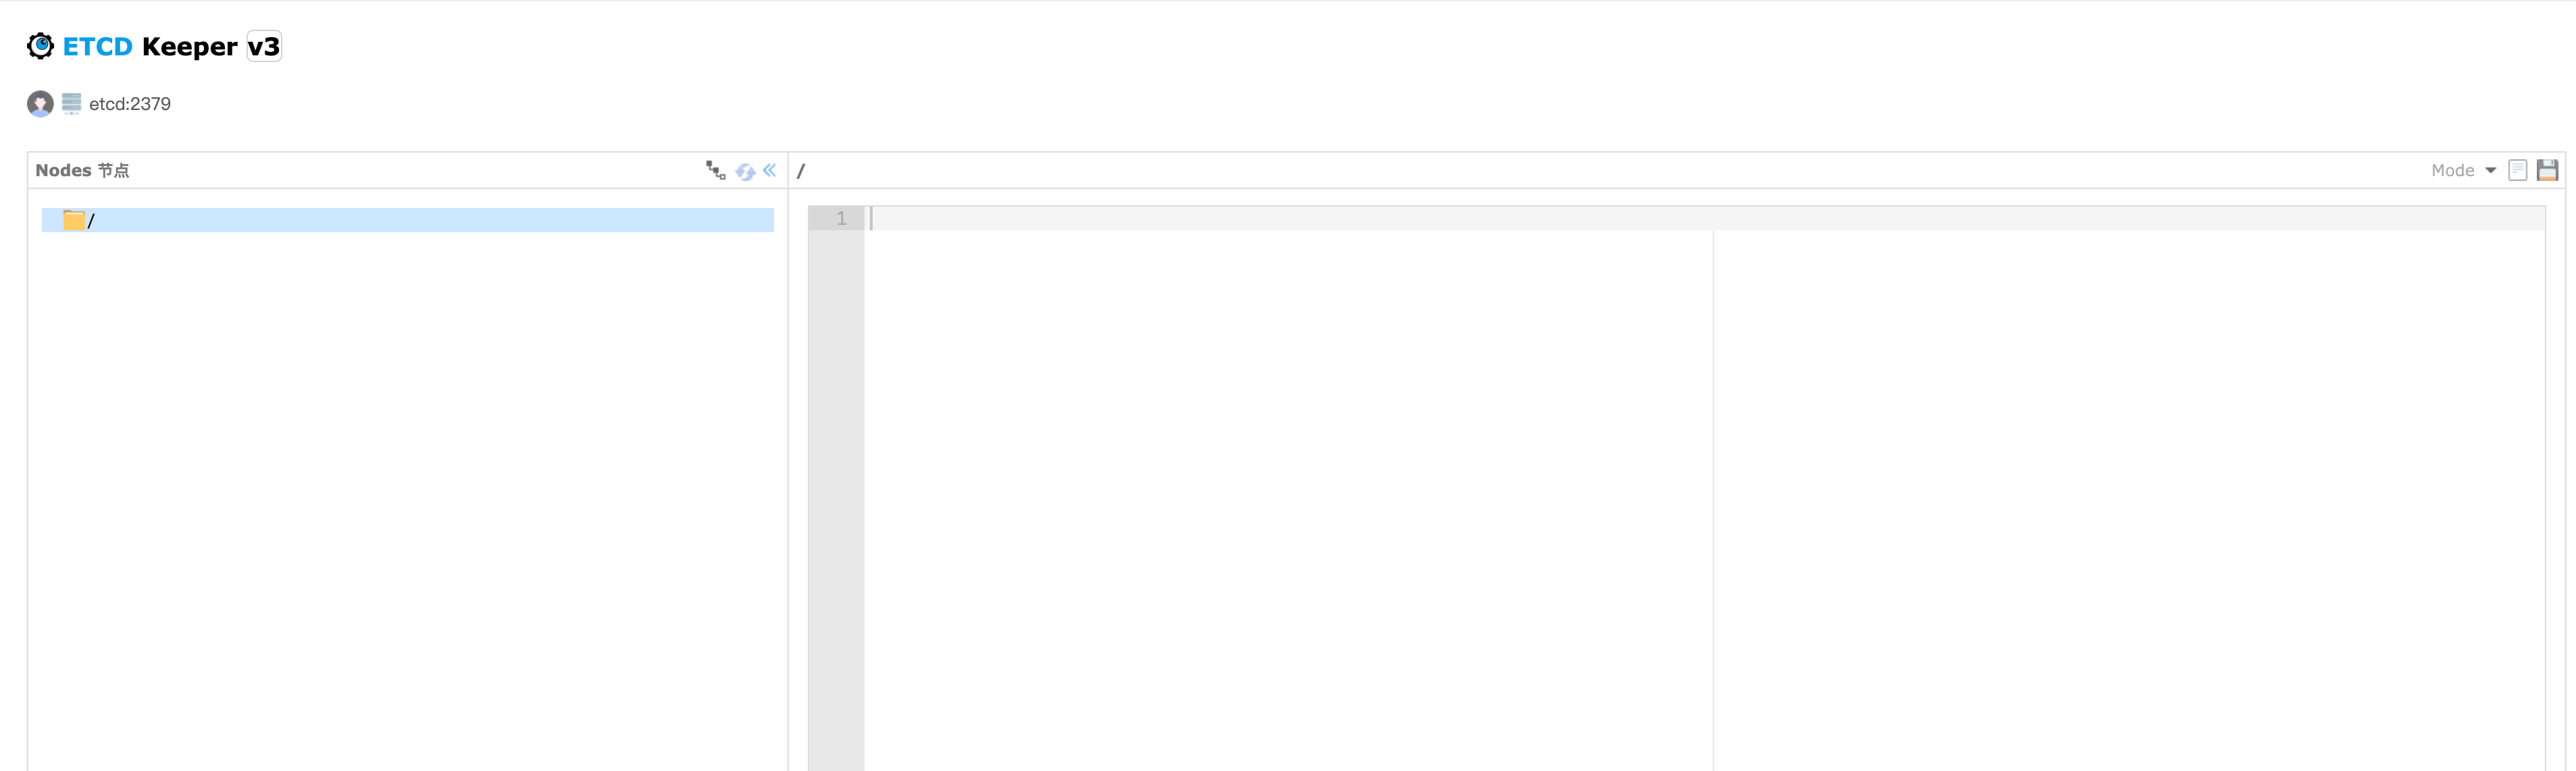 etcd
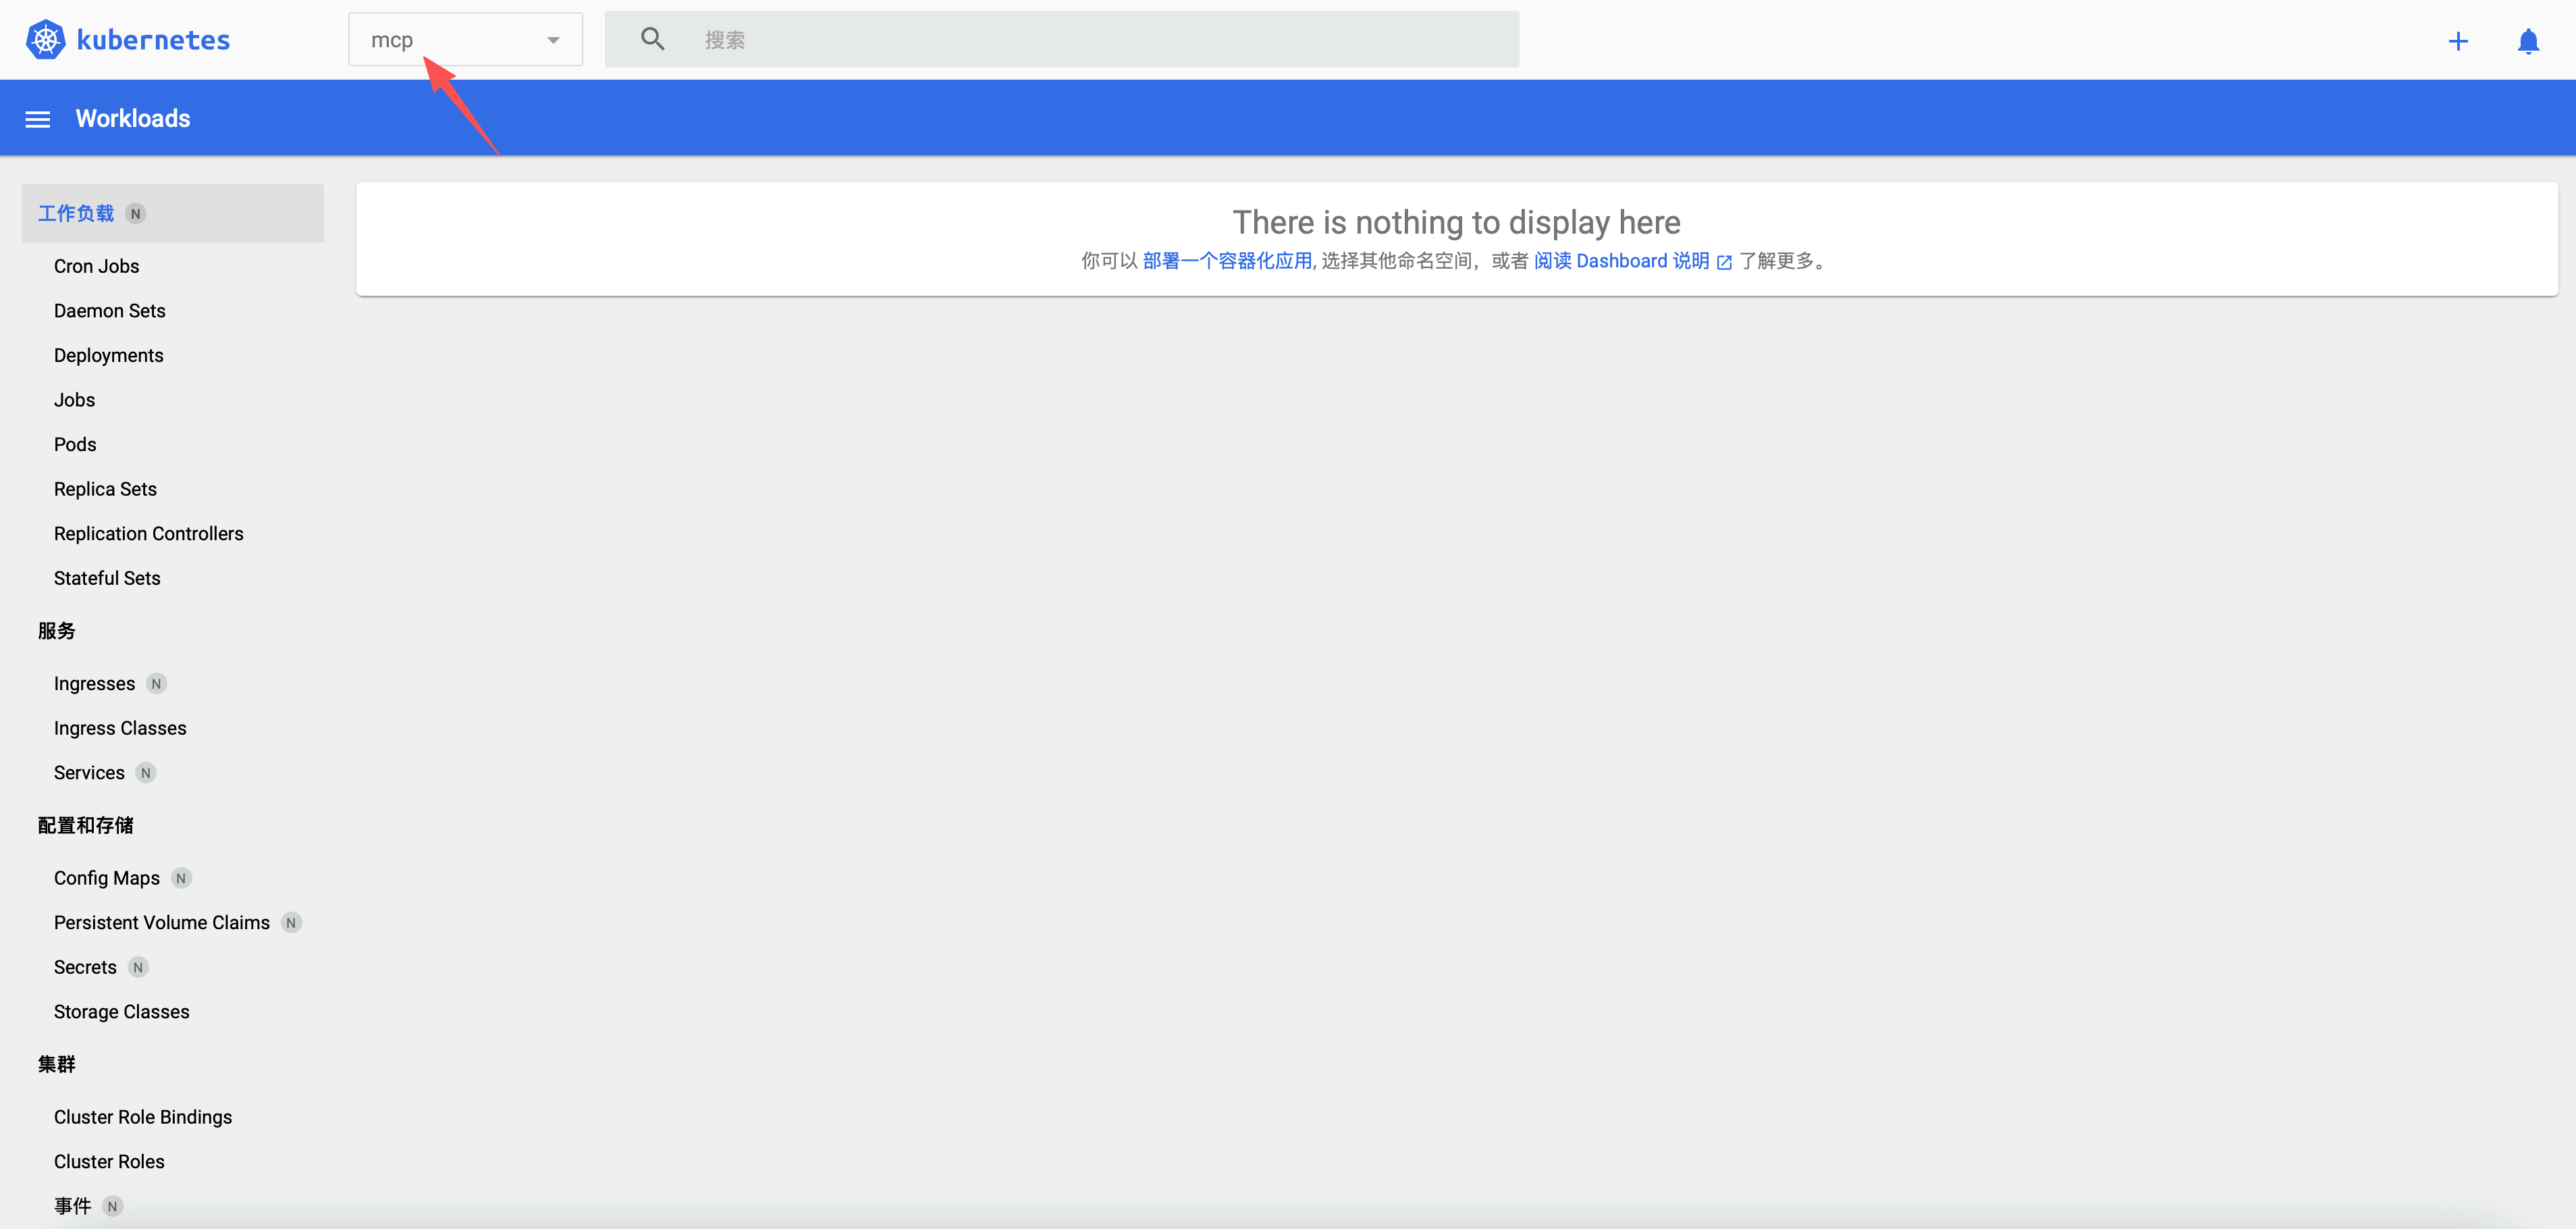 K8s
基础环境准备好之后,测试时就直接在本地启动mcp-client-gateway、mcp-manager、mcp-registry,
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
$ sh mcp_registry.sh
INFO[0000] start mcp registry
[GIN-debug] POST   /register                 --> mcp_manager/registry.Register (4 handlers)
[GIN-debug] DELETE /deregister/:serviceName/:version --> mcp_manager/registry.Deregister (4 handlers)
INFO[0000] http: starting web server at 0.0.0.0:10050

$ sh mcp_manager.sh
INFO[0000] start mcp manager
INFO[0000] etcd watch success
INFO[0000] register mysql db success,key=mcp_db
INFO[0000] http: starting web server at 0.0.0.0:8080

$ sh mcp_client_gateway.sh
INFO[0000] start mcp client manager
[GIN-debug] POST   /api/call_tool            --> mcp_manager/client.CallTool (4 handlers)
[GIN-debug] GET    /api/tools                --> mcp_manager/client.GetToolsList (4 handlers)
INFO[0000] http: starting web server at 0.0.0.0:8001
开始测试
在MCP网关成功起来之后,测试需要两步走,
- 发布测试使用的
MCP Server; - 搭建
Agent Loop业务端,跑通业务端 –>LLM–>mcp-client-gateway–>mcp-server,完成一次真实工具调用。
发布MCP Server
在网上找一个MCP Server,比如提供全面且精准的八字(中国命理)排盘与分析服务。
前置工作需要给它做一个可由manager发布的Streamable HTTP adapter,复用其八字计算能力、按本框架路由与注册约定运行,并补齐Docker构建与K8s发布所需配置,约定主要包括
POST /mcp/${SERVICE_NAME}/server;GET /mcp/${SERVICE_NAME}/health;- 启动后注册
mcp-registry,健康检查成功后由registry写入etcd; - 退出时注销服务;
getBaziDetail、getSolarTimes、getChineseCalendar三个工具。
本地构建并验证mcp/bazi-adapter:local镜像,
- 健康检查返回
200; MCP initialize成功;tools/list返回3个工具;getBaziDetail成功返回完整八字结果。
将mcp/bazi-adapter:local作为MCP Server发布到K8s。推送镜像,并调用/publish创建K8s资源。Manager会创建Deployment、Service、Ingress等K8s资源,并注入registry所需环境变量。
mcp/bazi-adapter:local导入K8s节点运行时;- 创建
mcp/bazi的Deployment、ClusterIP Service、Ingress; - 验证
Pod Ready:bazi-f9f487c74-qwmbf; - 路由:
http://127.0.0.1:18080/mcp/bazi/server; - 健康检查:
/mcp/bazi/health返回200; MCP initialize已成功;Manager已同步3个工具:getBaziDetail、getSolarTimes、getChineseCalendar;- 因为
MCP-Registry是在本地运行的,需要通过Traefik的18080转发进行健康检查;该转发需要保持运行,否则Registry会在连续健康检查失败后注销该实例。
发布成功后,K8s里边对应的资源如下,
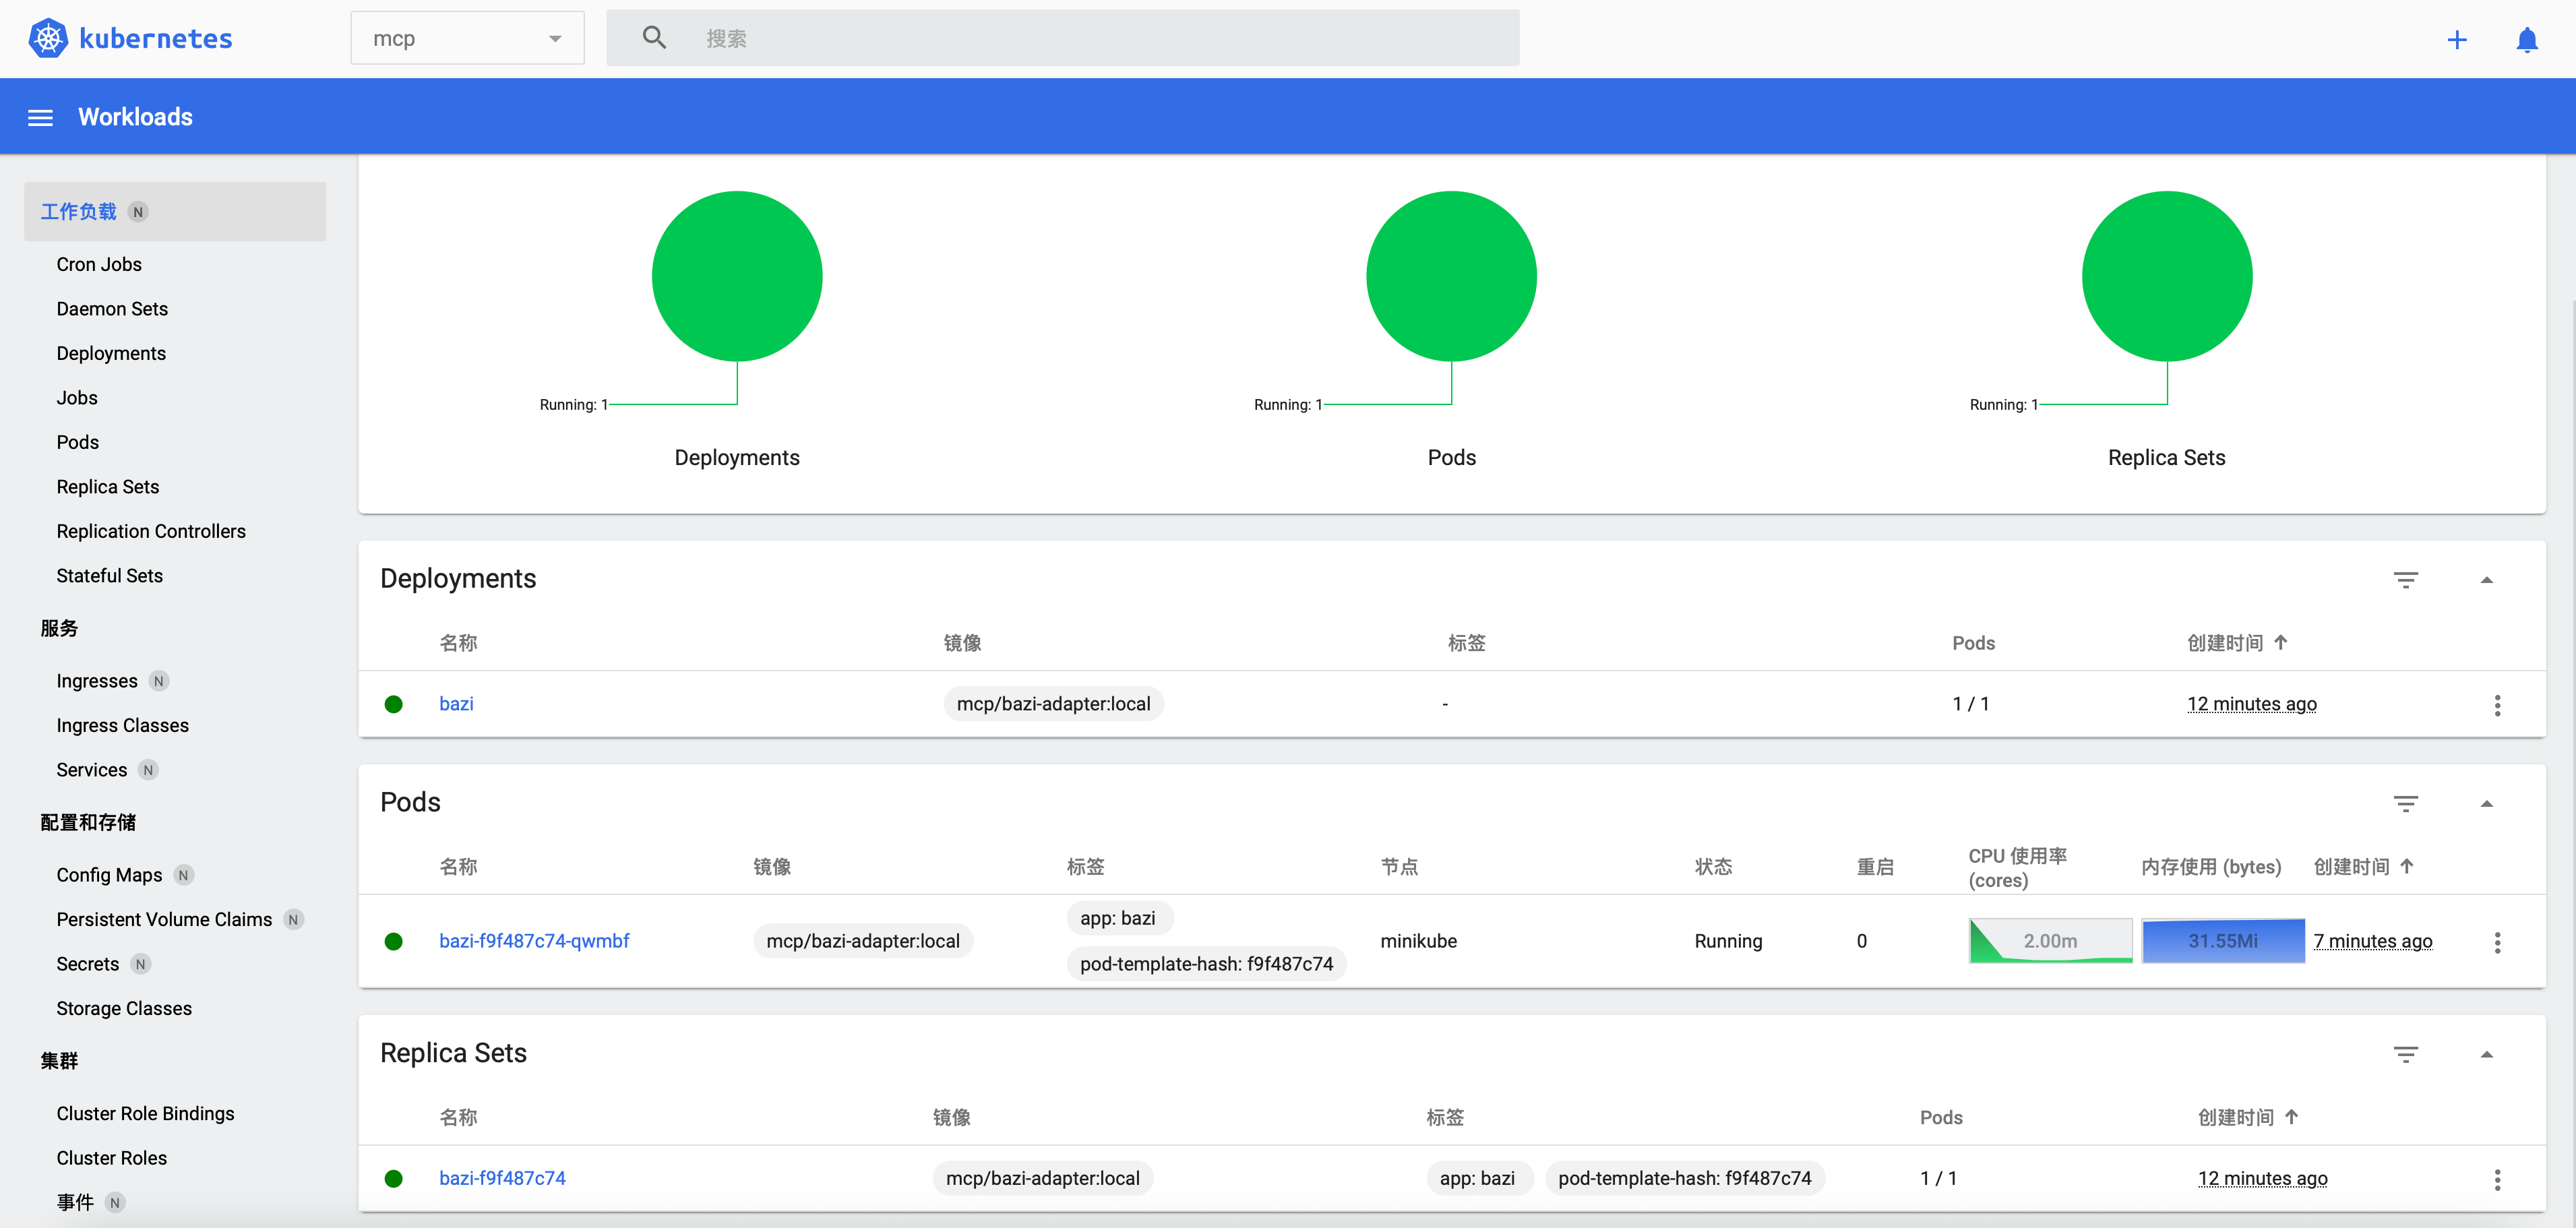 K8s里的资源
1
2
$ kubectl get pods -A | grep mcp
mcp                    bazi-f9f487c74-qwmbf                         1/1     Running   0              126m
健康检查成功后,etcd存入的上游数据如下,
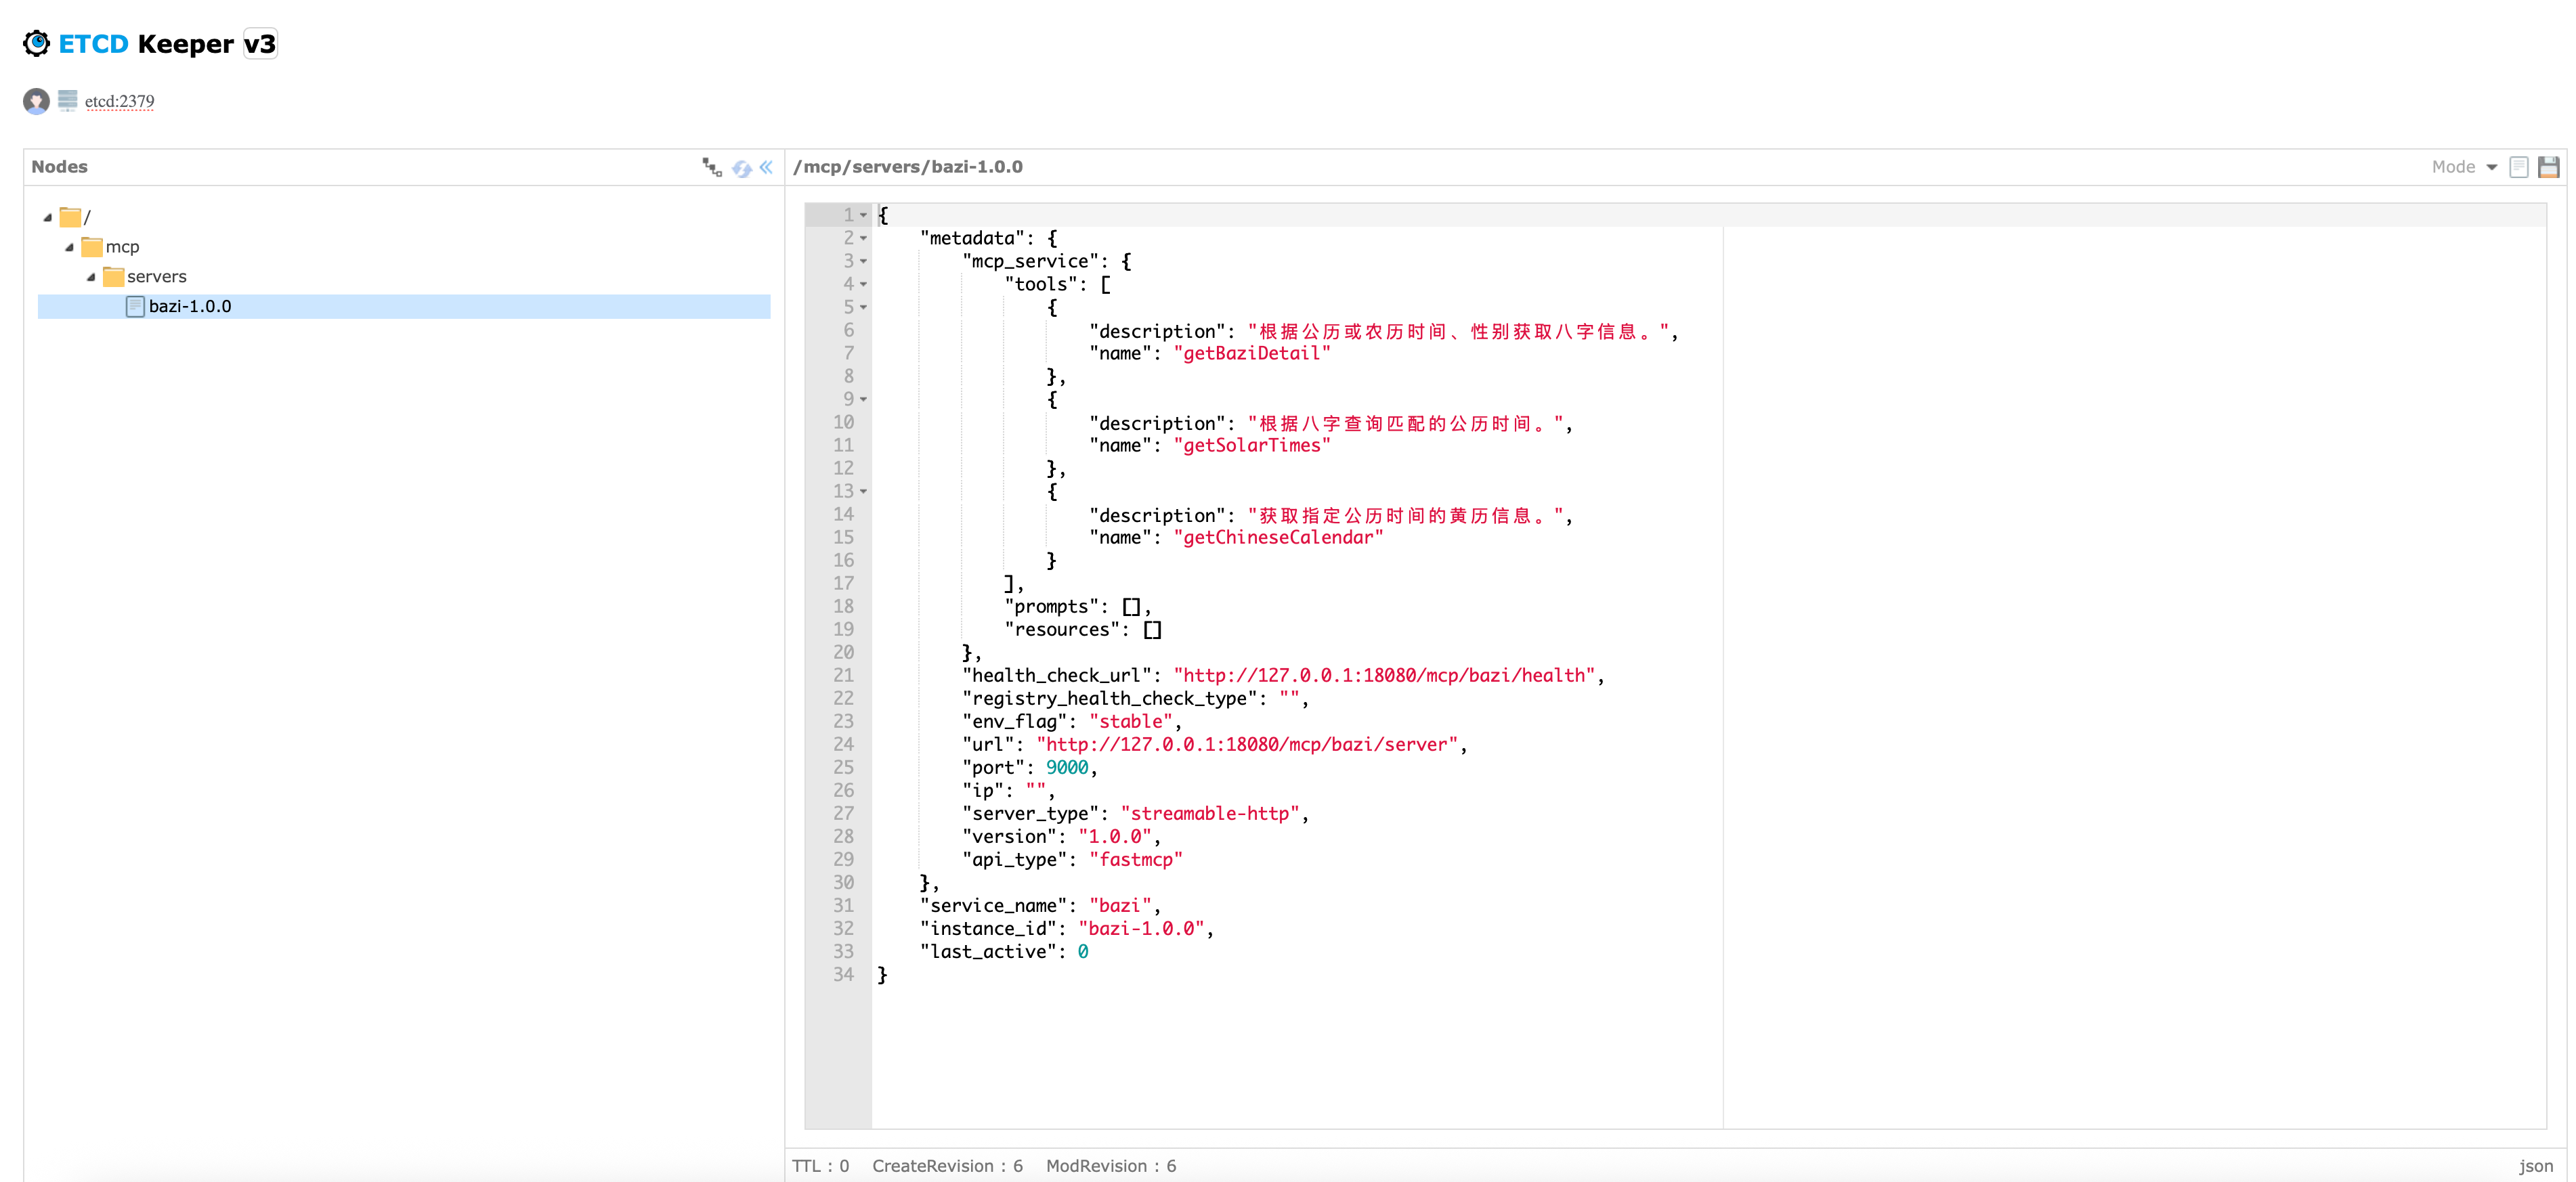 健康检查成功后etcd存入的上游数据
业务端在Agent Loop模式下测试整条链路
简单搭建一个Agent Loop模式的业务端,测试模型使用qwen3:4b,为了测试工具调用,这里使用的模型需要支持native tools。
想个问题,交给Agent Loop实现的业务端,比如,
1
查询2026-09-14T12:00:00+08:00的黄历,并用中文简短回答。
业务端 –> Ollama qwen3:4b –> mcp-client-gateway –> bazi mcp-server,完成一次真实工具调用,最后交由LLM整理输出,验证成功。
1
2
3
4
5
{
  "session_id": "bazi-e2e-captured",
  "answer": "2026年9月14日(星期一)农历八月初四,白露节气。宜祭祀、治病、破屋、坏垣;忌诸事不宜。冲鸡(酉),煞西。",
  "tool_calls": 1
}
mcp-client-gateway日志如下,
1
2
3
4
5
[GIN] 2026/09/14 - 13:28:10 | 200 |     338.208µs |       127.0.0.1 | GET      "/api/tools?env=stable"
INFO[5307] 准备调用工具: getChineseCalendar,服务端地址:http://127.0.0.1:18080/mcp/bazi/server
INFO[5307] 参数: map[solarDatetime:2026-09-14T12:00:00+08:00]
[GIN] 2026/09/14 - 13:29:25 | 200 |   18.933166ms |       127.0.0.1 | POST     "/api/call_tool"
INFO[5756] Successfully retrieved tools: [{bazi tool getBaziDetail 根据时间(公历或农历)、性别来获取八字信息。solarDatetime和lunarDatetime必须传且只传其中一个。 map[eightCharProviderSect:map[default:2 description:早晚子时配置。传1表示23:00-23:59日干支为明天,传2表示23:00-23:59日干支为当天。 type:number] gender:map[description:传0表示女性,传1表示男性。 type:number] lunarDatetime:map[description:农历时间。例如农历2000年5月初五中午12点整表示为:`2000-5-5 12:00:00`。 type:string] solarDatetime:map[description:用ISO时间格式表示的公历时间。例如:`2008-03-01T13:00:00+08:00`。 type:string]]} {bazi tool getSolarTimes 根据八字获取公历时间列表。返回的时间格式为:YYYY-MM-DD hh:mm:ss。 map[bazi:map[description:八字,按年柱、月柱、日柱、时柱顺序,用空格隔开。 type:string]]} {bazi tool getChineseCalendar 获取指定公历时间(默认今天)的黄历信息。 map[solarDatetime:map[description:用ISO时间格式表示的公历时间。 type:string]]}]
到这里其实可以发现,所有的业务服务,甚至互联网上的所有服务或者资源,都可以适配成
MCP Server,这些服务在安全访问和权限审计的前提下,可以任由LLM使用。
参考
关于agent的可视化理解,A Visual Guide to LLM Agents Exploring the main components of Single- and Multi-Agents
把stdio-based的MCP server转化为SSE远程Server
附录
什么是MCP?
2024年11月,Anthropic开源模型上下文协议(Model Context Protocol,MCP)。作为开放标准协议,旨在为LLM提供与外部数据源、工具及服务的安全、标准化连接方式。
MCP专注于构建安全且可解释的生成式AI系统。
MCP的诞生源于解决LLM应用的一个关键限制,即它们与外部数据源和工具的隔离问题。
LLM应用的一个核心关注点是数据传输,即如何将数据提供给LLM进行推理。
这一直是RAG和微调的目标,同时也是MCP的目标。
MCP的主要目的是标准化LLM应用如何连接到不同的系统。
拆解MCP的三个单词,
Model:各类AI模型,如Deepseek、GPT、Claude等;Context:提供给模型的额外资料或上下文;Protocol:一种通用标准或规范。
核心三件套
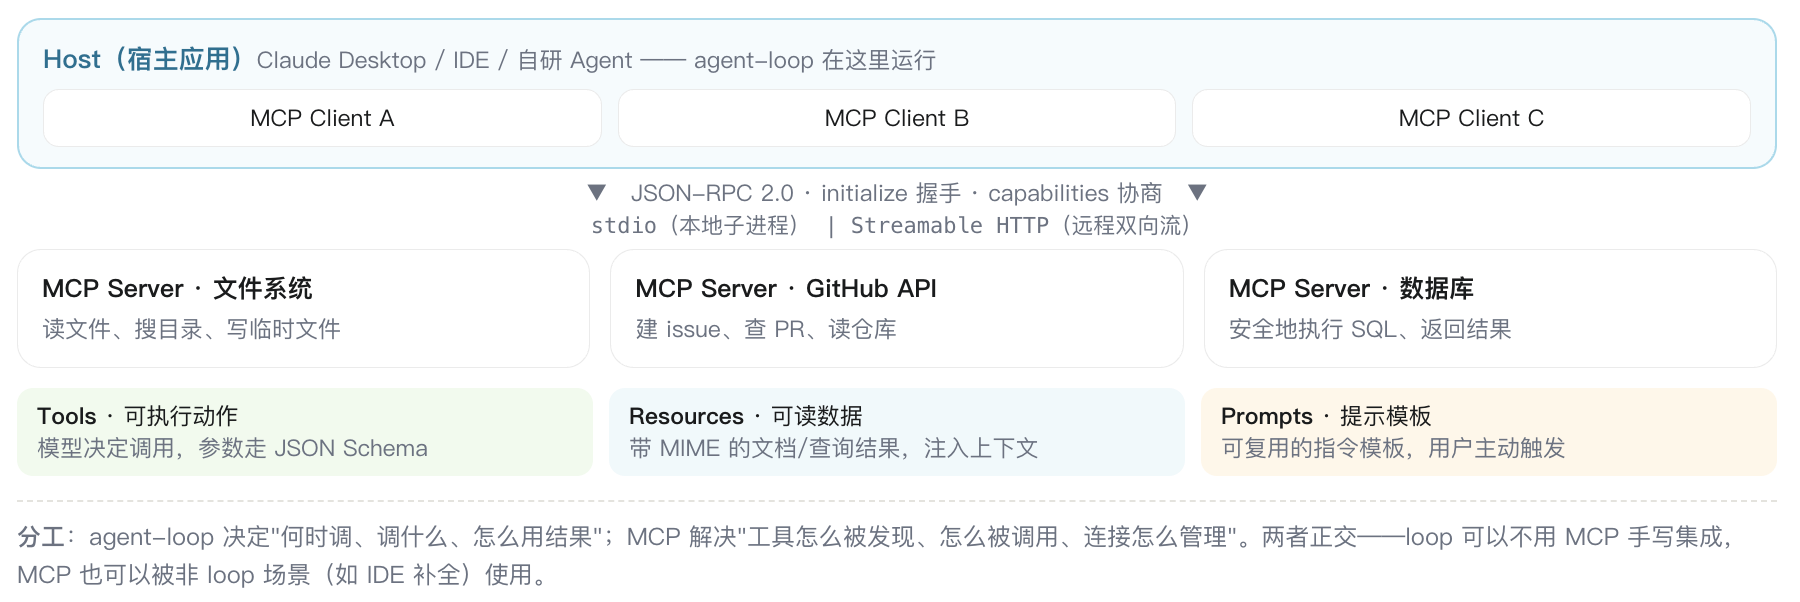
Tools:可执行动作(查询天气、创建issue、跑SQL)。对应Agent Loop里的tool_calls。模型输出函数名 +JSON参数,Host侧tools/call触发执行;Resources:可读数据(文件、数据库结果、文档片段),带MIME type,用于把上下文注入模型,而不是执行;Prompts:可复用提示模板(用户主动触发,不是模型调用)。
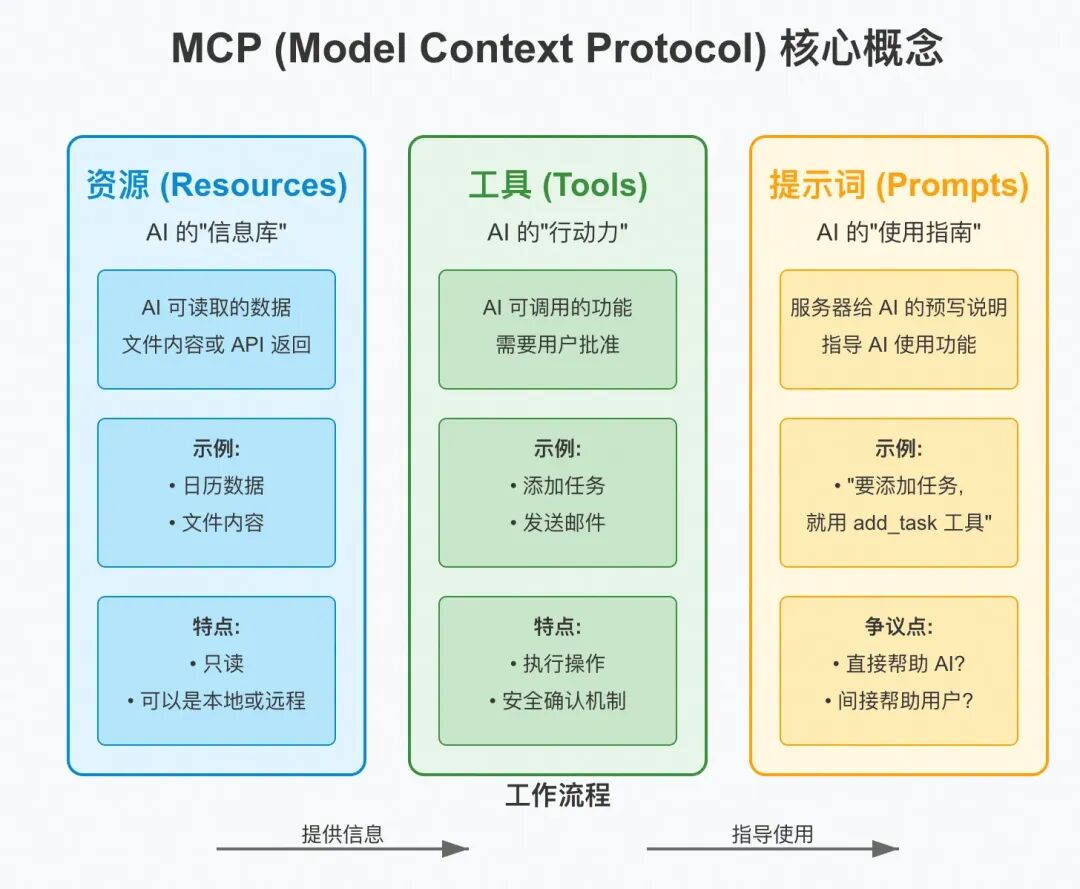 MCP核心三件套
协议要点与版本演进(截止202609)
- 消息:
JSON-RPC 2.0;核心方法initialize(版本 + 能力协商)–>tools/list/tools/call、resources/list|read、prompts/list|get,支持取消、进度通知; - 两种标准传输:
stdio(本地子进程,简单安全)和Streamable HTTP(远程,HTTP POST+ 可选SSE双向流,替代早期单向HTTP+SSE); - 版本线:
2024-11发布 –>2025-03-26/2025-06-18(现行稳定)–>2025-11-25次要修订 –>2026-07-28RC:协议最大一次修订——无状态核心(可在普通HTTP基础设施上横向扩展)、MCP Apps(服务器渲染UI)、Tasks扩展(长时任务)、授权对齐OAuth/OpenID Connect、正式弃用策略; - 治理:
2024-11Anthropic发起 –>2025-03OpenAI宣布采纳 –>2025-12捐赠给Linux基金会旗下新成立的Agentic AI Foundation(AAIF,Anthropic/Block/OpenAI联合创立,AWS/Google/Microsoft等白金会员)。2026年社区MCP Server超1万个,SDK月下载9700w+。
AgentLoop是MCP的业务层编排逻辑
Agent Loop是什么?
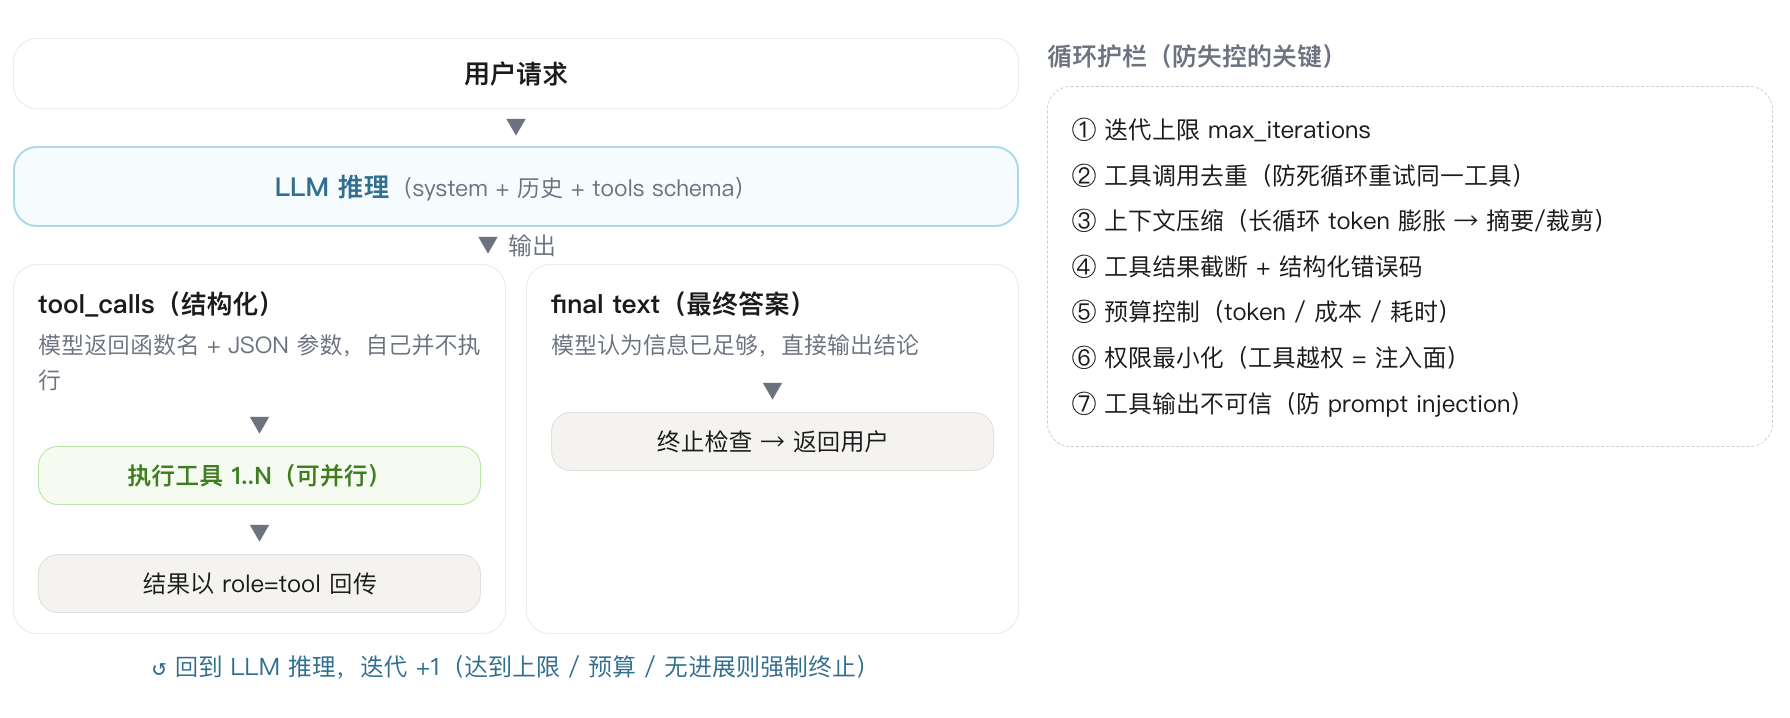
让LLM在思考 –> 行动 –> 观察之间反复闭环,模型决定要不要调工具、调哪个、传什么参数,你的代码执行工具,结果以tool消息喂回,模型据此继续推理,直到它给出最终答案。没有这个循环,LLM只是文本生成器;有了它,LLM才能查库、调API、操作文件,成为真正的Agent。
核心循环机制如下,
 Agent Loop核心循环机制
MCP是AI应用的Type-C接口,一套开放标准,让任何LLM应用(Host)用统一方式连接任何外部工具和数据源。它不替代Agent Loop,而是给Agent Loop提供工具接入层,loop负责推理编排,MCP负责把工具标准化地暴露出来。
 AgentLoop是MCP的业务层编排逻辑
在自研Agent里,MCP与Agent Loop的配合是,loop推理 –> 模型要调工具 –> Host把请求路由到对应MCP Client –> tools/call发给Server –> Server执行返回 –> 结果作为tool消息回传loop –> 模型继续。
区别在于,没有MCP时,每接一个工具你都要手写schema注册 + 调度 + 连接管理;有MCP后,tools/list自动发现、tools/call统一调用,加工具 = 加一个server进程/URL。
Loop协议层,循环靠消息角色闭环,OpenAI兼容协议(Ollama同款)里三种角色构成这个循环,
assistant消息可以携带tool_calls([{id, type, function:{name, arguments}}]),模型只宣布要调什么,不执行;- 你的代码执行后,用
role: "tool"消息回传结果,且必须带tool_call_id与assistant的调用一一对应; - 然后把整段历史(
tools schema每轮都要重新带上,模型不记忆工具定义)再发给模型。
需要注意的两个易错点,
- 忘了每轮带
tools(模型直接说不会调用); tool_call_id没对齐(API直接报错)。
常用的四种循环范式如下,
| 范式 | 机制 | 特点 | 代表 |
|---|---|---|---|
ReAct | 工具定义和思考都写在prompt,模型自由文本输出动作 | 不依赖原生tool calling,老模型可用;输出解析脆弱 | 早期LangChain |
Native tool-calling loop | 模型原生返回结构化tool_calls | 可靠、可并行、可流式,当前主流 | OpenAI/Claude/Ollama |
Plan-and-Execute | 先规划步骤再逐段执行、执行完复盘 | 长任务更稳,代价是多一轮规划推理 | LangGraph/手写planner |
Multi-agent编排 | 多个loop嵌套,orchestrator分派给worker | 复杂任务可拆解;状态一致性和成本难控 | OpenAI Swarm/AutoGen |
终止条件与失控防护非常关键,终止有四个出口:模型输出最终答案、达到max_iterations、预算超限(token/耗时)、用户中断。
典型失控场景和对应解法如下,
- 无限循环/反复调同一工具 –> 记录调用签名去重 + 上限;
- 上下文膨胀 –> 每轮压缩:只保留摘要和最近
N轮tool结果,工具输出截断到几百token; - 参数幻觉(模型编造参数)–>
JSON Schema校验,失败有限次重试; - 工具抛异常 –> 把异常作为
tool结果回传让模型自己修正(比直接abort更符合agent语义),但要限次; - 工具输出被污染(返回内容里夹带指令)–>
system prompt声明工具输出是不可信数据,敏感操作独立鉴权。
总结下Agent Loop常见的工程坑点,如下,
- 忘带
tools schema–> 模型不认识工具,直接答做不到; tool_call_id不对齐 –>API报错或结果丢失;- 工具输出不截断 –> 两三轮后
context爆炸; - 无迭代上限 –> 死循环烧
token; - 工具副作用不幂等 –> 重试导致重复下单/重复写库;
- 把工具输出当可信指令 –>
prompt injection; - 并行
tool_calls返回顺序错乱 –> 按id映射结果,别按数组下标; - 流式场景:
tool_calls走delta分片,要等finish_reason聚合完整再执行; - 长循环别裸堆全量消息 –> 用摘要/向量缓存历史;
- 本地小模型:
Q4量化 + 复杂schema容易参数乱填,先跑通单工具再上多工具。
MCP和AgentLoop小结
MCP是协议层,Agent Loop是编排层,别混为一谈;- 三件套:
Tools(执行)/Resources(读数据)/Prompts(模板); - 两传输:
stdio本地、Streamable HTTP远程(双向流); - 生命周期:
initialize握手协商capabilities后才允许调用; - 现状:已捐
Linux基金会AAIF,OpenAI/Google/Microsoft都是会员,行业事实标准; - 版本:稳定版
2025-06-18,2026-07-28 RC是最大修订(无状态核心 +Tasks+OAuth对齐); - 安全坑:
HTTP传输注意DNS rebinding和Origin校验;工具权限最小化;工具输出不可信(prompt injection面)。
MCP解决了什么问题?
MCP通过统一的接口设计,解决了传统AI Agent开发中数据孤岛、定制化集成复杂、平台依赖性强等问题,使开发者能够快速构建灵活且安全的Agent应用,让AI模型能够无缝对接外部资料。
国内用户比较熟悉的AI Agent应用开发平台,比如阿里云百炼、字节Coze扣子、Dify等,虽然或多或少都能够满足需求,但整体来说比较零散,缺乏统一标准,特别是都相对封闭,比如用扣子开发的Agent只能在运行在扣子上。
MCP的出现,解决了以下这些问题,
- 开放性:打破生态壁垒
MCP的核心设计理念是去中心化,基于开源协议构建标准化接口;- 开发者遵循
MCP协议开发的工具和Agent,可在任何兼容该协议的平台上无缝运行(如Claude、第三方定制平台等); - 相比之下,国内扣子、
Dify等平台采用封闭式架构,开发的Agent仅能在其自有生态内使用,形成技术锁定效应; - 例如,在扣子平台训练的
Agent无法直接迁移至其他LLM服务商环境,而基于MCP开发的Agent则能通过协议适配层快速接入不同平台。
- 数据主权:本地化优先原则
MCP通过本地化部署重新定义数据安全边界;- 所有
MCP服务器(如文件系统工具、数据库接口)默认运行在用户本地环境,敏感数据无需上传至云端即可完成处理; - 这种差异在金融、医疗等强监管领域尤为关键,
MCP的本地化特性天然符合合规要求。
- 扩展能力:模块化自由组合
MCP采用乐高式工具链设计,开发者可自由选择或自定义工具模块;- 例如,通过
GitHub上的开源MCP服务器库,开发者可直接集成PostgreSQL数据库工具或Slack消息接口,也可自行开发私有化工具(如企业ERP系统连接器); - 而传统
Agent开发平台通常仅提供官方预置的工具库(如限定搜索引擎、指定知识库),自定义开发需依赖平台审核,灵活性受限; - 扣子目前在这块上做的好点,并配合字节流量做相关生态打造工作,但如果能进一步融合
MCP打造更开放的平台,会具有更快的发展速度。
- 开发自由度:多模型兼容性
MCP协议本身与底层模型解耦,支持Claude、GPT、Gemini、Qwen、Deepseek等多种大模型的接入;- 开发者可根据场景需求切换模型引擎,甚至混合调用多个模型(如用
Deepseek处理创意生成,用Qwen处理逻辑分析)。
- 生态协作:社区驱动
vs平台主导MCP通过开源社区形成去中心化协作网络,任何开发者均可贡献工具实现方案,并通过协议标准化推动生态繁荣;- 例如,
Anthropic官方仅提供基础协议规范,而文件操作、浏览器自动化等具体功能均由社区开发者实现; - 而传统
AI Agent平台的工具链迭代完全由平台方主导,开发者只能被动使用官方更新功能,难以参与底层生态建设。
MCP通过协议层标准化实现了基础设施中立性,其价值类似HTTP协议之于互联网,任何遵守协议的参与者都能平等接入生态。而目前的扣子等平台更接近围墙花园,依赖中心化控制维持生态闭环,这种开放性差异直接决定了开发者的长期技术自主权与创新空间。当然,正因为MCP的开放性,以前的那些AI Agent应用开发平台未来也都能支持MCP协议,来实现彼此的兼容互通。
对于Agent来说,无所不在的互联网和本地服务本身就是一笔极大的财富。随着Agent的蓬勃发展,让Agent更安全、标准化地访问互联网和本地服务必然是大势所趋。
MCP与Function Calling对比
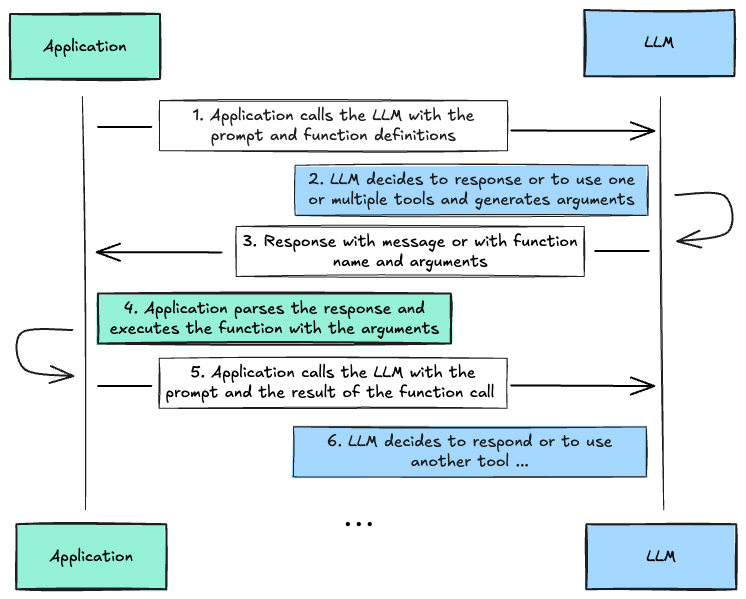
在MCP之前,每个工具/系统都要单独写Function Calling描述。Function Calling是指LLM根据上下文自动执行函数的机制,充当LLM与外部系统之间的桥梁,不同的模型有不同的Function Calling实现,各家大模型会根据不同的Functions名、功能描述、参数训练自己的模型,调用方式和代码集成的方式也不一样,这些都由不同的LLM平台来定义和实现。虽然逻辑一样,但实现方式各自为阵,比如OpenAI和Google Gemini就不一样。
 Function calling(来自网络)
结合获取天气信息为例,Function Calling的步骤如下,
- 应用程序问
LLM今天某个城市的天气情况,同时告诉LLM可用的工具有哪些,每个工具的名称、功能描述、需传入的参数,工具集合中包含可获取天气预报的接口; - 大模型根据收到的提示词和可用工具集合,决定使用哪个或哪些工具、以及对应的参数,比如天气工具名
get_weather(),参数北京; - 大模型把需要调用的工具和参数告诉应用程序;
- 应用程序根据收到的信息,使用需要的参数调用对应的工具;
- 应用程序把工具调用获得的结果,加上之前的提示词一起给大模型,工具调用结果类似
{'temperature':'15度', 'wind':'东南风1级'}; - 大模型融合提示词和工具调用结果的输入,计算输出最终结果,北京今天温度
15度,东南风1级。
Function calling让开发者自由定义函数及调用方式,虽然灵活,但当不同开发者采用不同方式时,就会出现无法通用的问题,导致普及困难且需要重复开发。应用程序方如果切换不同大模型,需要做适配,很麻烦,这就迫切需要一个统一标准化的协议,MCP开始逐渐成为主流。
API关注的是数据的传输,而非数据的含义。如果问下周一北京天气怎么样?像这样的数据,API没法接受,因为它不理解、也不需要理解这是什么意思。它的职责就是把数据拿过来、传过去。MCP会把一切都打包好,给到大模型去理解,MCP把用户的查询、工具的描述和参数,以结构化的方式传递给大模型,由大模型决定如何处理。
MCP的边界与局限
MCP最容易被误用的地方,不是协议本身,而是把工具接入层写成了业务大脑。
MCP不是唯一协议:还有其他Agent工具协议共存,MCP只是其中影响力很大的一个标准;- 不是所有服务都适合
Agent调用:纯沉浸式内容消费(看电影、刷短视频),主体仍然是人; Agent能力有上限:复杂业务编排、异常兜底仍然薄弱,大量场景仍然需要人作为主调用方。
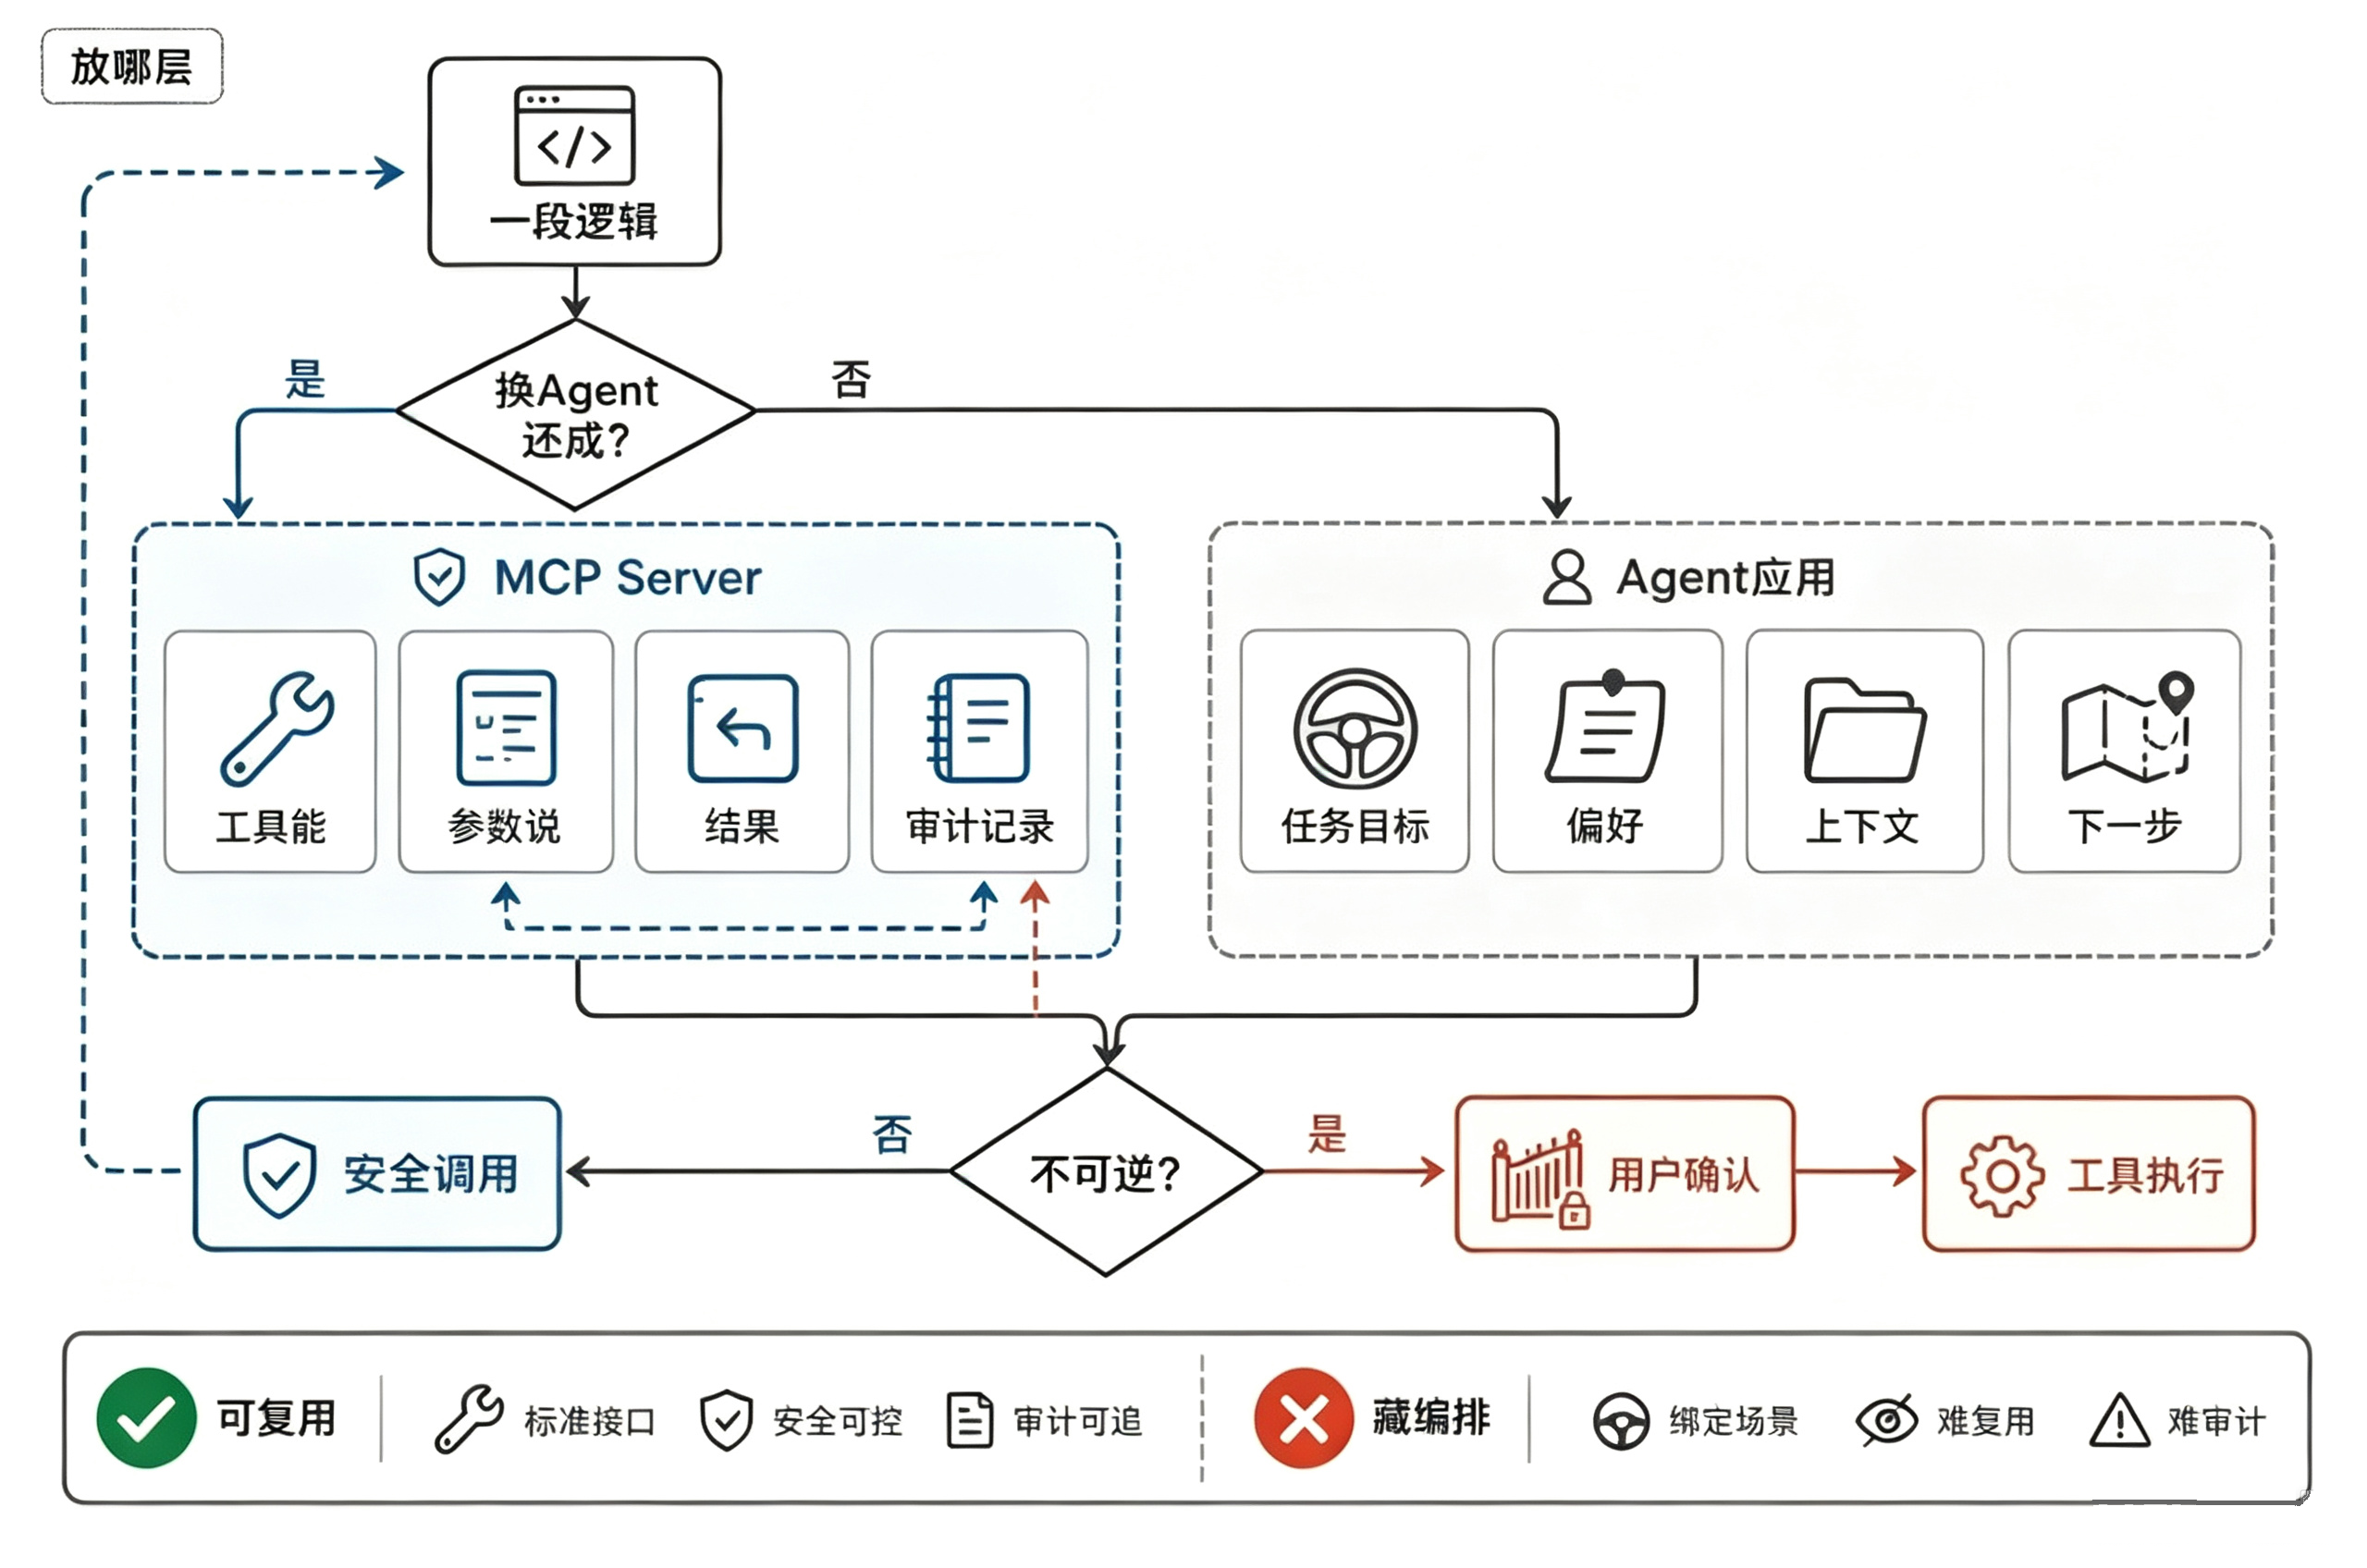
Agent负责目标和判断,MCP Server只做工具适配;高风险动作要在调用前显式确认。
Agent应用是驾驶员。它决定目标、拆任务、读上下文、判断什么时候调用工具。MCP Server不应该替它做规划;MCP Server是插座。它把GitHub、数据库、浏览器、内部系统包装成统一工具,让Agent能安全、可描述、可审计地调用;- 权限边界要前移。凡是删除数据、发消息、下单、改配置这类不可逆动作,都要在
Agent或产品层做确认,而不是藏在Server里自动执行。
MCP什么时候用?
如果团队只有一个 Agent、三五个内部工具,直接写函数调用也能跑。
MCP的价值出现在另一个阶段:工具越来越多,Agent不止一个,工具还要被IDE、桌面客户端、自动化流程复用。
这时,把工具做成MCP Server,就像把散落的充电线换成标准插座。
但标准插座不等于智能家居中枢,一个健康的MCP Server,应该更像能力适配器,而不是业务编排器。它回答三个问题:有什么工具,参数怎么传,结果怎么返回。
它不应该偷偷决定:下一步做什么、哪些信息重要、用户到底想要什么。
MCP Server设计的核心校验清单,如下,
| 检查项 | 好设计 | 风险设计 |
|---|---|---|
| 职责 | 暴露清晰工具能力 | 在Server内写复杂Agent逻辑 |
| 状态 | 短状态、可重试 | 保存大量会话记忆 |
| 权限 | 高风险操作显式确认 | 工具调用后直接执行不可逆动作 |
| 输出 | 结构化、可解释 | 返回一大段不可控文本 |
| 错误 | 明确错误码和恢复建议 | 只返回失败了 |
| 复用 | 多个Agent可共享 | 只服务某个提示词流程 |
| 审计 | 记录工具名、参数、结果摘要 | 调用链不可追踪 |
最简单的判断方法,如果这段逻辑再换一个Agent后仍然成立,适合放进MCP Server。如果它依赖当前任务目标、用户偏好、上下文取舍,就应该留在Agent应用层。MCP不是让工具变聪明,它是让工具变得可连接、可控、可复用。
 MCP判断边界的关键问题
Streamable HTTP(MCP新传输)
MCP Streamable HTTP = 以标准HTTP作为基础载体,默认短请求;有流式输出需求时,可动态升级为SSE长连接,不再强制全程保持长连接。
SSE像一直挂着的电话长连线;Streamable HTTP是普通HTTP请求,按需可升级流式,不强制长连接。
- 旧
SSE方式:你拨通电话,必须一直保持通话在线,一旦掉线整个对话中断,运营商(负载均衡)很难调度;Streamable HTTP:像发消息。
- 简单提问:发一条消息,等对方一次性回复,消息发完连接就关掉;
- 大任务流式输出:发消息之后,可以临时切成语音通话(
SSE),一边处理一边实时推送内容;任务结束挂断。- 不用一直挂着通话,普通
HTTP服务器就能承接,云函数、CDN、负载均衡都能正常调度。
和传统SSE传输对比,如下,
| 特性 | MCP over SSE(旧) | MCP Streamable HTTP(新) |
|---|---|---|
| 连接模型 | 强制长连接,客户端一开始就要建立SSE,连接断了会话就断 | 默认短HTTP请求;按需升级SSE做流式,连接断开不丢失会话状态(支持无状态) |
| 部署限制 | 平台必须支持长连接;Serverless(Lambda/Vercel/Cloudflare)很难跑 | 普通HTTP服务即可,完美适配Serverless、FaaS |
网关/CDN/LB | 长连接对LB、CDN不友好,会话粘性要求高,缓存基本不可用 | 原生HTTP,可被负载均衡、CDN、API网关正常代理、缓存 |
| 服务状态 | 服务实例需要持有客户端会话(有状态) | 可选无状态,会话信息放请求参数/Header,请求之间不需要固定实例 |
| 通信模式 | 单向SSE下行,客户端只能通过单独POST接口发请求 | 同一个HTTP端点:短请求一次性返回;需要流式就升级SSE双向流式 |
核心原理简述如下,
- 客户端发起普通
HTTP POST请求,发送MCP消息(initialize/tools/call) - 两种分支:
- 普通场景:服务一次性处理完,直接返回完整
JSON响应 –> 短请求,连接马上关闭; - 流式场景(工具需要持续输出日志/流式结果):服务返回
text/event-stream,动态升级成SSE长连接,持续推送事件。
- 普通场景:服务一次性处理完,直接返回完整
- 关键:不是必须
SSE。长连接只是可选项,不是前提。
带来的收益
MCP Server实现门槛降低 不用专门维护SSE连接管理、心跳、断线重连逻辑。随便一个HTTP框架(Go net/http、FastAPI、Node Express)就能实现MCP服务。- 适配
Serverless/FaaS平台Lambda、Cloudflare Worker、Vercel Edge Function这类平台不支持常驻长连接,传统SSE MCP跑起来很别扭;Streamable HTTP短请求模式刚好契合函数请求到来才启动,处理完销毁的模型。 - 和云原生网关、
LB、CDN天然兼容SSE长连接容易出现负载均衡粘滞、超时断开问题。Streamable HTTP底层是标准HTTP,APISIX、Nginx、Ingress、CDN都可以直接代理,方便做限流、鉴权、缓存、灰度发布。 - 扩展性大幅提升,支持分布式
MCP集群- 无状态模式:请求自带会话标识,任意实例都能处理请求,不需要会话绑定固定
Pod; - 可以横向扩容
MCP Server实例,客户端请求可以打到不同节点; - 长连接仅在需要流式输出时临时启用,降低服务器资源开销。
- 无状态模式:请求自带会话标识,任意实例都能处理请求,不需要会话绑定固定
Streamable HTTP==抛弃SSE?不是抛弃,按需启用SSE。底层协议协商,不需要流式就不用。
Streamable HTTP完全没有长连接?有,只是可选,不是强制。工具流式输出场景依然会升级SSE。
换成
Streamable HTTP后,MCP变成纯HTTP无状态?可选无状态,服务端依然可以选择保留会话状态,看业务设计。